Artificial Intelligence
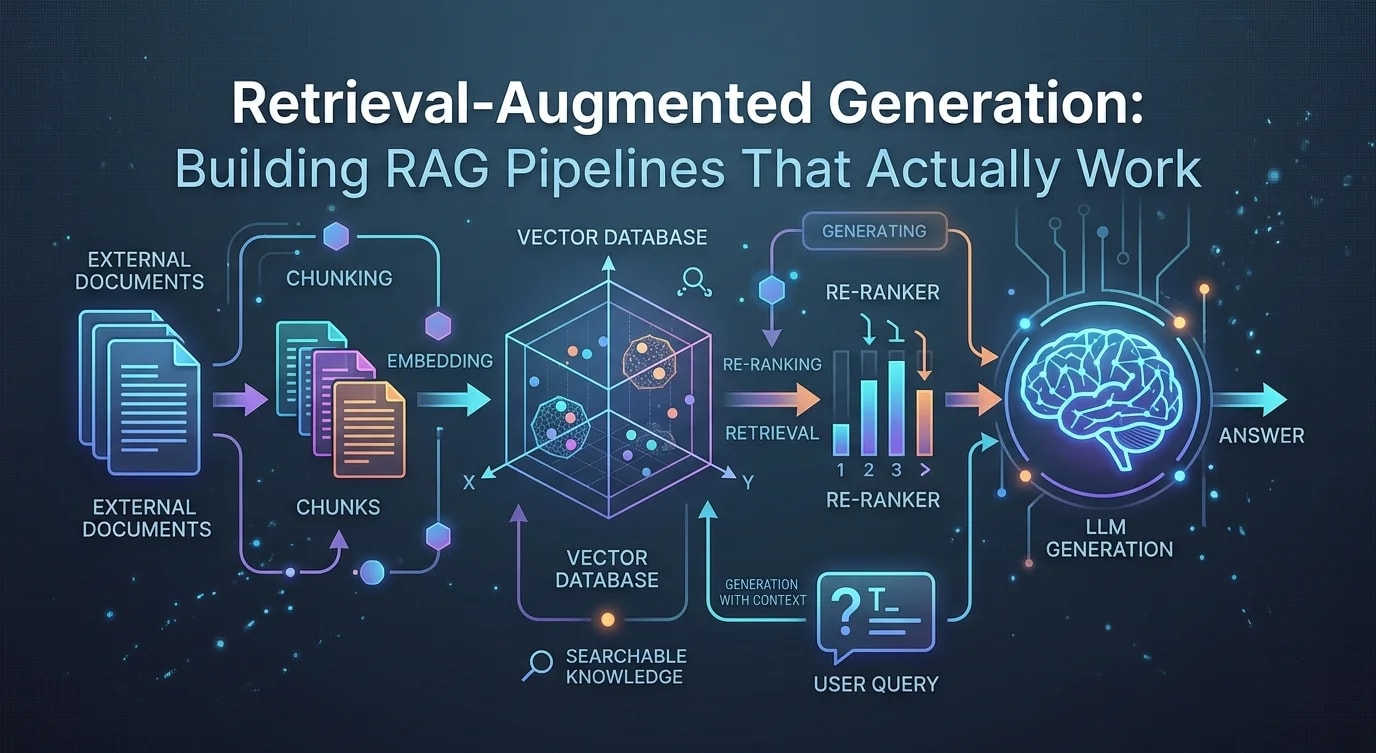
Production RAG: From Retrieval to Accurate Answers
Build production RAG pipelines that retrieve real context and answer accurately: chunking, embedding models, vector search, re-ranking and evaluation.
·4 min read
Tags
8 articles
Build production RAG pipelines that retrieve real context and answer accurately: chunking, embedding models, vector search, re-ranking and evaluation.

A practical guide to production RAG that returns grounded answers: embedding strategies, vector database choice, chunking, reranking and evaluation.
A hands-on guide to reliable RAG systems: chunking strategies, embedding models, vector stores and the retrieval patterns that separate demos from production.

Build effective RAG pipelines in TypeScript: document chunking, embeddings, vector search tuning, prompt construction and retrieval-quality evaluation.
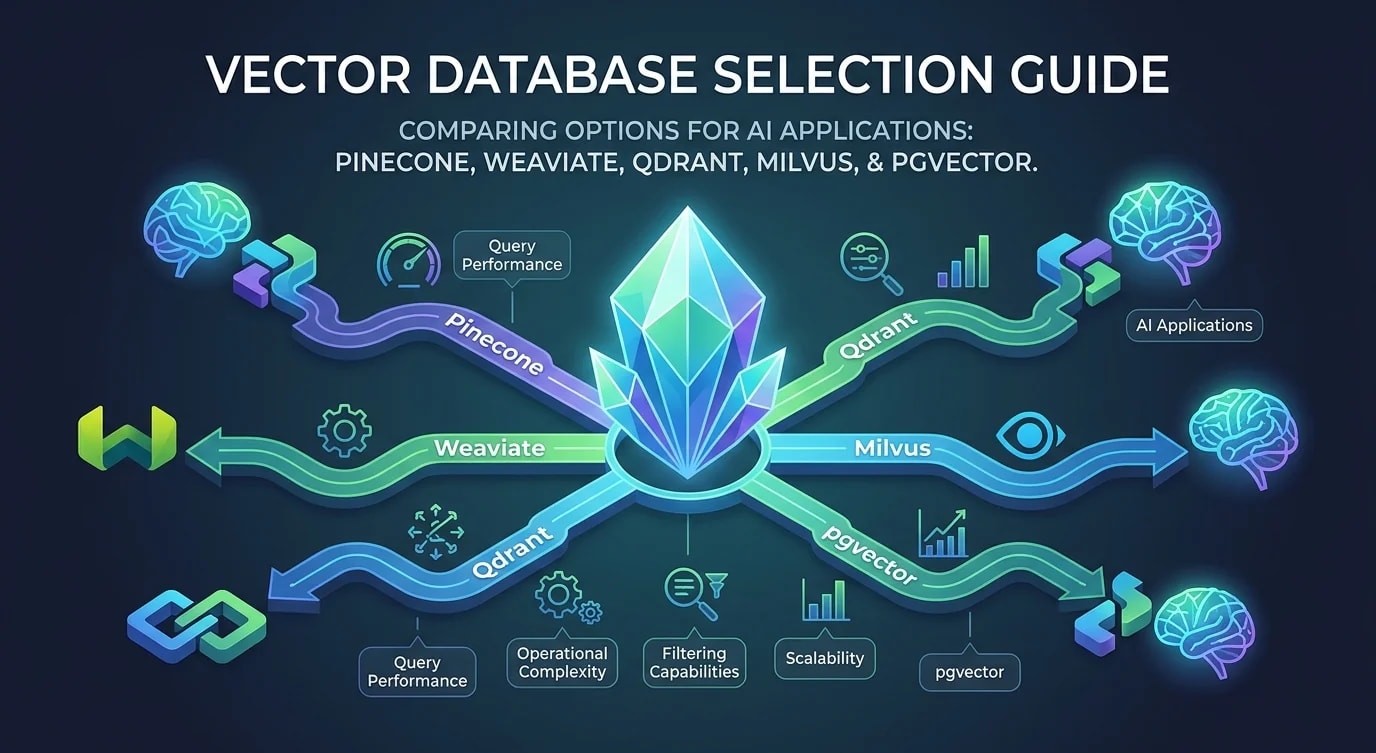
Compare Pinecone, Weaviate, Qdrant, Milvus and pgvector for AI applications: indexing strategies, query performance, filtering and operational complexity.

Design retrieval-augmented generation pipelines that go beyond demos: chunking strategies, embedding optimization, reranking and evaluation metrics.

A practical guide to vector databases for similarity search: embeddings, indexing strategies, distance metrics, and choosing between the main options.

How to build production-ready NLP pipelines: text preprocessing, tokenization, embeddings, classification and entity extraction in TypeScript and Python.