Künstliche Intelligenz
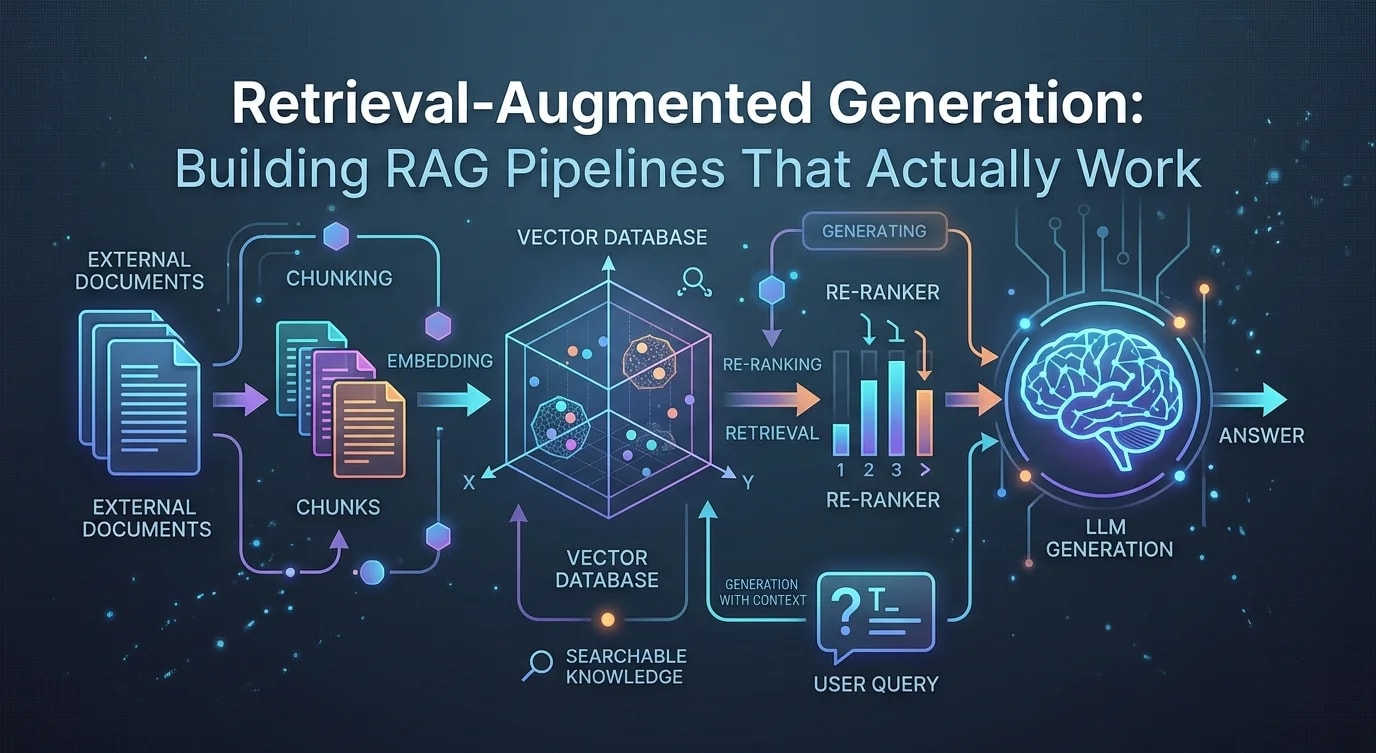
RAG in Produktion: Vom Retrieval zur präzisen Antwort
Baue produktionsreife RAG-Pipelines, die echten Kontext abrufen und präzise antworten: Chunking, Embeddings, Vektorsuche, Re-Ranking, Evaluation.
·4 Min. Lesezeit
Tags
8 Artikel
Baue produktionsreife RAG-Pipelines, die echten Kontext abrufen und präzise antworten: Chunking, Embeddings, Vektorsuche, Re-Ranking, Evaluation.

Praktischer Leitfaden für produktive RAG-Systeme mit fundierten Antworten: Embeddings, Vektordatenbank, Chunking, Reranking und Evaluierung.
Praxisnaher Leitfaden für zuverlässige RAG-Systeme: Chunking, Embedding-Modelle, Vektordatenbanken und die Retrieval-Muster jenseits des Prototyps.

Baue effektive RAG-Pipelines mit TypeScript: Chunking, Embeddings, Feintuning der Vektorsuche, Prompt-Konstruktion und Evaluation der Retrieval-Qualität.
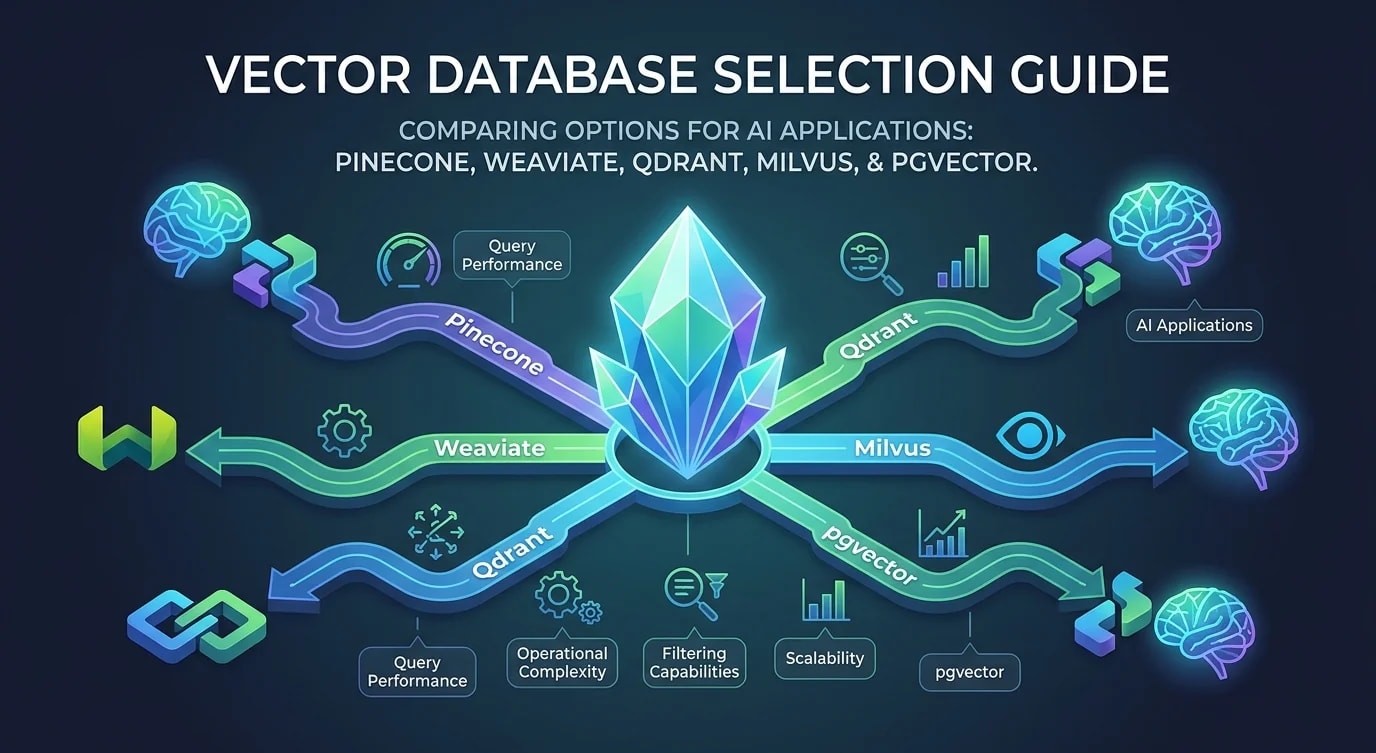
Vergleich von Pinecone, Weaviate, Qdrant, Milvus und pgvector für KI-Anwendungen: Indexierung, Abfrageleistung, Filterung, Betriebskomplexität.

Entwirf RAG-Pipelines jenseits einfacher Demos: Chunking-Strategien, Embedding-Optimierung, Reranking und Evaluationsmetriken für die Produktion.

Praktischer Leitfaden zu Vektordatenbanken für Ähnlichkeitssuche: Embeddings, Indexierungsstrategien, Distanzmetriken und die Wahl des Systems.

Wie man produktionsreife NLP-Pipelines baut: Textvorverarbeitung, Tokenisierung, Embeddings, Klassifikation und Entitätsextraktion.