RAG-Pipelines bauen, die wirklich funktionieren
Praxisnaher Leitfaden für zuverlässige RAG-Systeme: Chunking, Embedding-Modelle, Vektordatenbanken und die Retrieval-Muster jenseits des Prototyps.
Die Lücke zwischen RAG-Demos und RAG in der Produktion
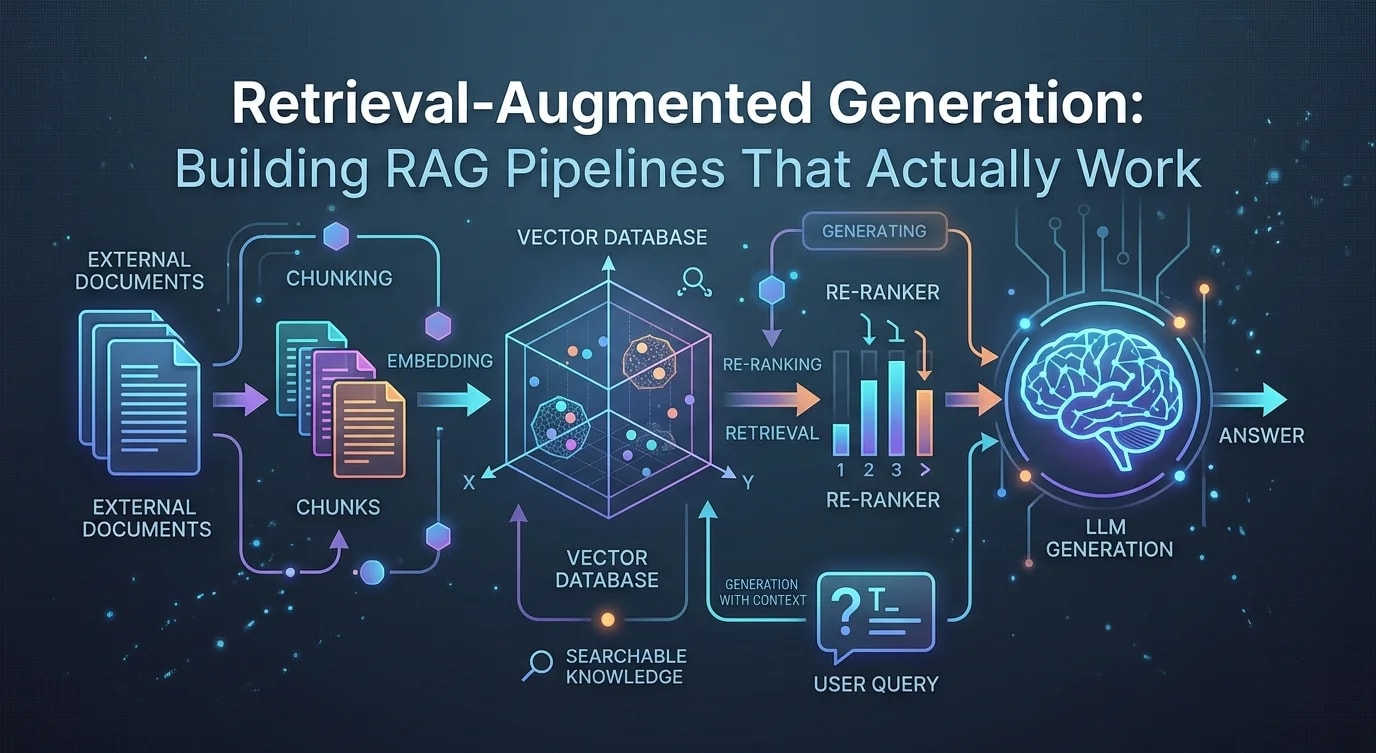
Jedes RAG-Tutorial folgt demselben Drehbuch: Dokumente laden, aufteilen, einbetten, in einer Vektordatenbank speichern, bei der Anfrage abrufen und einem LLM übergeben. Die Demo funktioniert. Man stellt eine Frage, das Modell zitiert die eigenen Dokumente, und es wirkt wie Magie.
Dann bringt man sie mit echten Daten in Produktion. Das Modell halluziniert Antworten, die plausibel klingen, aber in den Dokumenten nirgends stehen. Es ruft irrelevante Chunks ab. Es übersieht offensichtliche Antworten, weil der relevante Text auf zwei Chunks aufgeteilt war. Die magische Demo fällt in sich zusammen.
Der Unterschied zwischen einem funktionierenden RAG-Prototyp und einem produktionsreifen RAG-System steckt in den Details: wie die Chunks geschnitten werden, was eingebettet wird, wie abgerufen wird und wie die Ausgabe verifiziert wird. Dieser Leitfaden behandelt jede dieser Ebenen.
Chunking: Die Grundlage, die alle falsch machen
Chunking ist der am meisten unterschätzte Schritt in der RAG-Pipeline. Die meisten Tutorials verwenden eine Aufteilung nach fester Zeichenanzahl und machen weiter. Aber die Qualität der Chunks bestimmt direkt die Qualität des Retrievals, und die wiederum bestimmt die Qualität der Antwort.
# ❌ Bad: Fixed-size splitting ignores document structure
from langchain.text_splitter import CharacterTextSplitter

splitter = CharacterTextSplitter(
    chunk_size=1000,
    chunk_overlap=0,  # No overlap means lost context at boundaries
    separator="\n"
)
chunks = splitter.split_text(document)# ✅ Good: Recursive splitting with overlap and metadata preservation
from langchain.text_splitter import RecursiveCharacterTextSplitter
splitter = RecursiveCharacterTextSplitter(
chunk_size=512,
chunk_overlap=64,
separators=["\n\n", "\n", ". ", " ", ""],
length_function=len,
)
def chunk_with_metadata(
text: str,
source: str,
doc_type: str
) -> list[dict]:
chunks = splitter.split_text(text)
return [
{
"text": chunk,
"metadata": {
"source": source,
"doc_type": doc_type,
"chunk_index": i,
"total_chunks": len(chunks),
},
}
for i, chunk in enumerate(chunks)
]Der rekursive Splitter versucht zunächst, an Absatzgrenzen zu teilen, dann an Satzgrenzen und schließlich an Wortgrenzen. Das erhält die semantische Kohärenz innerhalb der Chunks. Die Überlappung von 64 Zeichen sorgt dafür, dass Sätze, die genau auf einer Chunk-Grenze liegen, in beiden Chunks erscheinen.
Die Chunk-Größe spielt eine größere Rolle, als den meisten bewusst ist. Kleinere Chunks (256-512 Tokens) liefern präziseres Retrieval, verlieren aber Kontext. Größere Chunks (1024-2048 Tokens) behalten den Kontext, verwässern aber die Relevanz-Scores. Der optimale Punkt hängt von den eigenen Abfragemustern ab.
Embedding-Strategie: mehr als nur die Standardmodelle
Das Embedding-Modell ist die Antriebseinheit für das Retrieval. Es wandelt Text in dichte Vektoren um, die die semantische Bedeutung erfassen. Die Qualität dieser Vektoren entscheidet darüber, ob relevante Chunks im Vektorraum nah an der Anfrage landen.
from openai import OpenAI
import numpy as np

client = OpenAI()

def embed_texts(texts: list[str], model: str = "text-embedding-3-small") -> list[list[float]]:
    response = client.embeddings.create(
        input=texts,
        model=model,
    )
    return [item.embedding for item in response.data]


def cosine_similarity(a: list[float], b: list[float]) -> float:
    a_arr = np.array(a)
    b_arr = np.array(b)
    return float(np.dot(a_arr, b_arr) / (np.linalg.norm(a_arr) * np.linalg.norm(b_arr)))


# Batch embedding for efficiency
def embed_document_chunks(
    chunks: list[dict],
    batch_size: int = 100
) -> list[dict]:
    all_texts = [c["text"] for c in chunks]
    all_embeddings = []

    for i in range(0, len(all_texts), batch_size):
        batch = all_texts[i : i + batch_size]
        embeddings = embed_texts(batch)
        all_embeddings.extend(embeddings)

    for chunk, embedding in zip(chunks, all_embeddings):
        chunk["embedding"] = embedding

    return chunks
Fasse deine Embedding-Anfragen in Batches zusammen. Chunks einzeln nacheinander einzubetten erzeugt massive Latenz und kostet durch den Overhead pro Anfrage mehr. Verarbeite sie in Batches von 100 bis 500, je nach den Rate Limits deines Anbieters.
Integration und Indizierung des Vektorspeichers
Sobald die Embeddings vorliegen, braucht man einen Vektorspeicher, der eine effiziente Approximate-Nearest-Neighbor-Suche unterstützt. Die Wahl zwischen Pinecone, Weaviate, Qdrant, Chroma und pgvector hängt von der eigenen Skalierung und den betrieblichen Anforderungen ab.
from qdrant_client import QdrantClient
from qdrant_client.models import (
    Distance,
    PointStruct,
    VectorParams,
    Filter,
    FieldCondition,
    MatchValue,
)
import uuid

client = QdrantClient(url="http://localhost:6333")

COLLECTION_NAME = "documents"
VECTOR_SIZE = 1536  # text-embedding-3-small dimension


def initialize_collection() -> None:
    client.recreate_collection(
        collection_name=COLLECTION_NAME,
        vectors_config=VectorParams(
            size=VECTOR_SIZE,
            distance=Distance.COSINE,
        ),
    )


def upsert_chunks(chunks: list[dict]) -> None:
    points = [
        PointStruct(
            id=str(uuid.uuid4()),
            vector=chunk["embedding"],
            payload={
                "text": chunk["text"],
                **chunk["metadata"],
            },
        )
        for chunk in chunks
    ]

    client.upsert(
        collection_name=COLLECTION_NAME,
        points=points,
    )


def search_similar(
    query_embedding: list[float],
    doc_type: str | None = None,
    top_k: int = 5,
) -> list[dict]:
    search_filter = None
    if doc_type:
        search_filter = Filter(
            must=[
                FieldCondition(
                    key="doc_type",
                    match=MatchValue(value=doc_type),
                )
            ]
        )

    results = client.search(
        collection_name=COLLECTION_NAME,
        query_vector=query_embedding,
        query_filter=search_filter,
        limit=top_k,
    )

    return [
        {
            "text": hit.payload["text"],
            "score": hit.score,
            "source": hit.payload.get("source", ""),
        }
        for hit in results
    ]
Das Filtern nach Metadaten ist entscheidend. Wenn die Dokumente mehrere Kategorien, Abteilungen oder Zeiträume umfassen, verbessert ein Filtern nach Metadaten vor der Vektorsuche die Präzision drastisch. Eine Anfrage zu den Finanzzahlen aus dem Q3 sollte keine Marketing-Dokumente aus dem Q1 zurückliefern, selbst wenn diese semantisch ähnlich sind.
Retrieval-Muster: hybride Suche und Reranking
Reine Vektorsuche übersieht exakte Keyword-Treffer. Reine Keyword-Suche übersieht semantische Zusammenhänge. Hybride Suche kombiniert beides für einen besseren Recall.
from qdrant_client.models import SearchParams

def hybrid_search(
    query: str,
    query_embedding: list[float],
    top_k: int = 10,
    rerank_top_k: int = 5,
) -> list[dict]:
    # Step 1: Vector search for semantic matches
    vector_results = search_similar(query_embedding, top_k=top_k)

    # Step 2: Keyword search for exact matches
    keyword_results = client.scroll(
        collection_name=COLLECTION_NAME,
        scroll_filter=Filter(
            must=[
                FieldCondition(
                    key="text",
                    match=MatchValue(value=query),
                )
            ]
        ),
        limit=top_k,
    )[0]

    # Step 3: Merge and deduplicate
    seen_texts = set()
    combined = []
    for result in vector_results:
        if result["text"] not in seen_texts:
            seen_texts.add(result["text"])
            combined.append(result)

    for point in keyword_results:
        text = point.payload["text"]
        if text not in seen_texts:
            seen_texts.add(text)
            combined.append({
                "text": text,
                "score": 0.5,
                "source": point.payload.get("source", ""),
            })

    # Step 4: Rerank with cross-encoder
    return rerank_results(query, combined[:rerank_top_k])
Reranking mit einem Cross-Encoder ist die Verbesserung mit dem größten Hebel, die man an einer RAG-Pipeline vornehmen kann. Vektorsuche nutzt Bi-Encoder – schnell, aber approximativ. Cross-Encoder verarbeiten Anfrage und Dokument gemeinsam und liefern dadurch deutlich genauere Relevanz-Scores, allerdings auf Kosten der Geschwindigkeit.
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("cross-encoder/ms-marco-MiniLM-L-6-v2")


def rerank_results(
    query: str,
    results: list[dict],
) -> list[dict]:
    if not results:
        return []

    pairs = [(query, r["text"]) for r in results]
    scores = reranker.predict(pairs)

    for result, score in zip(results, scores):
        result["rerank_score"] = float(score)

    return sorted(results, key=lambda x: x["rerank_score"], reverse=True)
Prompt-Aufbau: Verwaltung des Kontextfensters
Die abgerufenen Chunks müssen zu einem Prompt zusammengesetzt werden, der dem LLM genug Kontext gibt, um präzise zu antworten, ohne das Kontextfenster zu sprengen oder den Fokus zu verwässern.
from openai import OpenAI

client = OpenAI()


def build_rag_prompt(
    query: str,
    retrieved_chunks: list[dict],
    max_context_tokens: int = 3000,
) -> list[dict]:
    context_parts = []
    estimated_tokens = 0

    for chunk in retrieved_chunks:
        chunk_tokens = len(chunk["text"].split()) * 1.3
        if estimated_tokens + chunk_tokens > max_context_tokens:
            break
        context_parts.append(
            f"[Source: {chunk['source']}]\n{chunk['text']}"
        )
        estimated_tokens += chunk_tokens

    context = "\n\n---\n\n".join(context_parts)

    return [
        {
            "role": "system",
            "content": (
                "You are a helpful assistant that answers questions based on "
                "the provided context. If the context does not contain enough "
                "information to answer the question, say so explicitly. "
                "Do not make up information. Cite sources when possible."
            ),
        },
        {
            "role": "user",
            "content": f"Context:\n{context}\n\nQuestion: {query}",
        },
    ]


def query_rag(query: str) -> str:
    query_embedding = embed_texts([query])[0]
    chunks = hybrid_search(query, query_embedding, top_k=10, rerank_top_k=5)
    messages = build_rag_prompt(query, chunks)

    response = client.chat.completions.create(
        model="gpt-4o",
        messages=messages,
        temperature=0.1,
    )

    return response.choices[0].message.content or ""
Eine niedrige Temperature (0,1-0,2) reduziert Halluzinationen in RAG-Antworten. Der System-Prompt weist das Modell explizit an, Wissenslücken einzugestehen, statt Antworten zu erfinden – das ist bei produktiven Systemen nicht verhandelbar.
Evaluation: die Qualität von RAG messen
Man kann nicht verbessern, was man nicht misst. Die Evaluation von RAG erfordert, drei Dimensionen zu testen: die Qualität des Retrievals (Werden die richtigen Chunks gefunden?), die Qualität der Generierung (Ist die Antwort korrekt?) und die Kontexttreue (Bleibt die Antwort im abgerufenen Kontext verankert?).
def evaluate_retrieval(
    test_cases: list[dict],
) -> dict:
    metrics = {"recall_at_5": [], "mrr": []}

    for case in test_cases:
        query_embedding = embed_texts([case["query"]])[0]
        results = search_similar(query_embedding, top_k=5)
        retrieved_sources = [r["source"] for r in results]

        relevant = case["relevant_sources"]
        hits = [s for s in retrieved_sources if s in relevant]

        recall = len(hits) / len(relevant) if relevant else 0
        metrics["recall_at_5"].append(recall)

        for rank, source in enumerate(retrieved_sources, 1):
            if source in relevant:
                metrics["mrr"].append(1.0 / rank)
                break
        else:
            metrics["mrr"].append(0.0)

    return {
        "mean_recall_at_5": sum(metrics["recall_at_5"]) / len(metrics["recall_at_5"]),
        "mean_mrr": sum(metrics["mrr"]) / len(metrics["mrr"]),
    }
Baue dir einen Testdatensatz aus 50 bis 100 Frage-Antwort-Paaren mit bekannten Quelldokumenten auf. Führe die Retrieval-Evaluation nach jeder Änderung an der Chunking-Strategie, am Embedding-Modell oder an den Suchparametern erneut aus. Eine Verbesserung von 5 % beim Recall@5 kann sich in einer deutlich besseren Nutzererfahrung niederschlagen.
Die wichtigsten Erkenntnisse
RAG ist keine einzelne Technik, sondern eine Pipeline, und jede Stufe summiert Qualität oder Fehler auf. Chunke entlang semantischer Grenzen und mit Überlappung. Fasse deine Embeddings in Batches zusammen. Filtere vor der Vektorsuche nach Metadaten. Führe Reranking mit Cross-Encodern durch. Halte die Temperature niedrig und die System-Prompts strikt.
Die Lücke zwischen einer RAG-Demo und einem RAG-Produkt heißt Messung. Ohne Retrieval-Evaluation und Kontexttreue-Prüfungen fliegt man blind. Baue deinen Testdatensatz frühzeitig auf, automatisiere deine Evaluationspipeline und lass die Metriken jede Architekturentscheidung leiten.