Produktionsreife RAG-Pipelines mit LangChain entwickeln
Entwirf RAG-Pipelines jenseits einfacher Demos: Chunking-Strategien, Embedding-Optimierung, Reranking und Evaluationsmetriken für die Produktion.

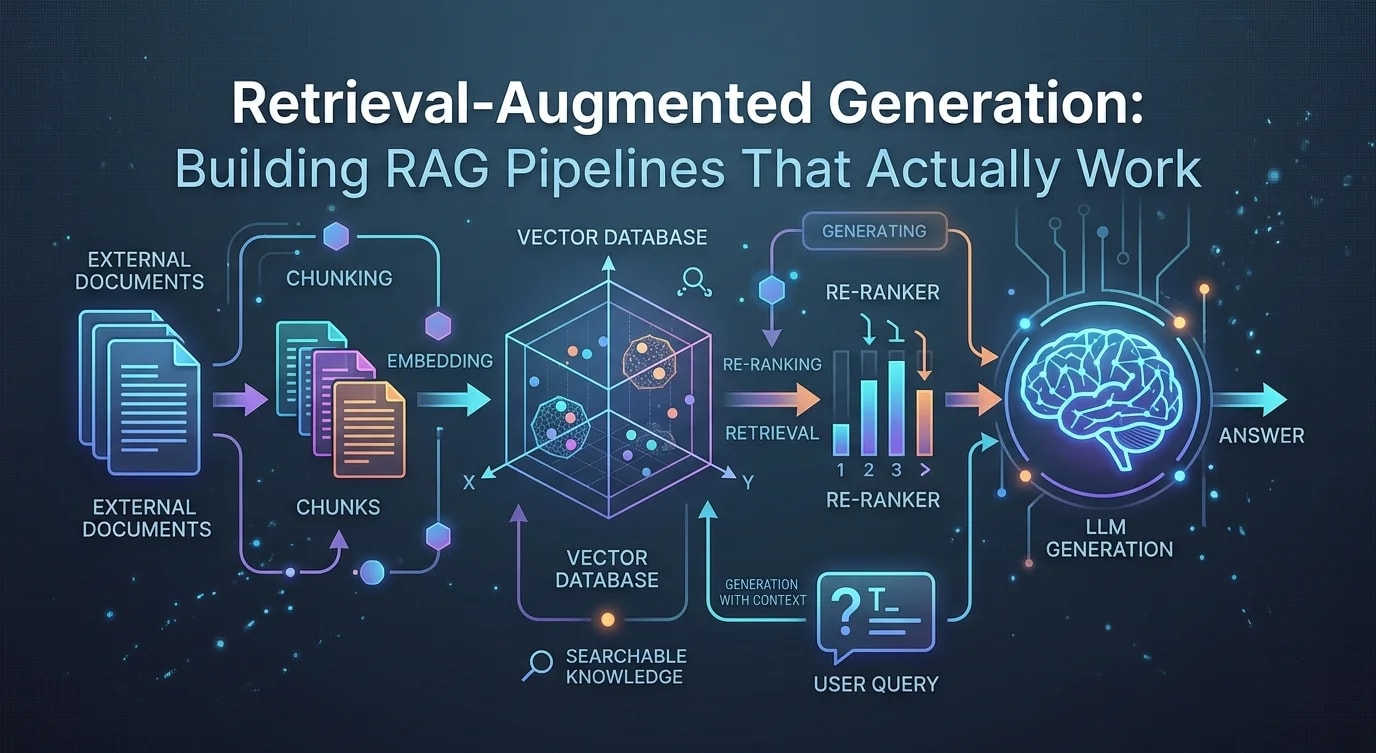
Jedes RAG-Tutorial zeigt dasselbe: eine PDF laden, in Chunks aufteilen, Embeddings erzeugen und Fragen stellen. Die Demo funktioniert einwandfrei. Doch sobald man es mit echten Dokumenten ausprobiert, werden die Antworten falsch, halluziniert oder irrelevant. Die Kluft zwischen Demo-RAG und Produktions-RAG ist gewaltig und steckt in den Details von Chunking, Retrieval und Evaluation.
Die Chunking-Strategie zählt mehr als die Modellwahl
Die wirkungsvollste Entscheidung in einer RAG-Pipeline ist nicht, welches LLM man verwendet, sondern wie man die Dokumente aufteilt. Schlechtes Chunking führt zu schlechtem Retrieval, und keine noch so ausgefeilte Modellarchitektur kann fehlerhafte Eingaben ausgleichen.
// ❌ Naive fixed-size chunking breaks semantic boundaries
interface NaiveChunkConfig {
  chunkSize: number;
  overlap: number;
}

function naiveChunk(text: string, config: NaiveChunkConfig): string[] {
  const chunks: string[] = [];
  for (let i = 0; i < text.length; i += config.chunkSize - config.overlap) {
    chunks.push(text.slice(i, i + config.chunkSize));
  }
  return chunks;
  // Problem: cuts mid-sentence, splits code blocks,
  // separates headers from their content
}// ✅ Semantic-aware chunking preserves meaning
interface SemanticChunkConfig {
maxChunkTokens: number;
minChunkTokens: number;
overlapSentences: number;
preserveStructure: boolean;
}
interface DocumentChunk {
content: string;
metadata: {
source: string;
section: string;
pageNumber?: number;
chunkIndex: number;
tokenCount: number;
};
}
function semanticChunk(
document: string,
config: SemanticChunkConfig
): DocumentChunk[] {
const sections = splitBySections(document);
const chunks: DocumentChunk[] = [];
let chunkIndex = 0;
for (const section of sections) {
const sentences = splitSentences(section.content);
let currentChunk: string[] = [];
let currentTokens = 0;
for (const sentence of sentences) {
const sentenceTokens = estimateTokens(sentence);
if (
currentTokens + sentenceTokens > config.maxChunkTokens &&
currentTokens >= config.minChunkTokens
) {
chunks.push({
content: currentChunk.join(" "),
metadata: {
source: document.slice(0, 50),
section: section.heading,
chunkIndex: chunkIndex++,
tokenCount: currentTokens,
},
});
// Keep overlap sentences for context continuity
const overlapStart = Math.max(
0,
currentChunk.length - config.overlapSentences
);
currentChunk = currentChunk.slice(overlapStart);
currentTokens = currentChunk
.reduce((s, sent) => s + estimateTokens(sent), 0);
}
currentChunk.push(sentence);
currentTokens += sentenceTokens;
}
// Flush remaining content
if (currentChunk.length > 0) {
chunks.push({
content: currentChunk.join(" "),
metadata: {
source: document.slice(0, 50),
section: section.heading,
chunkIndex: chunkIndex++,
tokenCount: currentTokens,
},
});
}
}
return chunks;
}
function splitBySections(text: string): { heading: string; content: string }[] {
const sectionPattern = /^(#{1,3})\s+(.+)$/gm;
const sections: { heading: string; content: string }[] = [];
let lastIndex = 0;
let lastHeading = "Introduction";
let match: RegExpExecArray | null;
while ((match = sectionPattern.exec(text)) !== null) {
if (match.index > lastIndex) {
sections.push({
heading: lastHeading,
content: text.slice(lastIndex, match.index).trim(),
});
}
lastHeading = match[2];
lastIndex = match.index + match[0].length;
}
if (lastIndex < text.length) {
sections.push({
heading: lastHeading,
content: text.slice(lastIndex).trim(),
});
}
return sections;
}
function splitSentences(text: string): string[] {
return text.split(/(?<=[.!?])\s+/).filter(s => s.length > 0);
}
function estimateTokens(text: string): number {
return Math.ceil(text.length / 4);
}Abschnittsbewusstes Chunking bewahrt die Beziehung zwischen Überschriften und ihrem Inhalt. Die Metadaten, die an jedem Chunk hängen, ermöglichen eine gefilterte Suche: „Chunks aus dem Abschnitt ‚Authentication‘ finden."
Hybrides Retrieval: Dense + Sparse
Die Vektor-Ähnlichkeitssuche (Dense Retrieval) ist stark im semantischen Abgleich, verpasst aber exakte Keyword-Treffer. BM25 (Sparse Retrieval) findet exakte Begriffe, übersieht aber semantische Entsprechungen. Die Kombination beider Verfahren schlägt jedes einzelne für sich.
interface RetrievalResult {
  chunk: DocumentChunk;
  score: number;
  source: "dense" | "sparse" | "hybrid";
}

interface HybridRetrieverConfig {
  denseWeight: number;   // 0-1, weight for vector search
  sparseWeight: number;  // 0-1, weight for BM25
  topK: number;
  rerankEnabled: boolean;
}

class HybridRetriever {
  private config: HybridRetrieverConfig;

  constructor(config: HybridRetrieverConfig) {
    this.config = config;
  }

  async retrieve(
    query: string,
    denseResults: RetrievalResult[],
    sparseResults: RetrievalResult[]
  ): Promise<RetrievalResult[]> {
    // Normalize scores to 0-1 range
    const normalizedDense = this.normalizeScores(denseResults);
    const normalizedSparse = this.normalizeScores(sparseResults);

    // Reciprocal Rank Fusion for combining results
    const fusedScores = new Map<string, number>();
    const chunkMap = new Map<string, DocumentChunk>();
    const k = 60; // RRF constant

    normalizedDense.forEach((result, rank) => {
      const key = result.chunk.metadata.chunkIndex.toString();
      const rrfScore = this.config.denseWeight / (k + rank + 1);
      fusedScores.set(key, (fusedScores.get(key) ?? 0) + rrfScore);
      chunkMap.set(key, result.chunk);
    });

    normalizedSparse.forEach((result, rank) => {
      const key = result.chunk.metadata.chunkIndex.toString();
      const rrfScore = this.config.sparseWeight / (k + rank + 1);
      fusedScores.set(key, (fusedScores.get(key) ?? 0) + rrfScore);
      chunkMap.set(key, result.chunk);
    });

    // Sort by fused score
    const results: RetrievalResult[] = Array.from(fusedScores.entries())
      .sort(([, a], [, b]) => b - a)
      .slice(0, this.config.topK)
      .map(([key, score]) => ({
        chunk: chunkMap.get(key)!,
        score,
        source: "hybrid" as const,
      }));

    return results;
  }

  private normalizeScores(
    results: RetrievalResult[]
  ): RetrievalResult[] {
    if (results.length === 0) return [];
    const maxScore = Math.max(...results.map(r => r.score));
    const minScore = Math.min(...results.map(r => r.score));
    const range = maxScore - minScore || 1;

    return results.map(r => ({
      ...r,
      score: (r.score - minScore) / range,
    }));
  }
}
Reciprocal Rank Fusion (RRF) ist besonders wirkungsvoll, weil dabei die Scores unterschiedlicher Systeme nicht auf derselben Skala liegen müssen — es zählen nur die Rangpositionen.
Aufbau des Kontextfensters
Abgerufene Chunks müssen sorgfältig zusammengesetzt werden, bevor sie an das LLM gehen. Wer die Top-K-Ergebnisse einfach aneinanderreiht, schleppt oft redundante Informationen mit und verschwendet Tokens im Kontextfenster.
interface ContextWindow {
  systemPrompt: string;
  retrievedContext: string;
  userQuery: string;
  totalTokens: number;
  maxTokens: number;
}

function assembleContext(
  query: string,
  results: RetrievalResult[],
  maxContextTokens: number
): ContextWindow {
  const systemPrompt =
    "Answer the question based on the provided context. " +
    "If the context doesn't contain enough information, say so. " +
    "Cite the source section when possible.";

  // Deduplicate overlapping chunks
  const deduplicated = deduplicateChunks(results);

  // Group by section for coherent reading
  const grouped = groupBySection(deduplicated);

  // Build context within token budget
  let contextParts: string[] = [];
  let currentTokens = 0;

  for (const [section, chunks] of grouped) {
    const sectionHeader = `[Section: ${section}]`;
    const sectionTokens = estimateTokens(sectionHeader);

    if (currentTokens + sectionTokens > maxContextTokens) break;

    contextParts.push(sectionHeader);
    currentTokens += sectionTokens;

    for (const chunk of chunks) {
      const chunkTokens = chunk.chunk.metadata.tokenCount;
      if (currentTokens + chunkTokens > maxContextTokens) break;
      contextParts.push(chunk.chunk.content);
      currentTokens += chunkTokens;
    }
  }

  const retrievedContext = contextParts.join("\n\n");
  const totalTokens =
    estimateTokens(systemPrompt) +
    currentTokens +
    estimateTokens(query);

  return {
    systemPrompt,
    retrievedContext,
    userQuery: query,
    totalTokens,
    maxTokens: maxContextTokens,
  };
}

function deduplicateChunks(
  results: RetrievalResult[]
): RetrievalResult[] {
  const seen = new Set<number>();
  return results.filter(r => {
    if (seen.has(r.chunk.metadata.chunkIndex)) return false;
    seen.add(r.chunk.metadata.chunkIndex);
    return true;
  });
}

function groupBySection(
  results: RetrievalResult[]
): Map<string, RetrievalResult[]> {
  const groups = new Map<string, RetrievalResult[]>();
  for (const result of results) {
    const section = result.chunk.metadata.section;
    const existing = groups.get(section) ?? [];
    existing.push(result);
    groups.set(section, existing);
  }
  return groups;
}
Die RAG-Qualität bewerten
Ohne Evaluation rätst du bloß, ob deine RAG-Pipeline tatsächlich funktioniert. Drei Metriken zählen am meisten: die Relevanz der Retrieval-Ergebnisse, die Korrektheit der Antwort und die Treue zum Kontext (bleibt die Antwort beim abgerufenen Kontext?).
interface RAGEvaluation {
  query: string;
  expectedAnswer: string;
  retrievedChunks: DocumentChunk[];
  generatedAnswer: string;
  metrics: {
    retrievalRelevance: number;  // 0-1: are retrieved chunks relevant?
    answerCorrectness: number;   // 0-1: is the answer correct?
    faithfulness: number;        // 0-1: does answer follow from context?
    contextUtilization: number;  // 0-1: how much context was used?
  };
}

function calculateRetrievalRelevance(
  chunks: DocumentChunk[],
  relevantChunkIds: Set<number>
): number {
  if (chunks.length === 0) return 0;
  const relevant = chunks.filter(c =>
    relevantChunkIds.has(c.metadata.chunkIndex)
  );
  return relevant.length / chunks.length;
}

interface EvalDataset {
  queries: {
    query: string;
    expectedAnswer: string;
    relevantChunkIds: number[];
  }[];
}

function runEvaluation(
  pipeline: RAGPipeline,
  dataset: EvalDataset
): { avgRelevance: number; avgCorrectness: number } {
  let totalRelevance = 0;
  let totalCorrectness = 0;

  for (const item of dataset.queries) {
    const result = pipeline.query(item.query);

    const relevance = calculateRetrievalRelevance(
      result.chunks,
      new Set(item.relevantChunkIds)
    );

    totalRelevance += relevance;
    // Correctness typically requires LLM-as-judge evaluation
  }

  return {
    avgRelevance: totalRelevance / dataset.queries.length,
    avgCorrectness: totalCorrectness / dataset.queries.length,
  };
}
Baue Evaluationsdatensätze aus echten Nutzerfragen auf. Beginne mit 50 bis 100 Frage-Antwort-Paaren, überprüfe die erwarteten Antworten manuell und führe nach jeder Änderung an der Pipeline eine Evaluation durch. Ohne diese Feedback-Schleife optimierst du ins Blaue hinein.
Wichtigste Erkenntnisse
Produktionsreife RAG-Pipelines stehen und fallen mit drei Faktoren: der Qualität des Chunkings, der Präzision des Retrievals und einer systematischen Evaluation. Teile Dokumente entlang semantischer Grenzen — Abschnittsüberschriften, Absatzwechsel und logische Einheiten — statt nach einer festen Zeichenzahl. Kombiniere die dichte Vektorsuche mit dem spärlichen BM25-Retrieval über Reciprocal Rank Fusion, um sowohl semantische Treffer als auch exakte Keyword-Treffer zu erfassen. Setze Kontextfenster sorgfältig zusammen, indem du überlappende Chunks entfernst und sie zur besseren Lesbarkeit nach Abschnitt gruppierst. Am wichtigsten: Baue einen Evaluationsdatensatz aus echten Anfragen auf und miss nach jeder Änderung die Relevanz des Retrievals und die Korrektheit der Antworten. Teams, die zuverlässige RAG-Systeme bauen, behandeln das Ganze als Information-Retrieval-Engineering, nicht als Prompt-Engineering.