Cómo construir pipelines RAG listos para producción con LangChain
Diseña pipelines RAG que superen la fase de demo: estrategias de chunking, optimización de embeddings, reranking y métricas de evaluación.

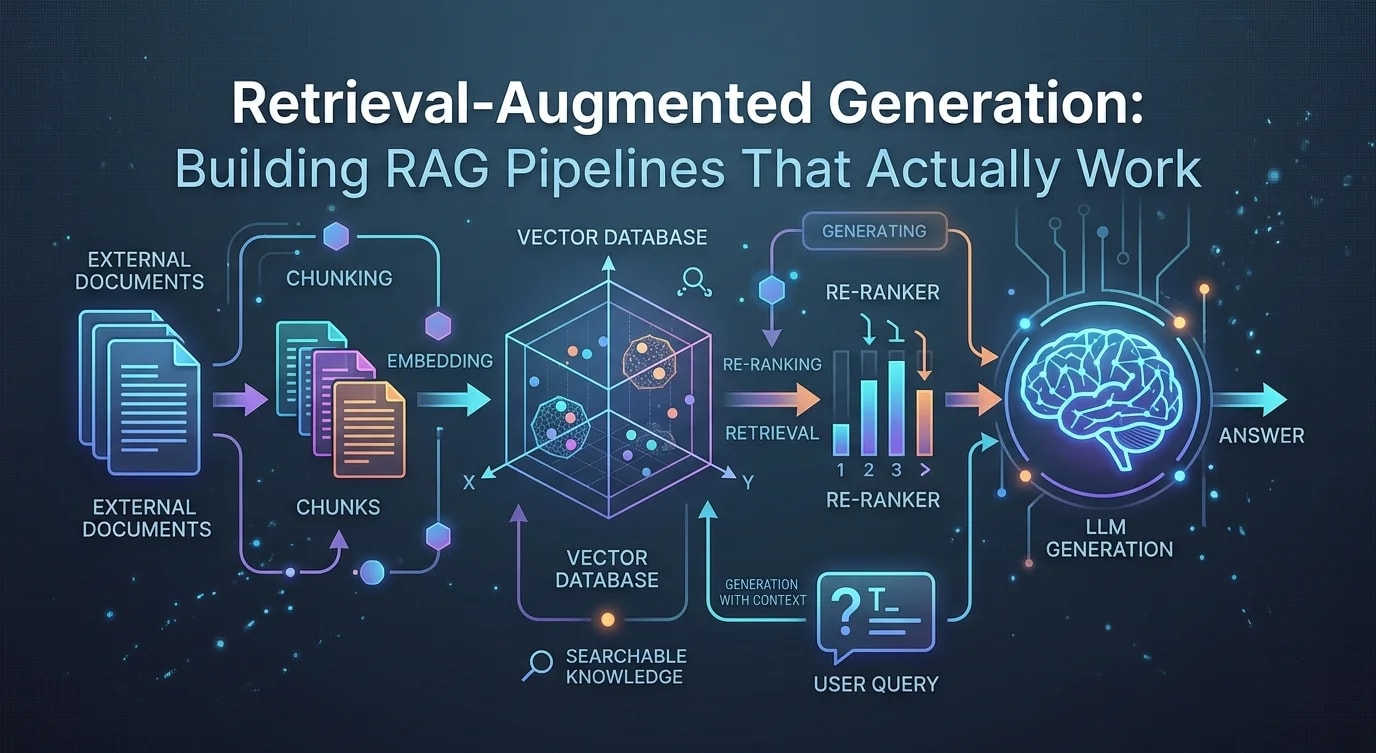
Todos los tutoriales de RAG muestran lo mismo: cargar un PDF, dividirlo en chunks, generar sus embeddings y hacer preguntas. La demo funciona a la perfección. Pero en cuanto la pruebas con documentos reales, las respuestas empiezan a ser incorrectas, alucinadas o irrelevantes. La distancia entre un RAG de demo y un RAG de producción es enorme, y se esconde en los detalles del chunking, la recuperación y la evaluación.
La estrategia de chunking importa más que la elección del modelo
La decisión con más impacto en un pipeline RAG no es qué LLM usas, sino cómo divides tus documentos. Un chunking deficiente produce una recuperación deficiente, y ninguna sofisticación del modelo puede compensar una entrada de mala calidad.
// ❌ Naive fixed-size chunking breaks semantic boundaries
interface NaiveChunkConfig {
  chunkSize: number;
  overlap: number;
}

function naiveChunk(text: string, config: NaiveChunkConfig): string[] {
  const chunks: string[] = [];
  for (let i = 0; i < text.length; i += config.chunkSize - config.overlap) {
    chunks.push(text.slice(i, i + config.chunkSize));
  }
  return chunks;
  // Problem: cuts mid-sentence, splits code blocks,
  // separates headers from their content
}// ✅ Semantic-aware chunking preserves meaning
interface SemanticChunkConfig {
maxChunkTokens: number;
minChunkTokens: number;
overlapSentences: number;
preserveStructure: boolean;
}
interface DocumentChunk {
content: string;
metadata: {
source: string;
section: string;
pageNumber?: number;
chunkIndex: number;
tokenCount: number;
};
}
function semanticChunk(
document: string,
config: SemanticChunkConfig
): DocumentChunk[] {
const sections = splitBySections(document);
const chunks: DocumentChunk[] = [];
let chunkIndex = 0;
for (const section of sections) {
const sentences = splitSentences(section.content);
let currentChunk: string[] = [];
let currentTokens = 0;
for (const sentence of sentences) {
const sentenceTokens = estimateTokens(sentence);
if (
currentTokens + sentenceTokens > config.maxChunkTokens &&
currentTokens >= config.minChunkTokens
) {
chunks.push({
content: currentChunk.join(" "),
metadata: {
source: document.slice(0, 50),
section: section.heading,
chunkIndex: chunkIndex++,
tokenCount: currentTokens,
},
});
// Keep overlap sentences for context continuity
const overlapStart = Math.max(
0,
currentChunk.length - config.overlapSentences
);
currentChunk = currentChunk.slice(overlapStart);
currentTokens = currentChunk
.reduce((s, sent) => s + estimateTokens(sent), 0);
}
currentChunk.push(sentence);
currentTokens += sentenceTokens;
}
// Flush remaining content
if (currentChunk.length > 0) {
chunks.push({
content: currentChunk.join(" "),
metadata: {
source: document.slice(0, 50),
section: section.heading,
chunkIndex: chunkIndex++,
tokenCount: currentTokens,
},
});
}
}
return chunks;
}
function splitBySections(text: string): { heading: string; content: string }[] {
const sectionPattern = /^(#{1,3})\s+(.+)$/gm;
const sections: { heading: string; content: string }[] = [];
let lastIndex = 0;
let lastHeading = "Introduction";
let match: RegExpExecArray | null;
while ((match = sectionPattern.exec(text)) !== null) {
if (match.index > lastIndex) {
sections.push({
heading: lastHeading,
content: text.slice(lastIndex, match.index).trim(),
});
}
lastHeading = match[2];
lastIndex = match.index + match[0].length;
}
if (lastIndex < text.length) {
sections.push({
heading: lastHeading,
content: text.slice(lastIndex).trim(),
});
}
return sections;
}
function splitSentences(text: string): string[] {
return text.split(/(?<=[.!?])\s+/).filter(s => s.length > 0);
}
function estimateTokens(text: string): number {
return Math.ceil(text.length / 4);
}El chunking consciente de las secciones conserva la relación entre los encabezados y su contenido. Los metadatos asociados a cada chunk permiten una recuperación filtrada: "encontrar los chunks de la sección 'Authentication'".
Recuperación híbrida: densa + dispersa
La búsqueda por similitud vectorial (dense retrieval) es excelente para encontrar coincidencias semánticas, pero se le escapan las coincidencias exactas de palabras clave. BM25 (sparse retrieval) encuentra términos exactos, pero pasa por alto los equivalentes semánticos. Combinar ambos enfoques supera a cualquiera de los dos por separado.
interface RetrievalResult {
  chunk: DocumentChunk;
  score: number;
  source: "dense" | "sparse" | "hybrid";
}

interface HybridRetrieverConfig {
  denseWeight: number;   // 0-1, weight for vector search
  sparseWeight: number;  // 0-1, weight for BM25
  topK: number;
  rerankEnabled: boolean;
}

class HybridRetriever {
  private config: HybridRetrieverConfig;

  constructor(config: HybridRetrieverConfig) {
    this.config = config;
  }

  async retrieve(
    query: string,
    denseResults: RetrievalResult[],
    sparseResults: RetrievalResult[]
  ): Promise<RetrievalResult[]> {
    // Normalize scores to 0-1 range
    const normalizedDense = this.normalizeScores(denseResults);
    const normalizedSparse = this.normalizeScores(sparseResults);

    // Reciprocal Rank Fusion for combining results
    const fusedScores = new Map<string, number>();
    const chunkMap = new Map<string, DocumentChunk>();
    const k = 60; // RRF constant

    normalizedDense.forEach((result, rank) => {
      const key = result.chunk.metadata.chunkIndex.toString();
      const rrfScore = this.config.denseWeight / (k + rank + 1);
      fusedScores.set(key, (fusedScores.get(key) ?? 0) + rrfScore);
      chunkMap.set(key, result.chunk);
    });

    normalizedSparse.forEach((result, rank) => {
      const key = result.chunk.metadata.chunkIndex.toString();
      const rrfScore = this.config.sparseWeight / (k + rank + 1);
      fusedScores.set(key, (fusedScores.get(key) ?? 0) + rrfScore);
      chunkMap.set(key, result.chunk);
    });

    // Sort by fused score
    const results: RetrievalResult[] = Array.from(fusedScores.entries())
      .sort(([, a], [, b]) => b - a)
      .slice(0, this.config.topK)
      .map(([key, score]) => ({
        chunk: chunkMap.get(key)!,
        score,
        source: "hybrid" as const,
      }));

    return results;
  }

  private normalizeScores(
    results: RetrievalResult[]
  ): RetrievalResult[] {
    if (results.length === 0) return [];
    const maxScore = Math.max(...results.map(r => r.score));
    const minScore = Math.min(...results.map(r => r.score));
    const range = maxScore - minScore || 1;

    return results.map(r => ({
      ...r,
      score: (r.score - minScore) / range,
    }));
  }
}
Reciprocal Rank Fusion (RRF) resulta especialmente eficaz porque no necesita que las puntuaciones de los distintos sistemas estén en la misma escala: solo utiliza las posiciones del ranking.
Ensamblaje de la ventana de contexto
Los chunks recuperados necesitan un ensamblaje cuidadoso antes de enviarse al LLM. Concatenar sin más los top-K resultados suele incluir información redundante y desperdicia tokens de la ventana de contexto.
interface ContextWindow {
  systemPrompt: string;
  retrievedContext: string;
  userQuery: string;
  totalTokens: number;
  maxTokens: number;
}

function assembleContext(
  query: string,
  results: RetrievalResult[],
  maxContextTokens: number
): ContextWindow {
  const systemPrompt =
    "Answer the question based on the provided context. " +
    "If the context doesn't contain enough information, say so. " +
    "Cite the source section when possible.";

  // Deduplicate overlapping chunks
  const deduplicated = deduplicateChunks(results);

  // Group by section for coherent reading
  const grouped = groupBySection(deduplicated);

  // Build context within token budget
  let contextParts: string[] = [];
  let currentTokens = 0;

  for (const [section, chunks] of grouped) {
    const sectionHeader = `[Section: ${section}]`;
    const sectionTokens = estimateTokens(sectionHeader);

    if (currentTokens + sectionTokens > maxContextTokens) break;

    contextParts.push(sectionHeader);
    currentTokens += sectionTokens;

    for (const chunk of chunks) {
      const chunkTokens = chunk.chunk.metadata.tokenCount;
      if (currentTokens + chunkTokens > maxContextTokens) break;
      contextParts.push(chunk.chunk.content);
      currentTokens += chunkTokens;
    }
  }

  const retrievedContext = contextParts.join("\n\n");
  const totalTokens =
    estimateTokens(systemPrompt) +
    currentTokens +
    estimateTokens(query);

  return {
    systemPrompt,
    retrievedContext,
    userQuery: query,
    totalTokens,
    maxTokens: maxContextTokens,
  };
}

function deduplicateChunks(
  results: RetrievalResult[]
): RetrievalResult[] {
  const seen = new Set<number>();
  return results.filter(r => {
    if (seen.has(r.chunk.metadata.chunkIndex)) return false;
    seen.add(r.chunk.metadata.chunkIndex);
    return true;
  });
}

function groupBySection(
  results: RetrievalResult[]
): Map<string, RetrievalResult[]> {
  const groups = new Map<string, RetrievalResult[]>();
  for (const result of results) {
    const section = result.chunk.metadata.section;
    const existing = groups.get(section) ?? [];
    existing.push(result);
    groups.set(section, existing);
  }
  return groups;
}
Evaluar la calidad del RAG
Sin evaluación, solo estás adivinando si tu pipeline RAG realmente funciona. Tres métricas son las que más importan: la relevancia de la recuperación, la corrección de la respuesta y la fidelidad (¿la respuesta se ciñe al contexto recuperado?).
interface RAGEvaluation {
  query: string;
  expectedAnswer: string;
  retrievedChunks: DocumentChunk[];
  generatedAnswer: string;
  metrics: {
    retrievalRelevance: number;  // 0-1: are retrieved chunks relevant?
    answerCorrectness: number;   // 0-1: is the answer correct?
    faithfulness: number;        // 0-1: does answer follow from context?
    contextUtilization: number;  // 0-1: how much context was used?
  };
}

function calculateRetrievalRelevance(
  chunks: DocumentChunk[],
  relevantChunkIds: Set<number>
): number {
  if (chunks.length === 0) return 0;
  const relevant = chunks.filter(c =>
    relevantChunkIds.has(c.metadata.chunkIndex)
  );
  return relevant.length / chunks.length;
}

interface EvalDataset {
  queries: {
    query: string;
    expectedAnswer: string;
    relevantChunkIds: number[];
  }[];
}

function runEvaluation(
  pipeline: RAGPipeline,
  dataset: EvalDataset
): { avgRelevance: number; avgCorrectness: number } {
  let totalRelevance = 0;
  let totalCorrectness = 0;

  for (const item of dataset.queries) {
    const result = pipeline.query(item.query);

    const relevance = calculateRetrievalRelevance(
      result.chunks,
      new Set(item.relevantChunkIds)
    );

    totalRelevance += relevance;
    // Correctness typically requires LLM-as-judge evaluation
  }

  return {
    avgRelevance: totalRelevance / dataset.queries.length,
    avgCorrectness: totalCorrectness / dataset.queries.length,
  };
}
Construye conjuntos de datos de evaluación a partir de preguntas reales de usuarios. Empieza con 50-100 pares de consulta-respuesta, verifica manualmente las respuestas esperadas y ejecuta evaluaciones después de cada cambio en el pipeline. Sin este ciclo de retroalimentación, estás optimizando a ciegas.
Conclusiones clave
Los pipelines RAG en producción triunfan o fracasan en tres frentes: la calidad del chunking, la precisión de la recuperación y una evaluación sistemática. Divide los documentos siguiendo límites semánticos —encabezados de sección, saltos de párrafo y unidades lógicas— en lugar de un número fijo de caracteres. Combina la búsqueda vectorial densa con la recuperación dispersa de BM25 mediante Reciprocal Rank Fusion para capturar tanto coincidencias semánticas como coincidencias exactas de palabras clave. Ensambla las ventanas de contexto con cuidado, eliminando chunks duplicados y agrupándolos por sección para una lectura coherente. Y lo más importante: construye un conjunto de datos de evaluación a partir de consultas reales y mide la relevancia de la recuperación y la corrección de las respuestas después de cada cambio. Los equipos que logran sistemas RAG confiables lo tratan como un problema de ingeniería de recuperación de información, no como un problema de ingeniería de prompts.