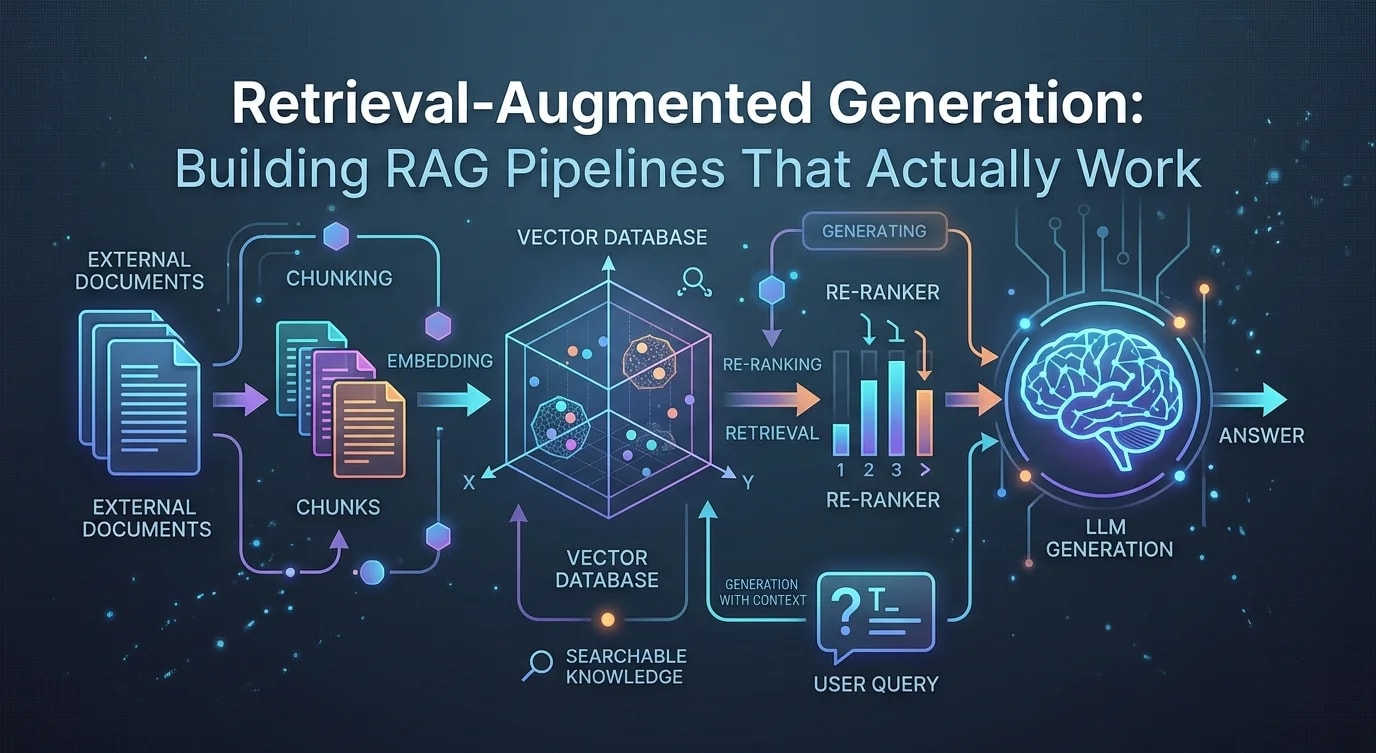
Generación aumentada por recuperación: pipelines RAG que funcionan
Construye pipelines RAG eficaces en TypeScript: chunking de documentos, embeddings, ajuste de búsqueda vectorial, prompts y evaluación de la recuperación.

Los modelos de lenguaje grandes alucinan. Generan texto fluido y seguro que suena correcto, pero inventan datos, citan mal las fuentes y confunden conceptos relacionados. La generación aumentada por recuperación (RAG) resuelve esto anclando las respuestas del modelo en documentos reales recuperados en el momento de la consulta: el modelo genera respuestas basadas en evidencia, no en memoria.
Pero los sistemas RAG tienen sus propios modos de fallo. Un chunking deficiente divide el contexto relevante entre fragmentos. Unos embeddings de baja calidad devuelven documentos irrelevantes. Una construcción de prompts ingenua satura la ventana de contexto. Construir un pipeline RAG que funcione exige prestar atención cuidadosa a cada etapa.
La arquitectura del pipeline RAG
Un pipeline RAG tiene dos fases: indexación (offline) y recuperación + generación (en tiempo real).
// ❌ Naive RAG — dumps entire documents into the prompt
async function naiveRAG(query: string) {
  const allDocs = await db.getAllDocuments();
  const prompt = `
    Here are all our documents:
    ${allDocs.map((d) => d.content).join("\n\n")}

    Answer this question: ${query}
  `;
  // Problems:
  // - Exceeds context window
  // - Irrelevant content dilutes the answer
  // - No relevance ranking
  // - Costs a fortune in tokens
  return llm.generate(prompt);
}// ✅ Structured RAG pipeline
async function structuredRAG(query: string) {
// 1. Embed the query
const queryEmbedding = await embedQuery(query);
// 2. Retrieve relevant chunks
const chunks = await vectorStore.search(
queryEmbedding,
{ topK: 5, minScore: 0.7 }
);
// 3. Construct grounded prompt
const prompt = buildPrompt(query, chunks);
// 4. Generate with citations
return llm.generate(prompt, {
temperature: 0.1,
maxTokens: 1000,
});
}Estrategias de chunking de documentos
El chunking determina la granularidad de la recuperación. Si los chunks son demasiado grandes, desperdicias ventana de contexto en contenido irrelevante. Si son demasiado pequeños, pierdes el contexto necesario para responder las preguntas.
interface Chunk {
  id: string;
  content: string;
  metadata: {
    source: string;
    section: string;
    pageNumber?: number;
    chunkIndex: number;
  };
}

// Strategy 1: Fixed-size with overlap
function fixedSizeChunking(
  text: string,
  chunkSize: number = 500,
  overlap: number = 50
): string[] {
  const words = text.split(/\s+/);
  const chunks: string[] = [];

  for (
    let i = 0;
    i < words.length;
    i += chunkSize - overlap
  ) {
    chunks.push(
      words.slice(i, i + chunkSize).join(" ")
    );
  }

  return chunks;
}

// Strategy 2: Semantic chunking by sections
function semanticChunking(
  markdown: string
): Chunk[] {
  const sections = markdown.split(/^##\s+/m);
  const chunks: Chunk[] = [];

  for (let i = 0; i < sections.length; i++) {
    const section = sections[i].trim();
    if (!section) continue;

    const lines = section.split("\n");
    const heading = lines[0];
    const content = lines.slice(1).join("\n").trim();

    // Split large sections further
    if (content.length > 2000) {
      const paragraphs = content.split(/\n\n+/);
      let currentChunk = "";

      for (const para of paragraphs) {
        if (
          (currentChunk + para).length > 1500 &&
          currentChunk
        ) {
          chunks.push({
            id: `chunk-${chunks.length}`,
            content: `## ${heading}\n\n${currentChunk}`,
            metadata: {
              source: "",
              section: heading,
              chunkIndex: chunks.length,
            },
          });
          currentChunk = para;
        } else {
          currentChunk += (currentChunk ? "\n\n" : "") + para;
        }
      }

      if (currentChunk) {
        chunks.push({
          id: `chunk-${chunks.length}`,
          content: `## ${heading}\n\n${currentChunk}`,
          metadata: {
            source: "",
            section: heading,
            chunkIndex: chunks.length,
          },
        });
      }
    } else {
      chunks.push({
        id: `chunk-${chunks.length}`,
        content: `## ${heading}\n\n${content}`,
        metadata: {
          source: "",
          section: heading,
          chunkIndex: chunks.length,
        },
      });
    }
  }

  return chunks;
}
Embedding e indexación
Los embeddings convierten texto en vectores densos que capturan el significado semántico. Los textos similares producen vectores cercanos entre sí dentro del espacio de embeddings.
import { OpenAI } from "openai";

const openai = new OpenAI();

async function generateEmbeddings(
  texts: string[]
): Promise<number[][]> {
  // Batch embedding for efficiency
  const batchSize = 100;
  const allEmbeddings: number[][] = [];

  for (let i = 0; i < texts.length; i += batchSize) {
    const batch = texts.slice(i, i + batchSize);
    const response = await openai.embeddings.create({
      model: "text-embedding-3-small",
      input: batch,
    });

    allEmbeddings.push(
      ...response.data.map((d) => d.embedding)
    );
  }

  return allEmbeddings;
}

async function indexDocuments(
  chunks: Chunk[]
): Promise<void> {
  const texts = chunks.map((c) => c.content);
  const embeddings = await generateEmbeddings(texts);

  // Store in vector database (using pgvector example)
  for (let i = 0; i < chunks.length; i++) {
    await db.query(
      `INSERT INTO document_chunks
       (id, content, embedding, metadata)
       VALUES ($1, $2, $3, $4)`,
      [
        chunks[i].id,
        chunks[i].content,
        JSON.stringify(embeddings[i]),
        JSON.stringify(chunks[i].metadata),
      ]
    );
  }

  console.log(
    `Indexed ${chunks.length} chunks with embeddings`
  );
}
Recuperación con búsqueda híbrida
La búsqueda vectorial pura pasa por alto coincidencias exactas de palabras clave. La búsqueda por palabras clave pura pasa por alto la similitud semántica. Combina ambas para obtener mejores resultados.
interface SearchResult {
  chunk: Chunk;
  score: number;
  matchType: "vector" | "keyword" | "hybrid";
}

async function hybridSearch(
  query: string,
  topK: number = 5
): Promise<SearchResult[]> {
  // Vector search
  const queryEmbedding = await generateEmbeddings([
    query,
  ]);
  const vectorResults = await db.query(
    `SELECT id, content, metadata,
            1 - (embedding <=> $1) as similarity
     FROM document_chunks
     ORDER BY embedding <=> $1
     LIMIT $2`,
    [JSON.stringify(queryEmbedding[0]), topK * 2]
  );

  // Full-text search
  const keywordResults = await db.query(
    `SELECT id, content, metadata,
            ts_rank(search_vector, plainto_tsquery($1)) as rank
     FROM document_chunks
     WHERE search_vector @@ plainto_tsquery($1)
     ORDER BY rank DESC
     LIMIT $2`,
    [query, topK * 2]
  );

  // Reciprocal Rank Fusion to combine results
  const scores = new Map<string, number>();

  vectorResults.rows.forEach(
    (row: { id: string }, idx: number) => {
      const rrf = 1 / (60 + idx + 1);
      scores.set(
        row.id,
        (scores.get(row.id) ?? 0) + rrf
      );
    }
  );

  keywordResults.rows.forEach(
    (row: { id: string }, idx: number) => {
      const rrf = 1 / (60 + idx + 1);
      scores.set(
        row.id,
        (scores.get(row.id) ?? 0) + rrf
      );
    }
  );

  // Sort by combined score and return top K
  const sorted = [...scores.entries()]
    .sort((a, b) => b[1] - a[1])
    .slice(0, topK);

  const allResults = [
    ...vectorResults.rows,
    ...keywordResults.rows,
  ];
  const resultMap = new Map(
    allResults.map((r: { id: string }) => [r.id, r])
  );

  return sorted.map(([id, score]) => ({
    chunk: resultMap.get(id) as unknown as Chunk,
    score,
    matchType: "hybrid" as const,
  }));
}
Construcción de prompts con citas
El prompt debe indicarle al modelo que base sus respuestas en el contexto recuperado y que cite las fuentes. La estructura importa.
function buildPrompt(
  query: string,
  results: SearchResult[]
): string {
  const context = results
    .map(
      (r, i) =>
        `[Source ${i + 1}: ${r.chunk.metadata.source}, ` +
        `Section: ${r.chunk.metadata.section}]\n` +
        `${r.chunk.content}`
    )
    .join("\n\n---\n\n");

  return `You are a helpful assistant that answers questions
based on the provided context. Follow these rules:

1. Only use information from the provided context
2. If the context doesn't contain enough information,
   say "I don't have enough information to answer that"
3. Cite sources using [Source N] notation
4. Be specific and concise

Context:
${context}

Question: ${query}

Answer (cite sources):`;
}

// Full pipeline
async function answerQuestion(
  query: string
): Promise<{
  answer: string;
  sources: SearchResult[];
}> {
  const results = await hybridSearch(query, 5);

  if (results.length === 0) {
    return {
      answer:
        "I couldn't find relevant information " +
        "to answer that question.",
      sources: [],
    };
  }

  const prompt = buildPrompt(query, results);

  const response = await openai.chat.completions.create(
    {
      model: "gpt-4o-mini",
      messages: [{ role: "user", content: prompt }],
      temperature: 0.1,
      max_tokens: 1000,
    }
  );

  return {
    answer: response.choices[0].message.content ?? "",
    sources: results,
  };
}
Evaluación: cómo medir la calidad de un RAG
Un pipeline RAG es tan bueno como su recuperación. Mide la calidad de la recuperación y la calidad de la generación por separado.
interface EvalResult {
  query: string;
  retrievalPrecision: number;
  retrievalRecall: number;
  answerRelevance: number;
  faithfulness: number;
}

async function evaluateRAG(
  testCases: {
    query: string;
    expectedChunkIds: string[];
    expectedAnswer: string;
  }[]
): Promise<EvalResult[]> {
  const results: EvalResult[] = [];

  for (const testCase of testCases) {
    const searchResults = await hybridSearch(
      testCase.query,
      5
    );
    const retrievedIds = searchResults.map(
      (r) => r.chunk.id
    );

    // Retrieval precision: how many retrieved docs
    // are relevant?
    const relevantRetrieved = retrievedIds.filter((id) =>
      testCase.expectedChunkIds.includes(id)
    ).length;
    const precision =
      relevantRetrieved / retrievedIds.length;

    // Retrieval recall: how many relevant docs
    // were retrieved?
    const recall =
      relevantRetrieved /
      testCase.expectedChunkIds.length;

    // Generate answer and evaluate
    const { answer } = await answerQuestion(
      testCase.query
    );

    results.push({
      query: testCase.query,
      retrievalPrecision: precision,
      retrievalRecall: recall,
      answerRelevance: 0, // Score with LLM judge
      faithfulness: 0,    // Compare to sources
    });
  }

  return results;
}
Conclusiones clave
La estrategia de chunking determina la calidad de la recuperación: un chunking semántico que respeta la estructura del documento (encabezados, párrafos, secciones) supera de forma consistente al chunking de tamaño fijo, porque preserva dentro de cada chunk el contexto necesario para responder las preguntas. La búsqueda híbrida, que combina similitud vectorial y coincidencia de palabras clave mediante reciprocal rank fusion, recupera resultados más relevantes que cualquiera de los dos enfoques por separado, capturando tanto las coincidencias semánticas que la búsqueda por palabras clave pasa por alto como las coincidencias de términos exactos que la similitud de embeddings pasa por alto. La construcción de prompts debe indicarle explícitamente al modelo que base sus respuestas únicamente en el contexto proporcionado y que cite las fuentes, porque sin estas restricciones el modelo mezclará la información recuperada con su conocimiento paramétrico y producirá respuestas que suenan fundamentadas pero contienen detalles alucinados. Evalúa la recuperación y la generación por separado usando métricas de precisión, exhaustividad (recall) y fidelidad sobre un conjunto de prueba curado: un pipeline con mala calidad de recuperación nunca producirá buenas respuestas, sin importar el modelo de generación que se use.