Construir sistemas RAG que funcionen de verdad
Guía práctica para sistemas RAG de producción con respuestas fundamentadas: embeddings, bases vectoriales, chunking, reranking y evaluación.

Por qué RAG supera al fine-tuning en la mayoría de los casos de uso
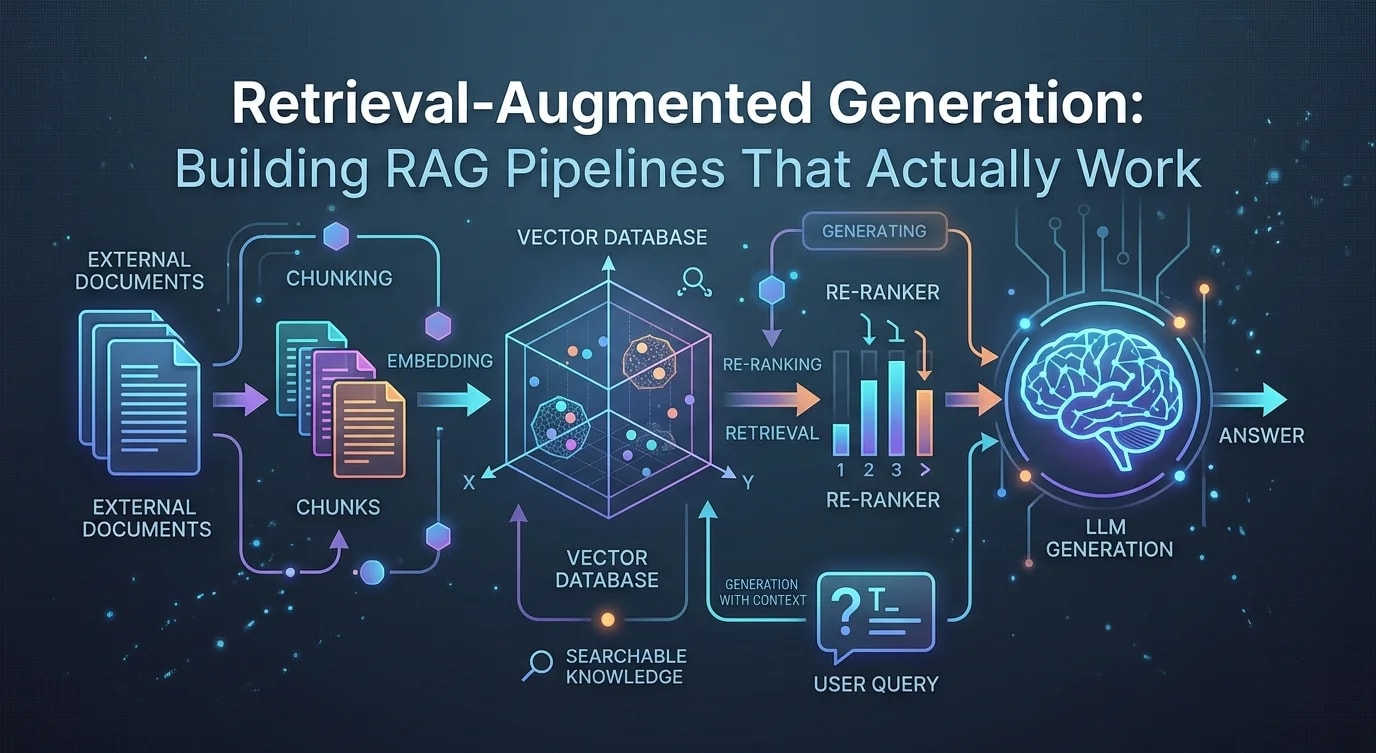
Hacer fine-tuning de un LLM con tus datos graba el conocimiento en los pesos del modelo. Esto es caro, lento de actualizar e imposible de auditar. RAG mantiene el conocimiento externo en un índice consultable, alimentando contexto relevante al LLM en el momento de la consulta. Puedes actualizar la base de conocimiento sin reentrenar, rastrear cada respuesta hasta sus documentos fuente y controlar a qué información puede acceder el modelo.
Pero el RAG ingenuo —convertir documentos en embeddings, recuperar el top-K, meterlo en el prompt— falla en producción. Construir uno que funcione requiere atención cuidadosa en cada etapa del pipeline.
Estrategias de chunking de documentos
Cómo divides los documentos determina si el paso de recuperación encuentra contexto relevante o devuelve fragmentos que confunden al LLM.
interface Chunk {
  id: string;
  content: string;
  metadata: {
    source: string;
    section: string;
    pageNumber?: number;
    chunkIndex: number;
    tokenCount: number;
  };
}

// ❌ Fixed-size chunking — splits mid-sentence, loses context
function naiveChunk(text: string, maxChars: number): string[] {
  const chunks: string[] = [];
  for (let i = 0; i < text.length; i += maxChars) {
    chunks.push(text.slice(i, i + maxChars));
  }
  return chunks;
}

// ✅ Semantic chunking — respects document structure
function semanticChunk(
  text: string,
  options: {
    maxTokens: number;
    overlapTokens: number;
    separators: string[];
  }
): Chunk[] {
  const { maxTokens, overlapTokens, separators } = options;
  const chunks: Chunk[] = [];

  // Split by strongest separator first
  let sections = [text];
  for (const separator of separators) {
    sections = sections.flatMap((section) =>
      section.split(separator).filter((s) => s.trim())
    );
  }

  let currentChunk = "";
  let chunkIndex = 0;

  for (const section of sections) {
    const sectionTokens = estimateTokens(section);

    if (estimateTokens(currentChunk) + sectionTokens > maxTokens) {
      if (currentChunk.trim()) {
        chunks.push({
          id: `chunk-${chunkIndex}`,
          content: currentChunk.trim(),
          metadata: {
            source: "",
            section: extractHeading(currentChunk),
            chunkIndex,
            tokenCount: estimateTokens(currentChunk),
          },
        });
        chunkIndex++;

        // Keep overlap for context continuity
        const words = currentChunk.split(/\s+/);
        const overlapWords = words.slice(-overlapTokens);
        currentChunk = overlapWords.join(" ") + "\n" + section;
      }
    } else {
      currentChunk += "\n" + section;
    }
  }

  if (currentChunk.trim()) {
    chunks.push({
      id: `chunk-${chunkIndex}`,
      content: currentChunk.trim(),
      metadata: {
        source: "",
        section: extractHeading(currentChunk),
        chunkIndex,
        tokenCount: estimateTokens(currentChunk),
      },
    });
  }

  return chunks;
}
La jerarquía de separadores importa: divide primero por encabezados, luego por párrafos y después por oraciones. El solapamiento entre chunks asegura que el contexto que cruza un límite no se pierda. Para documentación de código, trata las definiciones de funciones y los límites de clases como separadores primarios.
Embeddings e indexación
La calidad de los embeddings determina la calidad de la recuperación. La elección entre modelos de embeddings importa menos que cómo preparas el texto antes de generar el embedding.
interface EmbeddingConfig {
  model: string;
  dimensions: number;
  maxInputTokens: number;
  batchSize: number;
}

class DocumentIndexer {
  constructor(
    private readonly embedder: EmbeddingService,
    private readonly vectorStore: VectorStore,
    private readonly config: EmbeddingConfig
  ) {}

  async indexDocuments(documents: Document[]): Promise<IndexResult> {
    let totalChunks = 0;
    let totalTokens = 0;

    for (const doc of documents) {
      const chunks = semanticChunk(doc.content, {
        maxTokens: this.config.maxInputTokens,
        overlapTokens: 50,
        separators: ["\n## ", "\n### ", "\n\n", ". "],
      });

      // Enrich chunks with document-level metadata
      const enrichedChunks = chunks.map((chunk) => ({
        ...chunk,
        content: this.enrichContent(chunk, doc),
        metadata: {
          ...chunk.metadata,
          source: doc.source,
          documentTitle: doc.title,
          lastUpdated: doc.updatedAt,
        },
      }));

      // Batch embed for efficiency
      for (let i = 0; i < enrichedChunks.length; i += this.config.batchSize) {
        const batch = enrichedChunks.slice(i, i + this.config.batchSize);
        const embeddings = await this.embedder.embed(
          batch.map((c) => c.content)
        );

        await this.vectorStore.upsert(
          batch.map((chunk, idx) => ({
            id: chunk.id,
            vector: embeddings[idx],
            metadata: chunk.metadata,
            content: chunk.content,
          }))
        );
      }

      totalChunks += enrichedChunks.length;
      totalTokens += enrichedChunks.reduce(
        (sum, c) => sum + c.metadata.tokenCount,
        0
      );
    }

    return { totalChunks, totalTokens };
  }

  private enrichContent(chunk: Chunk, doc: Document): string {
    // Prepend document context for better embeddings
    return `Document: ${doc.title}\nSection: ${chunk.metadata.section}\n\n${chunk.content}`;
  }
}
Recuperación y reranking
La búsqueda por similitud vectorial devuelve los K chunks más similares, pero similitud no es relevancia. Un paso de reranking puntúa los chunks recuperados contra la consulta real usando un cross-encoder, que es más preciso que la similitud de embeddings por sí sola.
interface RetrievalResult {
  chunks: ScoredChunk[];
  query: string;
  retrievalTimeMs: number;
}

interface ScoredChunk {
  chunk: Chunk;
  similarityScore: number;
  rerankScore?: number;
  finalScore: number;
}

class RAGRetriever {
  constructor(
    private readonly vectorStore: VectorStore,
    private readonly reranker: Reranker,
    private readonly config: {
      initialK: number;    // Retrieve more candidates
      finalK: number;      // Return fewer, better results
      similarityThreshold: number;
    }
  ) {}

  async retrieve(query: string): Promise<RetrievalResult> {
    const start = Date.now();

    // Stage 1: Broad retrieval via vector similarity
    const candidates = await this.vectorStore.search(
      query,
      this.config.initialK
    );

    // Filter by minimum similarity
    const filtered = candidates.filter(
      (c) => c.score >= this.config.similarityThreshold
    );

    // Stage 2: Rerank with cross-encoder
    const reranked = await this.reranker.rank(
      query,
      filtered.map((c) => c.content)
    );

    // Combine scores and take top-K
    const scored: ScoredChunk[] = filtered
      .map((candidate, idx) => ({
        chunk: candidate.chunk,
        similarityScore: candidate.score,
        rerankScore: reranked[idx].score,
        finalScore: 0.3 * candidate.score + 0.7 * reranked[idx].score,
      }))
      .sort((a, b) => b.finalScore - a.finalScore)
      .slice(0, this.config.finalK);

    return {
      chunks: scored,
      query,
      retrievalTimeMs: Date.now() - start,
    };
  }
}
Construcción del prompt y generación
El prompt final debe separar claramente el contexto recuperado de la pregunta del usuario. El LLM necesita instrucciones sobre cómo manejar fuentes contradictorias, información faltante y los límites de lo que debe responder.
function buildRAGPrompt(
  query: string,
  retrievedChunks: ScoredChunk[],
  conversationHistory: Message[]
): string {
  const context = retrievedChunks
    .map(
      (chunk, idx) =>
        `[Source ${idx + 1}: ${chunk.chunk.metadata.source}]\n${chunk.chunk.content}`
    )
    .join("\n\n---\n\n");

  return `You are a helpful assistant. Answer the user's question based ONLY on the provided context. If the context does not contain enough information to answer, say so explicitly. Do not make up information.

If multiple sources contradict each other, note the discrepancy and present both perspectives.

## Context
${context}

## Conversation History
${conversationHistory.map((m) => `${m.role}: ${m.content}`).join("\n")}

## Current Question
${query}

## Instructions
- Cite sources using [Source N] notation
- If the answer requires information not in the context, state what is missing
- Be concise and direct`;
}
Evaluación y métricas de calidad
No puedes mejorar lo que no mides. Los sistemas RAG necesitan evaluación en dos ejes: calidad de recuperación (¿el sistema encontró los chunks correctos?) y calidad de generación (¿el LLM produjo una respuesta correcta y fundamentada?).
interface RAGEvaluation {
  retrievalMetrics: {
    precision: number;    // Relevant chunks / retrieved chunks
    recall: number;       // Retrieved relevant / total relevant
    mrr: number;          // Mean Reciprocal Rank
  };
  generationMetrics: {
    faithfulness: number; // Is every claim supported by context?
    relevance: number;    // Does the answer address the question?
    completeness: number; // Are all relevant aspects covered?
  };
}

async function evaluateRAG(
  testCases: Array<{
    query: string;
    expectedChunkIds: string[];
    expectedAnswer: string;
  }>,
  retriever: RAGRetriever,
  generator: RAGGenerator
): Promise<RAGEvaluation> {
  let totalPrecision = 0;
  let totalRecall = 0;
  let totalMRR = 0;

  for (const testCase of testCases) {
    const result = await retriever.retrieve(testCase.query);
    const retrievedIds = result.chunks.map((c) => c.chunk.id);

    const relevant = retrievedIds.filter((id) =>
      testCase.expectedChunkIds.includes(id)
    );

    totalPrecision += relevant.length / retrievedIds.length;
    totalRecall += relevant.length / testCase.expectedChunkIds.length;

    // MRR: position of first relevant result
    const firstRelevantIdx = retrievedIds.findIndex((id) =>
      testCase.expectedChunkIds.includes(id)
    );
    totalMRR += firstRelevantIdx >= 0 ? 1 / (firstRelevantIdx + 1) : 0;
  }

  const n = testCases.length;

  return {
    retrievalMetrics: {
      precision: totalPrecision / n,
      recall: totalRecall / n,
      mrr: totalMRR / n,
    },
    generationMetrics: {
      faithfulness: 0, // Requires LLM-as-judge evaluation
      relevance: 0,
      completeness: 0,
    },
  };
}
Conclusiones clave
Los sistemas RAG de producción fallan cuando una sola etapa es débil. El chunking determina si el contexto relevante es recuperable. La calidad de los embeddings depende más de la preparación de la entrada que de la elección del modelo. El reranking es la mejora individual de mayor impacto: convierte la similitud amplia en relevancia precisa.
Construye el arnés de evaluación antes de optimizar cualquier otra cosa. Sin casos de prueba de referencia que midan la precisión de recuperación, el recall y la fidelidad de la generación, cada cambio es una apuesta. Empieza con un conjunto de pruebas pequeño y de alta calidad, y amplíalo a medida que surjan modos de fallo.
El prompt es el contrato entre la recuperación y la generación. Debe delimitar claramente el contexto de las instrucciones, decirle al modelo cuándo negarse a responder y exigir citas de fuentes. Un prompt bien estructurado con una recuperación mediocre supera siempre a un prompt pobre con una recuperación excelente.