Cómo construir pipelines RAG que funcionen de verdad
Guía práctica para sistemas RAG fiables: chunking, modelos de embeddings, almacenes vectoriales y los patrones que separan un prototipo de producción.
La brecha entre las demos de RAG y RAG en producción
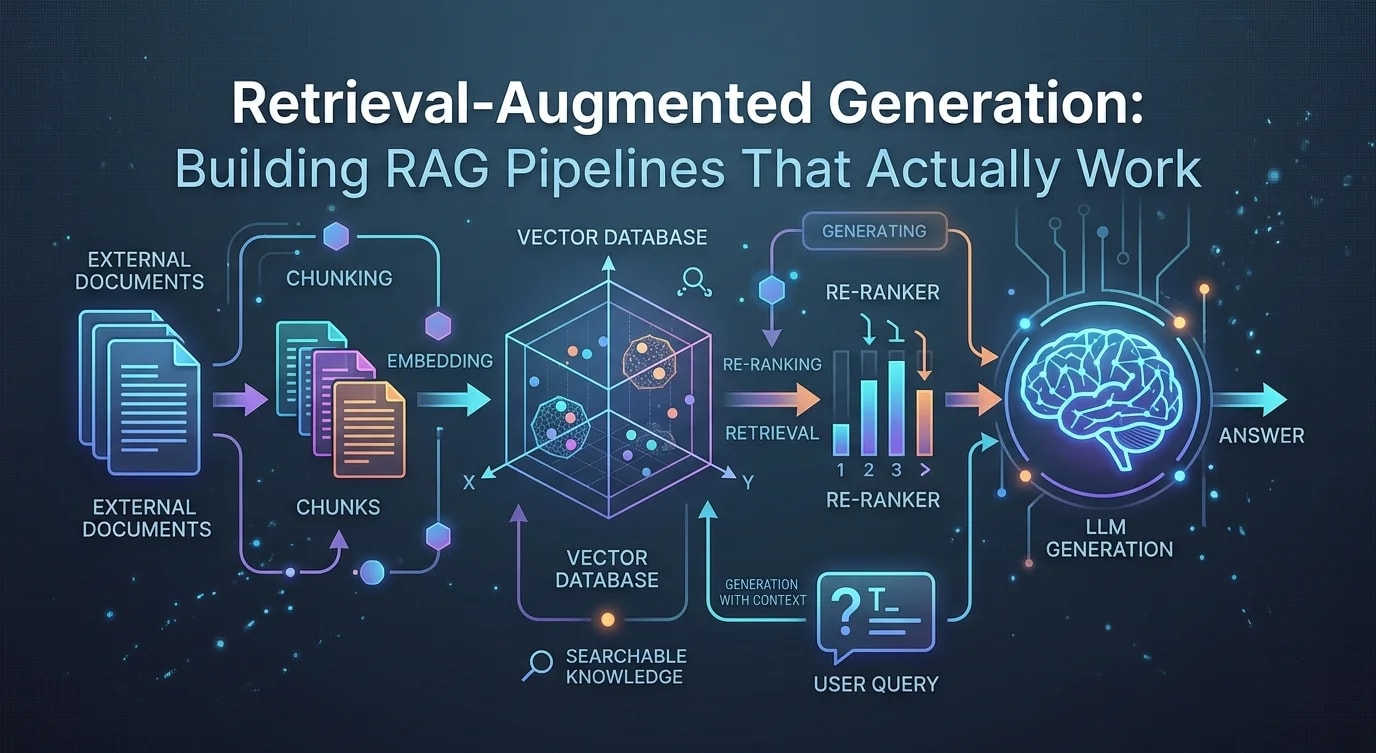
Todos los tutoriales de RAG siguen el mismo guion: cargar los documentos, dividirlos, generar sus embeddings, guardarlos en una base de datos vectorial, recuperarlos al consultar y pasárselos a un LLM. La demo funciona. Haces una pregunta, el modelo cita tus documentos y todo parece magia.
Luego la despliegas con datos reales. El modelo alucina respuestas que suenan plausibles pero que no aparecen en tus documentos. Recupera chunks irrelevantes. Pasa por alto respuestas obvias porque el texto relevante quedó dividido entre dos chunks. La demo mágica se desmorona.
La diferencia entre un prototipo de RAG que funciona y un sistema de RAG en producción está en los detalles: cómo se fragmenta el contenido en chunks, qué se convierte en embeddings, cómo se recupera y cómo se verifica la salida. Esta guía cubre cada una de esas capas.
Chunking: la base que todo el mundo hace mal
El chunking es el paso más infravalorado del pipeline de RAG. La mayoría de los tutoriales usan una división de tamaño fijo por caracteres y siguen adelante. Pero la calidad de los chunks determina directamente la calidad de la recuperación, que a su vez determina la calidad de la respuesta.
# ❌ Bad: Fixed-size splitting ignores document structure
from langchain.text_splitter import CharacterTextSplitter

splitter = CharacterTextSplitter(
    chunk_size=1000,
    chunk_overlap=0,  # No overlap means lost context at boundaries
    separator="\n"
)
chunks = splitter.split_text(document)# ✅ Good: Recursive splitting with overlap and metadata preservation
from langchain.text_splitter import RecursiveCharacterTextSplitter
splitter = RecursiveCharacterTextSplitter(
chunk_size=512,
chunk_overlap=64,
separators=["\n\n", "\n", ". ", " ", ""],
length_function=len,
)
def chunk_with_metadata(
text: str,
source: str,
doc_type: str
) -> list[dict]:
chunks = splitter.split_text(text)
return [
{
"text": chunk,
"metadata": {
"source": source,
"doc_type": doc_type,
"chunk_index": i,
"total_chunks": len(chunks),
},
}
for i, chunk in enumerate(chunks)
]El splitter recursivo intenta dividir primero por límites de párrafo, luego por frases y después por palabras. Esto preserva la coherencia semántica dentro de cada chunk. El solapamiento de 64 caracteres garantiza que las frases que quedan a caballo entre dos chunks aparezcan en ambos.
El tamaño del chunk importa más de lo que la mayoría cree. Los chunks más pequeños (256-512 tokens) producen una recuperación más precisa, pero pierden contexto. Los chunks más grandes (1024-2048 tokens) conservan el contexto, pero diluyen las puntuaciones de relevancia. El punto óptimo depende de los patrones de consulta de tu caso de uso.
Estrategia de embeddings: más allá de los modelos por defecto
El modelo de embeddings es el motor de tu recuperación. Convierte el texto en vectores densos que capturan el significado semántico. La calidad de esos vectores determina si los chunks relevantes acaban cerca de tu consulta en el espacio vectorial.
from openai import OpenAI
import numpy as np

client = OpenAI()

def embed_texts(texts: list[str], model: str = "text-embedding-3-small") -> list[list[float]]:
    response = client.embeddings.create(
        input=texts,
        model=model,
    )
    return [item.embedding for item in response.data]


def cosine_similarity(a: list[float], b: list[float]) -> float:
    a_arr = np.array(a)
    b_arr = np.array(b)
    return float(np.dot(a_arr, b_arr) / (np.linalg.norm(a_arr) * np.linalg.norm(b_arr)))


# Batch embedding for efficiency
def embed_document_chunks(
    chunks: list[dict],
    batch_size: int = 100
) -> list[dict]:
    all_texts = [c["text"] for c in chunks]
    all_embeddings = []

    for i in range(0, len(all_texts), batch_size):
        batch = all_texts[i : i + batch_size]
        embeddings = embed_texts(batch)
        all_embeddings.extend(embeddings)

    for chunk, embedding in zip(chunks, all_embeddings):
        chunk["embedding"] = embedding

    return chunks
Agrupa tus solicitudes de embeddings en lotes. Generar los embeddings de un chunk a la vez añade una latencia enorme y cuesta más debido a la sobrecarga de cada solicitud individual. Procesa en lotes de 100 a 500 según los límites de tasa de tu proveedor.
Integración e indexación del almacén vectorial
Una vez que tienes los embeddings, necesitas un almacén vectorial que soporte una búsqueda eficiente de vecinos más cercanos aproximados. La elección entre Pinecone, Weaviate, Qdrant, Chroma y pgvector depende de tu escala y de tus requisitos operativos.
from qdrant_client import QdrantClient
from qdrant_client.models import (
    Distance,
    PointStruct,
    VectorParams,
    Filter,
    FieldCondition,
    MatchValue,
)
import uuid

client = QdrantClient(url="http://localhost:6333")

COLLECTION_NAME = "documents"
VECTOR_SIZE = 1536  # text-embedding-3-small dimension


def initialize_collection() -> None:
    client.recreate_collection(
        collection_name=COLLECTION_NAME,
        vectors_config=VectorParams(
            size=VECTOR_SIZE,
            distance=Distance.COSINE,
        ),
    )


def upsert_chunks(chunks: list[dict]) -> None:
    points = [
        PointStruct(
            id=str(uuid.uuid4()),
            vector=chunk["embedding"],
            payload={
                "text": chunk["text"],
                **chunk["metadata"],
            },
        )
        for chunk in chunks
    ]

    client.upsert(
        collection_name=COLLECTION_NAME,
        points=points,
    )


def search_similar(
    query_embedding: list[float],
    doc_type: str | None = None,
    top_k: int = 5,
) -> list[dict]:
    search_filter = None
    if doc_type:
        search_filter = Filter(
            must=[
                FieldCondition(
                    key="doc_type",
                    match=MatchValue(value=doc_type),
                )
            ]
        )

    results = client.search(
        collection_name=COLLECTION_NAME,
        query_vector=query_embedding,
        query_filter=search_filter,
        limit=top_k,
    )

    return [
        {
            "text": hit.payload["text"],
            "score": hit.score,
            "source": hit.payload.get("source", ""),
        }
        for hit in results
    ]
El filtrado por metadatos es crucial. Si tus documentos abarcan varias categorías, departamentos o periodos de tiempo, filtrar por metadatos antes de la búsqueda vectorial mejora drásticamente la precisión. Una consulta sobre las finanzas del Q3 no debería recuperar documentos de marketing del Q1, aunque sean semánticamente similares.
Patrones de recuperación: búsqueda híbrida y reranking
La búsqueda vectorial pura pasa por alto las coincidencias exactas de palabras clave. La búsqueda por palabras clave pura pasa por alto las conexiones semánticas. La búsqueda híbrida combina ambas para lograr un mejor recall.
from qdrant_client.models import SearchParams

def hybrid_search(
    query: str,
    query_embedding: list[float],
    top_k: int = 10,
    rerank_top_k: int = 5,
) -> list[dict]:
    # Step 1: Vector search for semantic matches
    vector_results = search_similar(query_embedding, top_k=top_k)

    # Step 2: Keyword search for exact matches
    keyword_results = client.scroll(
        collection_name=COLLECTION_NAME,
        scroll_filter=Filter(
            must=[
                FieldCondition(
                    key="text",
                    match=MatchValue(value=query),
                )
            ]
        ),
        limit=top_k,
    )[0]

    # Step 3: Merge and deduplicate
    seen_texts = set()
    combined = []
    for result in vector_results:
        if result["text"] not in seen_texts:
            seen_texts.add(result["text"])
            combined.append(result)

    for point in keyword_results:
        text = point.payload["text"]
        if text not in seen_texts:
            seen_texts.add(text)
            combined.append({
                "text": text,
                "score": 0.5,
                "source": point.payload.get("source", ""),
            })

    # Step 4: Rerank with cross-encoder
    return rerank_results(query, combined[:rerank_top_k])
Aplicar reranking con un cross-encoder es la mejora de mayor impacto que puedes hacerle a un pipeline de RAG. La búsqueda vectorial usa bi-encoders: rápidos pero aproximados. Los cross-encoders procesan la consulta y el documento juntos, lo que produce puntuaciones de relevancia mucho más precisas a costa de la velocidad.
from sentence_transformers import CrossEncoder

reranker = CrossEncoder("cross-encoder/ms-marco-MiniLM-L-6-v2")


def rerank_results(
    query: str,
    results: list[dict],
) -> list[dict]:
    if not results:
        return []

    pairs = [(query, r["text"]) for r in results]
    scores = reranker.predict(pairs)

    for result, score in zip(results, scores):
        result["rerank_score"] = float(score)

    return sorted(results, key=lambda x: x["rerank_score"], reverse=True)
Construcción del prompt: gestión de la ventana de contexto
Los chunks recuperados deben ensamblarse en un prompt que le dé al LLM suficiente contexto para responder con precisión, sin superar la ventana de contexto ni diluir el foco.
from openai import OpenAI

client = OpenAI()


def build_rag_prompt(
    query: str,
    retrieved_chunks: list[dict],
    max_context_tokens: int = 3000,
) -> list[dict]:
    context_parts = []
    estimated_tokens = 0

    for chunk in retrieved_chunks:
        chunk_tokens = len(chunk["text"].split()) * 1.3
        if estimated_tokens + chunk_tokens > max_context_tokens:
            break
        context_parts.append(
            f"[Source: {chunk['source']}]\n{chunk['text']}"
        )
        estimated_tokens += chunk_tokens

    context = "\n\n---\n\n".join(context_parts)

    return [
        {
            "role": "system",
            "content": (
                "You are a helpful assistant that answers questions based on "
                "the provided context. If the context does not contain enough "
                "information to answer the question, say so explicitly. "
                "Do not make up information. Cite sources when possible."
            ),
        },
        {
            "role": "user",
            "content": f"Context:\n{context}\n\nQuestion: {query}",
        },
    ]


def query_rag(query: str) -> str:
    query_embedding = embed_texts([query])[0]
    chunks = hybrid_search(query, query_embedding, top_k=10, rerank_top_k=5)
    messages = build_rag_prompt(query, chunks)

    response = client.chat.completions.create(
        model="gpt-4o",
        messages=messages,
        temperature=0.1,
    )

    return response.choices[0].message.content or ""
Una temperatura baja (0.1-0.2) reduce las alucinaciones en las respuestas de RAG. El system prompt le indica explícitamente al modelo que reconozca las lagunas de conocimiento en lugar de inventar respuestas: esto no es negociable en sistemas de producción.
Evaluación: cómo medir la calidad de un sistema RAG
No puedes mejorar lo que no puedes medir. Evaluar un sistema RAG requiere poner a prueba tres dimensiones: la calidad de la recuperación (¿estás encontrando los chunks correctos?), la calidad de la generación (¿la respuesta es correcta?) y la fidelidad (¿la respuesta se mantiene anclada en el contexto recuperado?).
def evaluate_retrieval(
    test_cases: list[dict],
) -> dict:
    metrics = {"recall_at_5": [], "mrr": []}

    for case in test_cases:
        query_embedding = embed_texts([case["query"]])[0]
        results = search_similar(query_embedding, top_k=5)
        retrieved_sources = [r["source"] for r in results]

        relevant = case["relevant_sources"]
        hits = [s for s in retrieved_sources if s in relevant]

        recall = len(hits) / len(relevant) if relevant else 0
        metrics["recall_at_5"].append(recall)

        for rank, source in enumerate(retrieved_sources, 1):
            if source in relevant:
                metrics["mrr"].append(1.0 / rank)
                break
        else:
            metrics["mrr"].append(0.0)

    return {
        "mean_recall_at_5": sum(metrics["recall_at_5"]) / len(metrics["recall_at_5"]),
        "mean_mrr": sum(metrics["mrr"]) / len(metrics["mrr"]),
    }
Construye un conjunto de prueba de 50 a 100 pares de pregunta-respuesta con documentos fuente conocidos. Ejecuta la evaluación de recuperación después de cada cambio en tu estrategia de chunking, tu modelo de embeddings o tus parámetros de búsqueda. Una mejora del 5% en el recall@5 puede traducirse en una experiencia de usuario drásticamente mejor.
Puntos clave
RAG no es una técnica aislada: es un pipeline, y cada etapa acumula calidad o errores. Fragmenta con límites semánticos y solapamiento. Agrupa tus embeddings en lotes. Filtra por metadatos antes de la búsqueda vectorial. Aplica reranking con cross-encoders. Mantén las temperaturas bajas y los system prompts estrictos.
La brecha entre una demo de RAG y un producto de RAG es la medición. Sin evaluación de recuperación ni verificaciones de fidelidad, vuelas a ciegas. Construye tu conjunto de prueba desde el principio, automatiza tu pipeline de evaluación y deja que las métricas guíen cada decisión de arquitectura.