Inteligencia Artificial
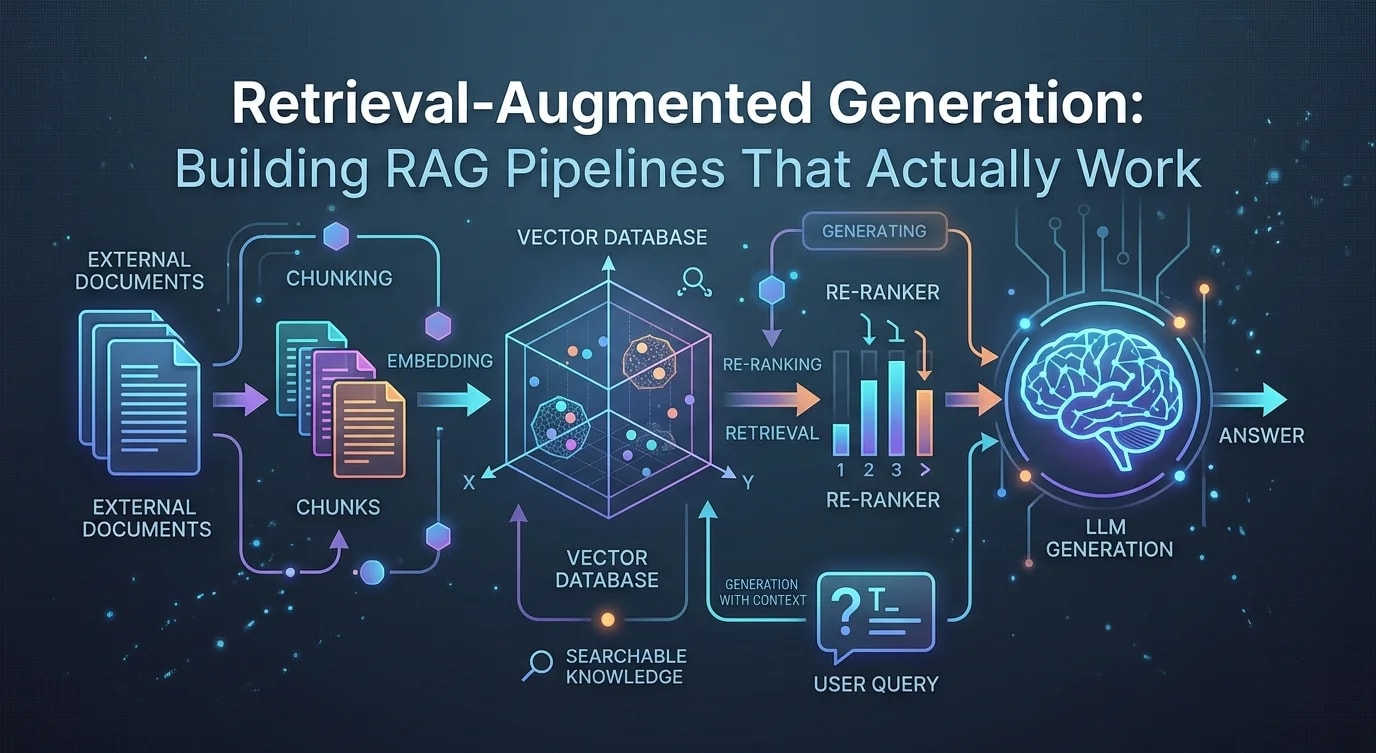
RAG en producción: de la recuperación a respuestas precisas
Construye pipelines RAG de producción que recuperan contexto real y responden con precisión: chunking, embeddings, búsqueda vectorial y re-ranking.
·4 min de lectura
Etiquetas
8 artículos
Construye pipelines RAG de producción que recuperan contexto real y responden con precisión: chunking, embeddings, búsqueda vectorial y re-ranking.

Guía práctica para sistemas RAG de producción con respuestas fundamentadas: embeddings, bases vectoriales, chunking, reranking y evaluación.
Guía práctica para sistemas RAG fiables: chunking, modelos de embeddings, almacenes vectoriales y los patrones que separan un prototipo de producción.

Construye pipelines RAG eficaces en TypeScript: chunking de documentos, embeddings, ajuste de búsqueda vectorial, prompts y evaluación de la recuperación.
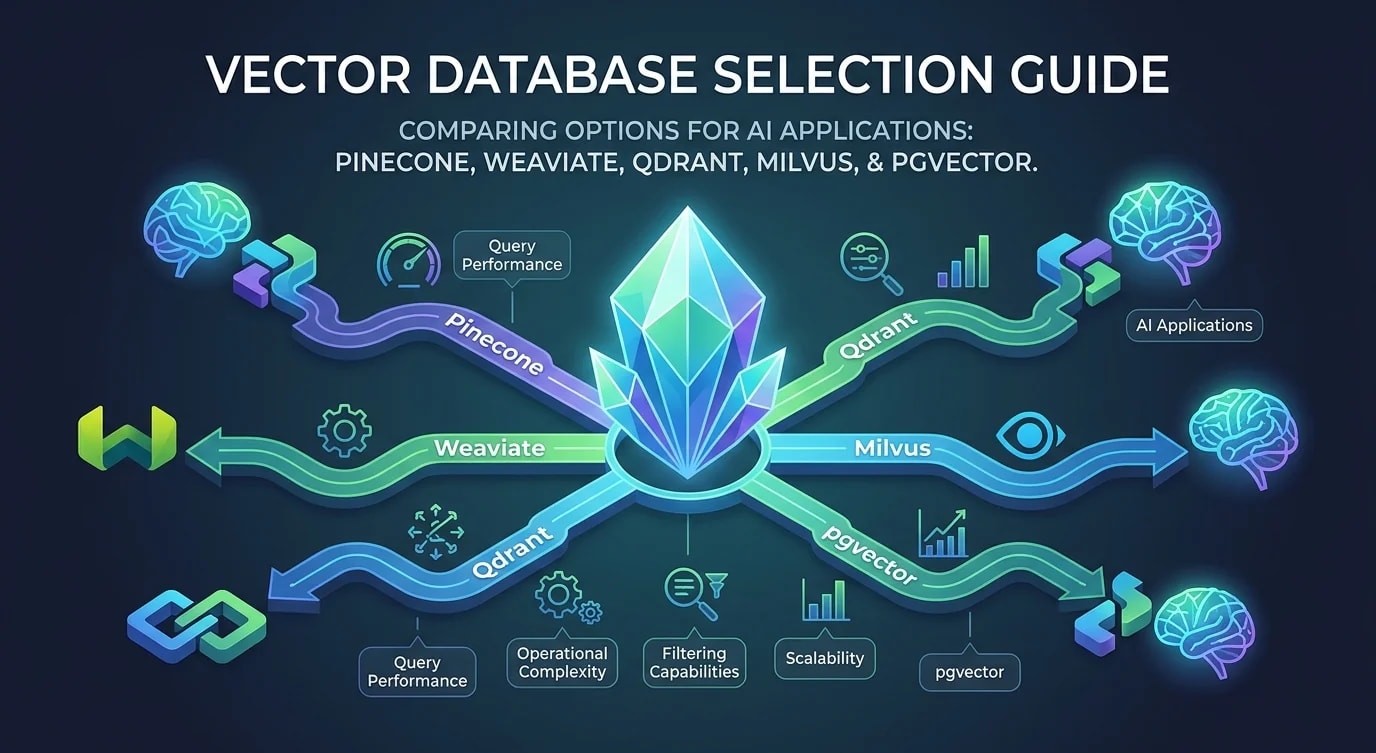
Compara Pinecone, Weaviate, Qdrant, Milvus y pgvector para IA: estrategias de indexación, rendimiento, filtrado y complejidad operativa.

Diseña pipelines RAG que superen la fase de demo: estrategias de chunking, optimización de embeddings, reranking y métricas de evaluación.

Guía práctica de bases de datos vectoriales para búsqueda por similitud: embeddings, indexación, métricas de distancia y cuándo elegir cada opción.

Cómo crear pipelines de NLP listos para producción: preprocesamiento, tokenización, embeddings, clasificación y extracción de entidades.