Desarrollo orientado a la observabilidad
Adelanta la observabilidad diseñando con logs estructurados, trazas distribuidas y métricas útiles desde el inicio: depuras antes y los incidentes duran menos.

La observabilidad no es monitoreo
Monitoreo te dice cuándo algo está mal. Observabilidad te dice por qué. El monitoreo revisa modos de fallo conocidos con umbrales predefinidos. La observabilidad te permite hacer preguntas arbitrarias sobre el comportamiento del sistema sin desplegar código nuevo.
La distinción importa porque los sistemas distribuidos modernos fallan de maneras novedosas. No puedes predecir todos los modos de fallo de antemano, pero sí puedes instrumentar tu sistema para que, cuando ocurra algo inesperado, puedas rastrear la causa en minutos en lugar de horas.
Logging estructurado que escala
Los logs no estructurados son archivos de texto sobre los que puedes hacer grep. Los logs estructurados son eventos consultables con campos tipados, IDs de correlación y metadatos contextuales que hacen posible depurar a través de servicios.
// ❌ Unstructured logging — nearly useless at scale
console.log(`User ${userId} failed to checkout: ${error.message}`);

// ✅ Structured logging — queryable, correlatable, actionable
import { Logger } from "./logger";

interface LogContext {
  traceId: string;
  spanId: string;
  service: string;
  environment: string;
}

class StructuredLogger {
  constructor(private readonly context: LogContext) {}

  info(message: string, fields: Record<string, unknown> = {}): void {
    this.emit("info", message, fields);
  }

  error(
    message: string,
    error: Error,
    fields: Record<string, unknown> = {}
  ): void {
    this.emit("error", message, {
      ...fields,
      error: {
        name: error.name,
        message: error.message,
        stack: error.stack,
      },
    });
  }

  private emit(
    level: string,
    message: string,
    fields: Record<string, unknown>
  ): void {
    const entry = {
      timestamp: new Date().toISOString(),
      level,
      message,
      ...this.context,
      ...fields,
    };
    process.stdout.write(JSON.stringify(entry) + "\n");
  }
}

// Usage with request context
function createRequestLogger(req: Request, baseContext: LogContext): StructuredLogger {
  return new StructuredLogger({
    ...baseContext,
    traceId: req.headers["x-trace-id"] as string || generateTraceId(),
    spanId: generateSpanId(),
  });
}
Cada entrada de log lleva un trace ID que la conecta con cualquier otro log y span del mismo flujo de solicitud. Cuando un usuario reporta que "mi checkout falló", consultas por trace ID y ves todos los logs de todos los servicios involucrados en esa solicitud específica.
Tracing distribuido con OpenTelemetry
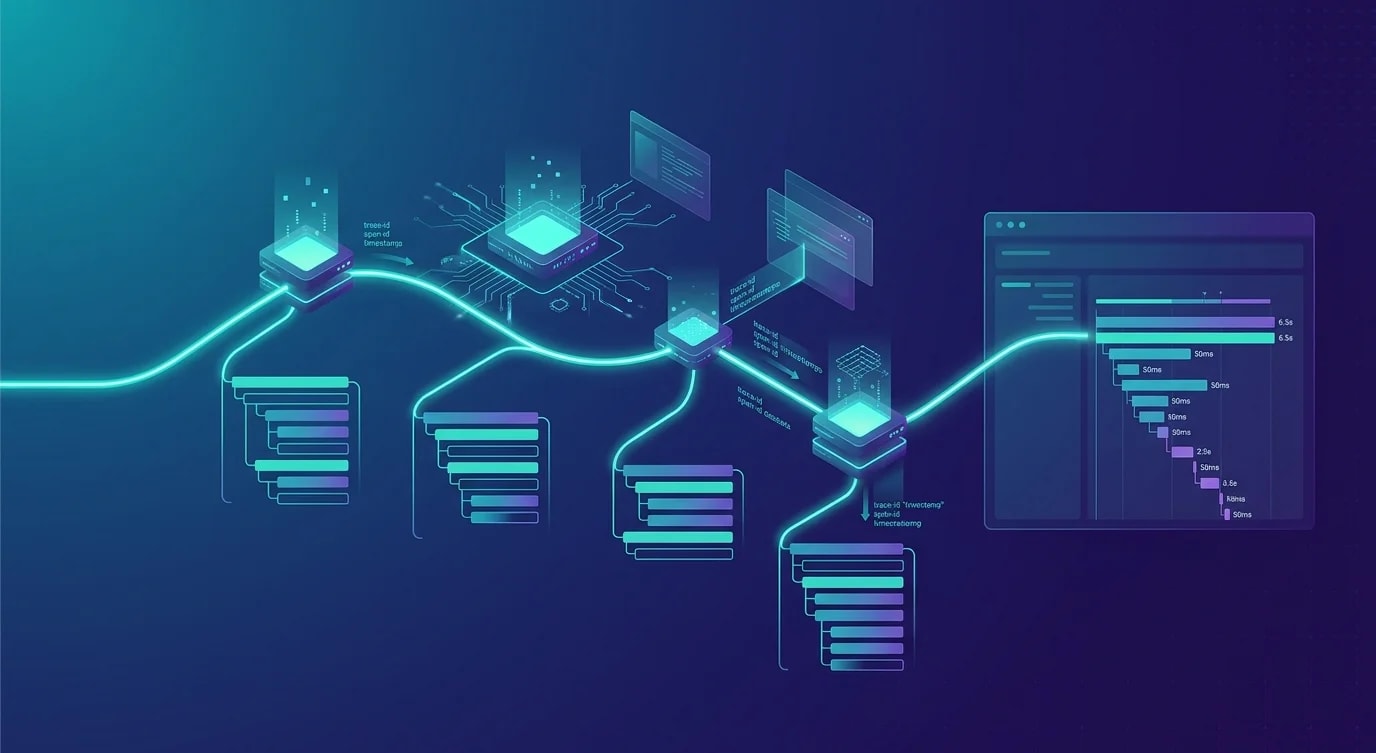
Los traces muestran el recorrido completo de una solicitud a través de tu sistema: qué servicios fueron llamados, cuánto tardó cada uno, dónde está el cuello de botella y qué servicio falló.
import { trace, SpanStatusCode, context, propagation } from "@opentelemetry/api";

const tracer = trace.getTracer("checkout-service");

async function processCheckout(
  order: Order
): Promise<CheckoutResult> {
  return tracer.startActiveSpan(
    "checkout.process",
    { attributes: { "order.id": order.id, "order.items": order.items.length } },
    async (span) => {
      try {
        // Each step creates a child span
        const inventory = await tracer.startActiveSpan(
          "checkout.verify-inventory",
          async (inventorySpan) => {
            const result = await inventoryService.verify(order.items);
            inventorySpan.setAttribute(
              "inventory.available",
              result.allAvailable
            );
            inventorySpan.end();
            return result;
          }
        );

        if (!inventory.allAvailable) {
          span.setStatus({
            code: SpanStatusCode.ERROR,
            message: "Items out of stock",
          });
          span.end();
          return { success: false, reason: "out-of-stock" };
        }

        const payment = await tracer.startActiveSpan(
          "checkout.process-payment",
          async (paymentSpan) => {
            paymentSpan.setAttribute("payment.method", order.paymentMethod);
            const result = await paymentService.charge(order);
            paymentSpan.setAttribute("payment.status", result.status);
            paymentSpan.end();
            return result;
          }
        );

        span.setStatus({ code: SpanStatusCode.OK });
        span.end();

        return { success: true, transactionId: payment.transactionId };
      } catch (error) {
        span.recordException(error as Error);
        span.setStatus({
          code: SpanStatusCode.ERROR,
          message: (error as Error).message,
        });
        span.end();
        throw error;
      }
    }
  );
}
Métricas que impulsan decisiones
No todas las métricas merecen ser recopiladas. El método RED (Rate, Errors, Duration) para servicios y el método USE (Utilization, Saturation, Errors) para recursos cubren lo esencial sin ahogarte en dashboards que nadie mira.
import { metrics } from "@opentelemetry/api";

const meter = metrics.getMeter("checkout-service");

// RED metrics for the checkout endpoint
const checkoutCounter = meter.createCounter("checkout.requests.total", {
  description: "Total checkout requests",
});

const checkoutErrors = meter.createCounter("checkout.errors.total", {
  description: "Total checkout errors",
});

const checkoutDuration = meter.createHistogram("checkout.duration.ms", {
  description: "Checkout request duration in milliseconds",
  unit: "ms",
});

// USE metrics for the connection pool
const poolUtilization = meter.createObservableGauge(
  "db.pool.utilization",
  { description: "Database pool utilization ratio" }
);

poolUtilization.addCallback((result) => {
  const pool = getConnectionPool();
  result.observe(pool.activeConnections / pool.maxConnections, {
    pool: "primary",
  });
});

// Middleware to instrument every request
function instrumentRequest(
  handler: RequestHandler
): RequestHandler {
  return async (req, res) => {
    const start = Date.now();
    const attributes = {
      "http.method": req.method,
      "http.route": req.route?.path || "unknown",
    };

    try {
      const result = await handler(req, res);
      checkoutCounter.add(1, { ...attributes, "http.status": res.statusCode });
      return result;
    } catch (error) {
      checkoutErrors.add(1, {
        ...attributes,
        "error.type": (error as Error).name,
      });
      throw error;
    } finally {
      checkoutDuration.record(Date.now() - start, attributes);
    }
  };
}
Correlación: conectando los tres pilares
El poder de la observabilidad viene de la correlación: saltar de una métrica anómala a los traces específicos que la causaron, y luego de esos traces a los logs específicos dentro de ellos. Esto requiere un identificador compartido: el trace ID.
interface ObservabilityContext {
  traceId: string;
  spanId: string;
  serviceName: string;
  environment: string;
}

// Inject context into every outgoing request
async function instrumentedFetch(
  url: string,
  options: RequestInit,
  ctx: ObservabilityContext
): Promise<Response> {
  const headers = new Headers(options.headers);
  headers.set("x-trace-id", ctx.traceId);
  headers.set("x-span-id", ctx.spanId);
  headers.set("x-service-name", ctx.serviceName);

  const start = Date.now();
  const response = await fetch(url, { ...options, headers });
  const duration = Date.now() - start;

  // Log with full context
  const logger = new StructuredLogger(ctx);
  logger.info("outgoing_request", {
    url,
    method: options.method || "GET",
    statusCode: response.status,
    durationMs: duration,
  });

  return response;
}

// Query workflow: metric spike → traces → logs
// 1. Alert: checkout.errors.total spike at 14:32
// 2. Query traces: find all traces with error status between 14:30-14:35
// 3. Identify pattern: all errors come from payment-service
// 4. Query logs: filter by traceId of failed requests
// 5. Root cause: payment gateway returning 503 due to certificate expiry
Los SLO como contratos de observabilidad
Los Objetivos de Nivel de Servicio (SLO) convierten los datos de observabilidad en contratos accionables. En lugar de reaccionar a cada error, defines presupuestos de error aceptables y priorizas el trabajo de ingeniería según la tasa de consumo del presupuesto.
interface SLO {
  name: string;
  target: number;           // e.g., 0.999 for 99.9%
  window: "7d" | "28d";
  indicator: SLI;
}

interface SLI {
  good: string;    // Query for successful events
  total: string;   // Query for all events
}

const checkoutSLO: SLO = {
  name: "Checkout Success Rate",
  target: 0.999,
  window: "28d",
  indicator: {
    good: "sum(checkout_requests_total{status='success'})",
    total: "sum(checkout_requests_total)",
  },
};

function calculateErrorBudget(
  slo: SLO,
  currentGoodEvents: number,
  currentTotalEvents: number
): {
  budgetTotal: number;
  budgetConsumed: number;
  budgetRemaining: number;
  burnRate: number;
} {
  const allowedFailureRate = 1 - slo.target;
  const budgetTotal = currentTotalEvents * allowedFailureRate;
  const actualFailures = currentTotalEvents - currentGoodEvents;
  const budgetConsumed = actualFailures;

  return {
    budgetTotal: Math.floor(budgetTotal),
    budgetConsumed,
    budgetRemaining: Math.floor(budgetTotal - budgetConsumed),
    burnRate: budgetConsumed / budgetTotal,
  };
}
Conclusiones clave
La observabilidad no es algo que agregas después del lanzamiento: es una disciplina de diseño que empieza antes de la primera línea de código de la aplicación. Estructura tus logs con campos tipados e IDs de correlación desde el primer día. Instrumenta traces distribuidos en los límites de cada servicio para poder seguir cualquier solicitud a través de todo el sistema. Recolecta métricas RED para los servicios y métricas USE para los recursos.
La capa de correlación es lo que transforma tres flujos de datos separados en un único flujo de trabajo de depuración: una anomalía en una métrica lleva a traces específicos, que llevan a logs específicos, que revelan la causa raíz. Sin correlación, tienes tres herramientas y cada una te cuenta solo una parte de la historia. Con ella, tienes un solo sistema que te cuenta la historia completa.
Define los SLO desde el principio. Convierten los datos de observabilidad en decisiones de priorización: cuando el presupuesto de error está sano, lanzas funcionalidades nuevas; cuando se está consumiendo rápido, arreglas la confiabilidad. Este marco simple evita que los equipos oscilen entre "ignorar todos los errores" y "dejarlo todo por cada alerta".