
DevOps
Estrategias de monitoreo y alertas para reducir la fatiga de alertas
Diseña monitoreo y alertas que muestren problemas reales: alertas por SLO, detección por síntomas, enrutamiento, runbooks y reducción de ruido.
·4 min de lectura
Etiquetas
12 artículos
Diseña monitoreo y alertas que muestren problemas reales: alertas por SLO, detección por síntomas, enrutamiento, runbooks y reducción de ruido.

Un marco probado para diagnosticar y resolver incidentes en producción rápido, desde la primera alerta hasta la causa raíz y la prevención.

Adelanta la observabilidad diseñando con logs estructurados, trazas distribuidas y métricas útiles desde el inicio: depuras antes y los incidentes duran menos.
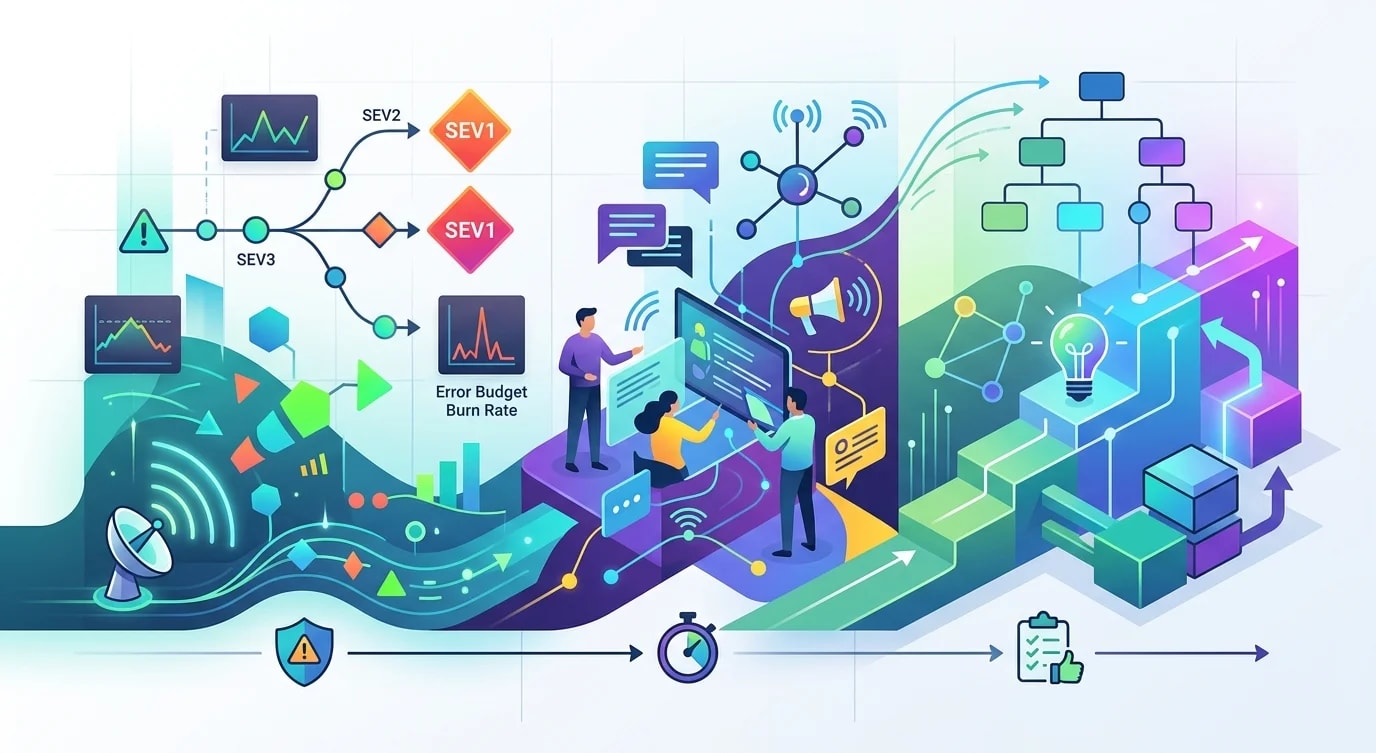
Enfoque sistemático de la gestión de incidentes: diseño de alertas, severidad, flujos de guardia, protocolos de comunicación y post-mortems sin culpas.
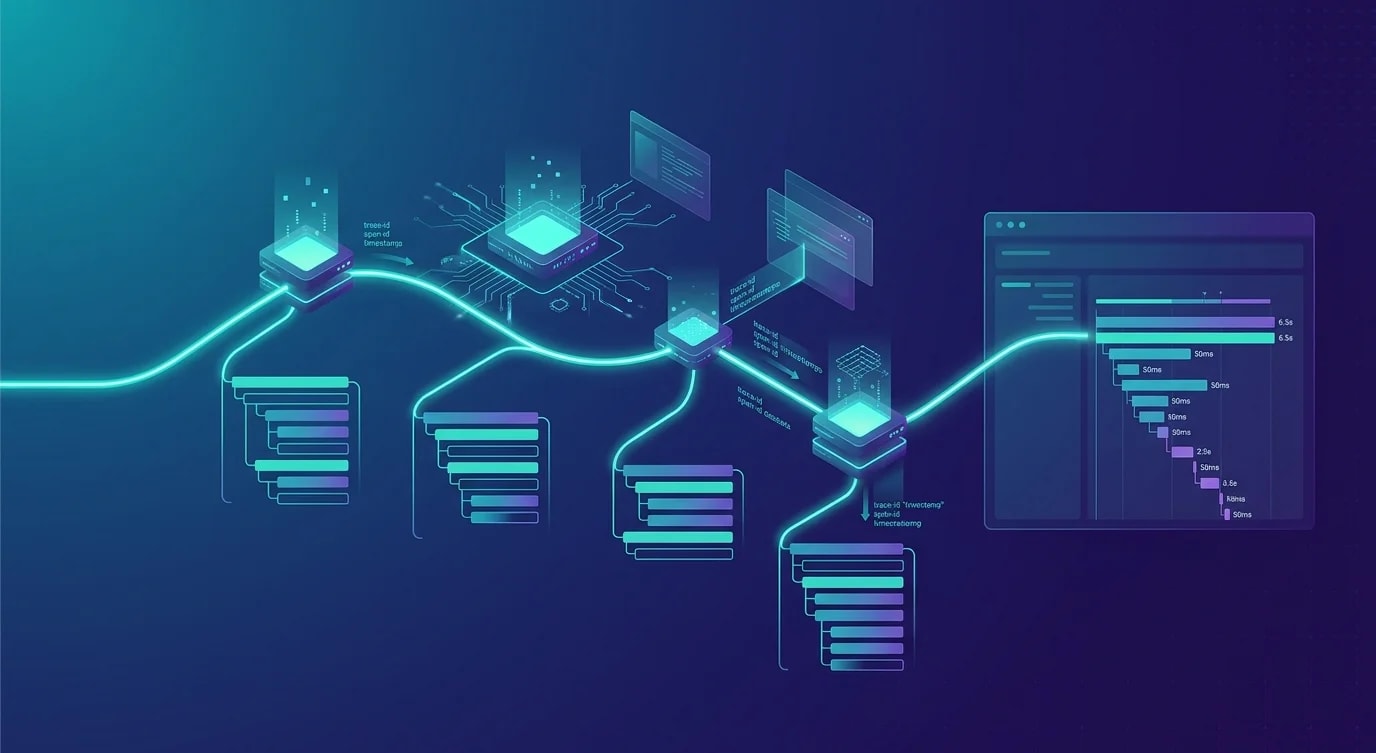
Implementa trazas distribuidas en microservicios con OpenTelemetry: propagación de contexto, spans, muestreo y análisis que hacen depurable el sistema.

Monta un stack completo con métricas de Prometheus, logging JSON estructurado y trazado con OpenTelemetry, y conecta cada señal con las demás.

Construye trazabilidad distribuida de producción con OpenTelemetry: propagación de contexto, muestreo, backends, correlación y cardinalidad.

Monitoreo de seguridad en tiempo de ejecución que detecta y bloquea ataques desde dentro de tu app Node.js: inyección SQL, path traversal y anomalías.

Detección de anomalías en métricas de aplicaciones: métodos estadísticos, z-scores, medias móviles, descomposición estacional y alertas sin fatiga.

Guía práctica para instrumentar Node.js con OpenTelemetry: trazas, métricas y logs con auto-instrumentación, spans propios, contexto y exportadores.

Cómo construir un stack de observabilidad que conecta trazas distribuidas, logs estructurados y métricas para depurar producción más rápido.
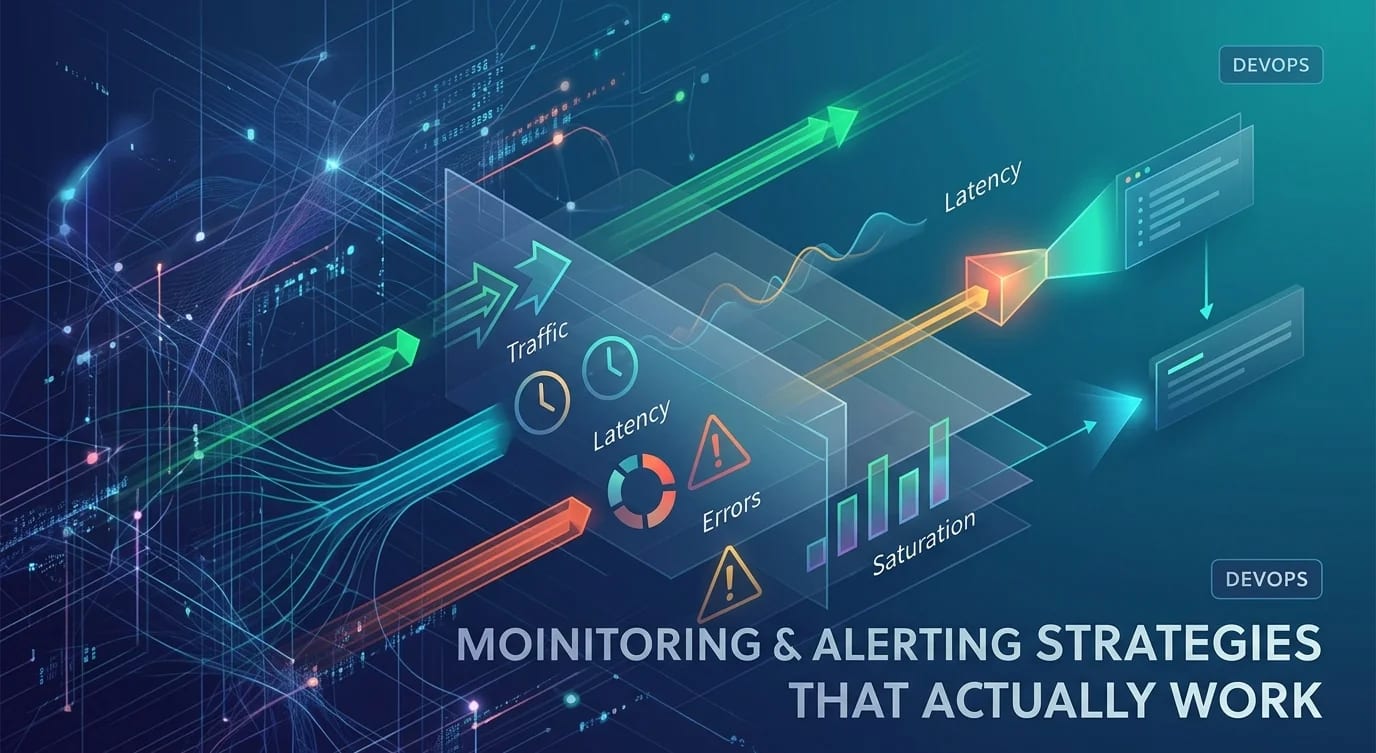
La fatiga por alertas arruina la respuesta a incidentes: construye tu monitoreo sobre SLIs, umbrales significativos y alertas accionables.