
DevOps
Monitoring- und Alerting-Strategien gegen Alert-Müdigkeit
Monitoring und Alerting, das echte Probleme zeigt: SLO-Alerts, symptombasierte Erkennung, Eskalationsrouting, Runbooks und Rauschreduzierung.
·4 Min. Lesezeit
Tags
12 Artikel
Monitoring und Alerting, das echte Probleme zeigt: SLO-Alerts, symptombasierte Erkennung, Eskalationsrouting, Runbooks und Rauschreduzierung.

Ein bewährtes Framework zur schnellen Diagnose und Behebung von Produktionsvorfällen — vom ersten Alert bis zur Root-Cause-Analyse und Prävention.

Verschiebe Observability nach links: strukturierte Logs, verteilte Traces und aussagekräftige Metriken von Anfang an — schnelleres Debugging.
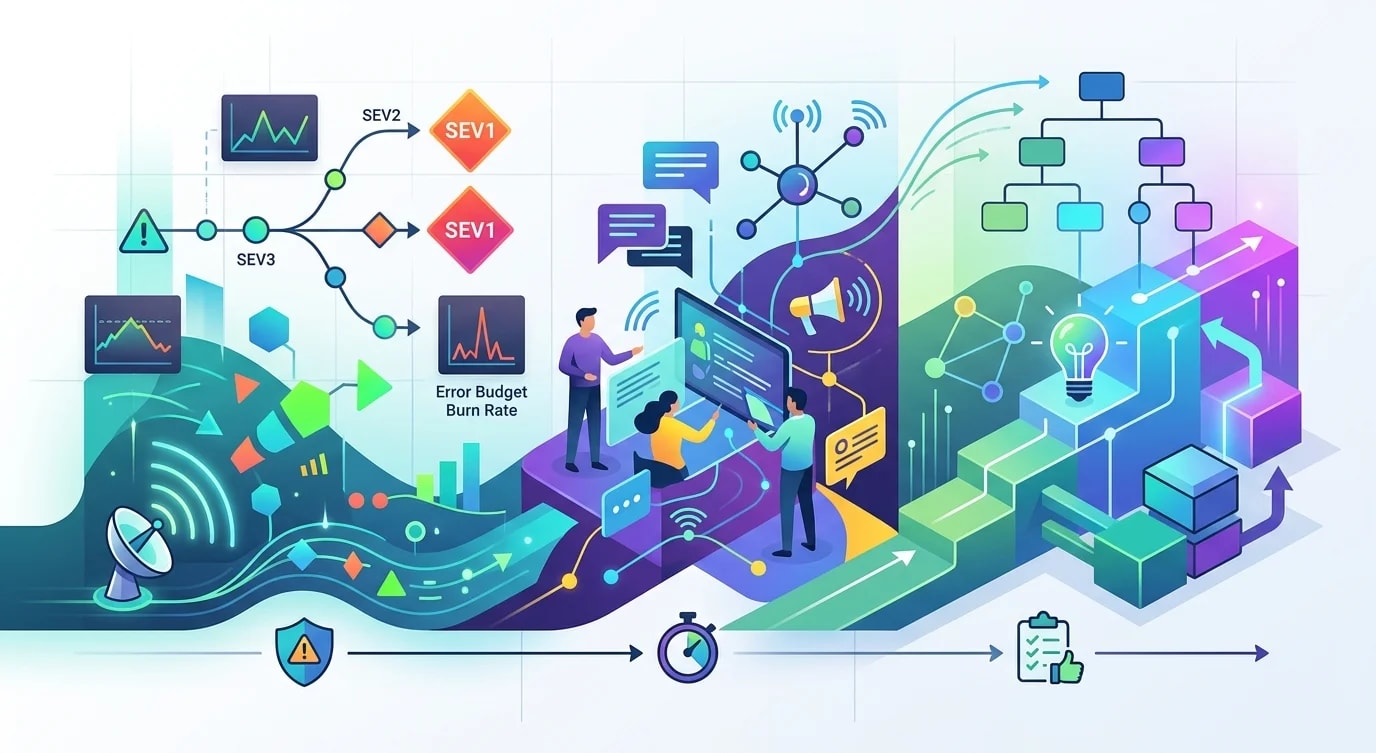
Ein systematischer Ansatz für Incident Management: Alert-Design, Schweregrade, On-Call-Workflows, Kommunikation und schuldfreie Post-Mortems.
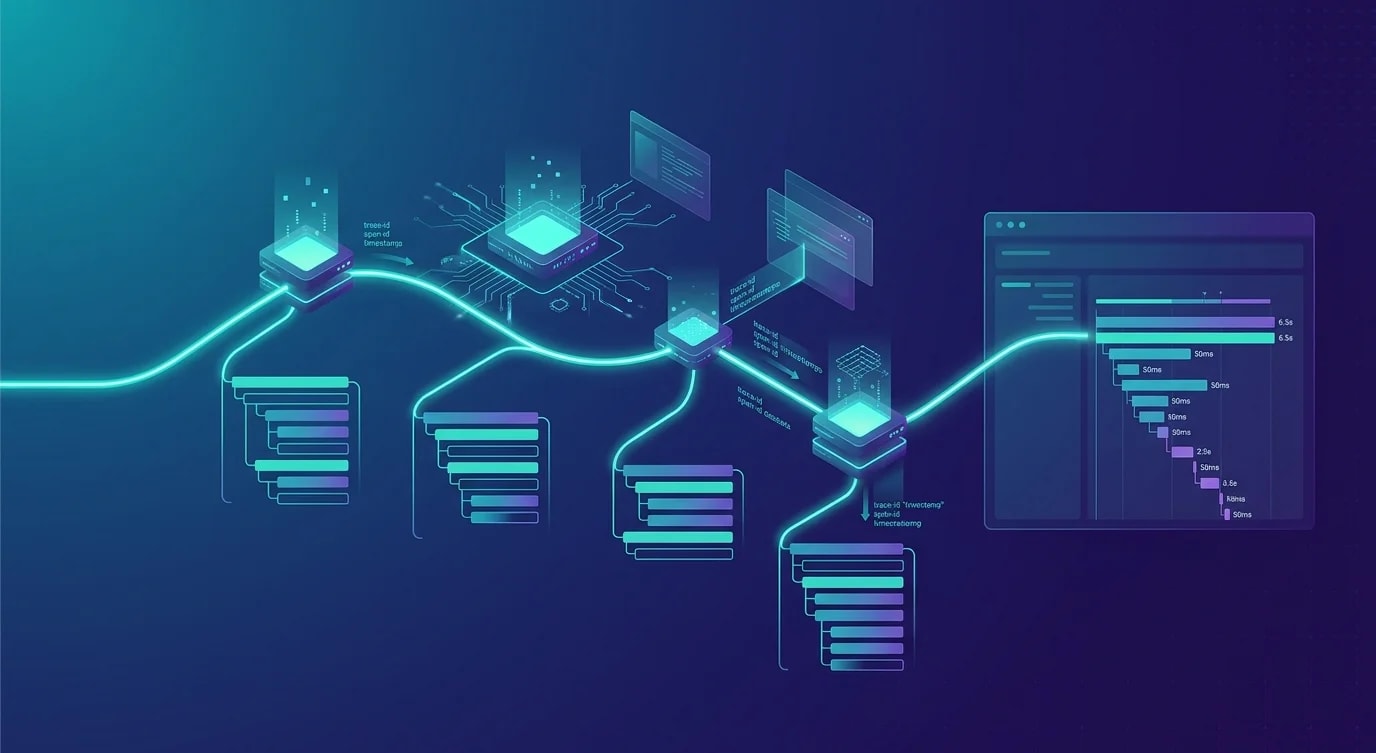
Distributed Tracing in Microservices mit OpenTelemetry: Kontextpropagation, Spans, Sampling und die Analyse, die Systeme debuggbar macht.

Baue einen vollständigen Observability-Stack mit Prometheus, strukturiertem JSON-Logging und OpenTelemetry — und verbinde die Signale sinnvoll.

Produktionsreifes Distributed Tracing mit OpenTelemetry: Kontextpropagation, Sampling, Storage-Backends, Log-Korrelation und Kardinalität.

Laufzeit-Sicherheitsmuster, die Angriffe in deiner Node.js-Anwendung erkennen und blockieren: SQL-Injection, Path Traversal und Anomalie-Alarme.

Anomalieerkennung für Anwendungsmetriken: statistische Methoden, Z-Scores, gleitende Durchschnitte, saisonale Zerlegung und Alarme ohne Alert Fatigue.

Praxisnahe Anleitung zur Instrumentierung von Node.js mit OpenTelemetry: Traces, Metriken, Logs, Auto-Instrumentierung, Spans und Exporter.

Wie man einen vollständigen Observability-Stack baut, der Traces, strukturierte Logs und Metriken verbindet — schneller als reines Monitoring.
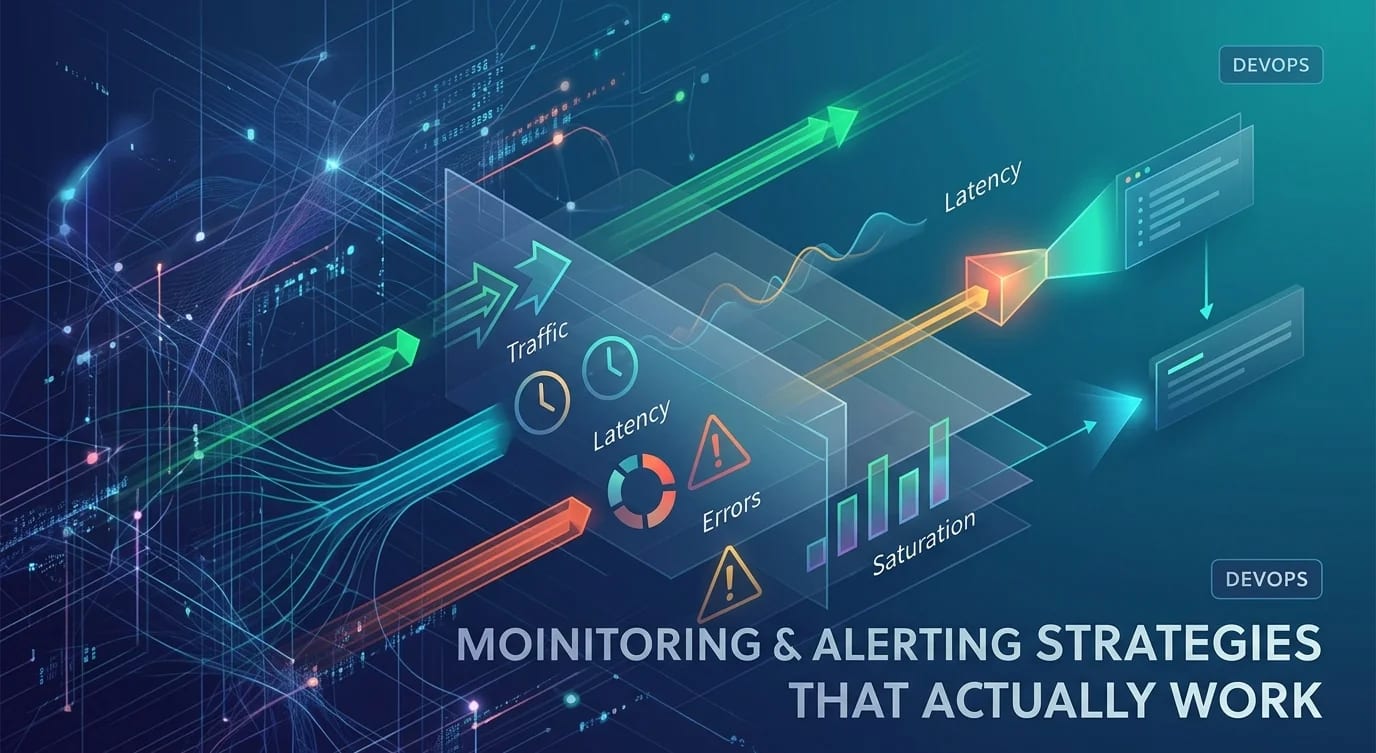
Alarmmüdigkeit sabotiert die Incident-Reaktion — baue deine Monitoring-Strategie auf SLIs, sinnvollen Schwellenwerten und umsetzbaren Alarmen auf.