Zuverlässige verteilte Tracing-Pipelines entwerfen
Produktionsreifes Distributed Tracing mit OpenTelemetry: Kontextpropagation, Sampling, Storage-Backends, Log-Korrelation und Kardinalität.

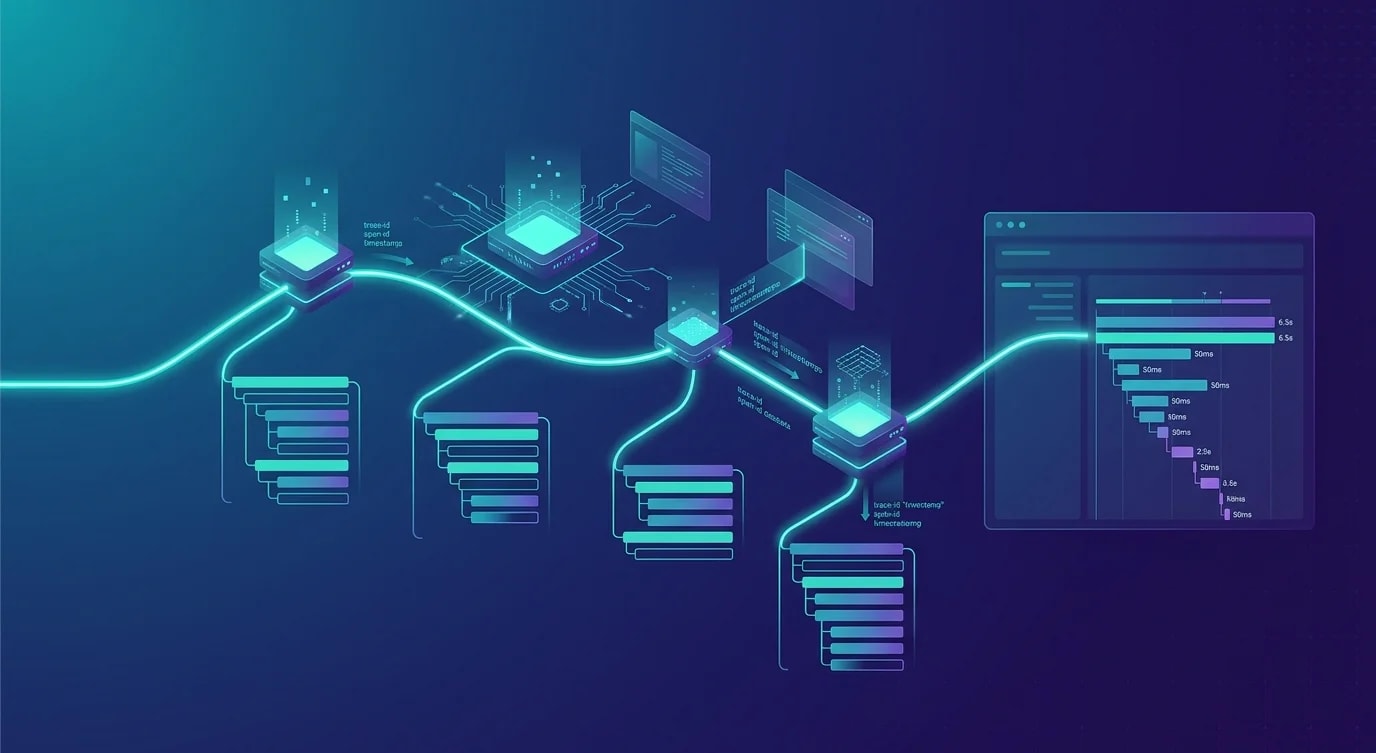
Verteiltes Tracing zeigt dir die komplette Reise eines Requests über Services hinweg. Ohne es ist Debugging in einer Microservices-Architektur Ratespiel: Du starrst auf Logs einzelner Services und versuchst, Timestamps zu korrelieren. Mit ihm siehst du den vollständigen Request-Pfad, wo Zeit verbraucht wurde und genau welcher Service einen Fehler verursacht hat.
Aber Tracing-Infrastruktur, die in der Entwicklung funktioniert, bricht oft in Produktion zusammen. Das Volumen an Trace-Daten im großen Maßstab erfordert intelligentes Sampling, die Speicheranforderungen können deine Anwendungsdatenbanken in den Schatten stellen, und schlecht konfigurierte Kontextpropagation erzeugt Lücken, die Traces genau dann nutzlos machen, wenn du sie am dringendsten brauchst.
OpenTelemetry-Instrumentierung
OpenTelemetry liefert das herstellerunabhängige Fundament. Einmal instrumentieren, in jedes Backend exportieren.
// ❌ Manuelle Span-Erzeugung überall — unübersichtlich, fragil
import { trace } from "@opentelemetry/api";

async function handleOrder(orderId: string) {
  const span = trace.getTracer("app").startSpan("handleOrder");
  try {
    span.setAttribute("order.id", orderId);
    // 50 lines of manual span management per function
    // Developers forget, spans are inconsistent
  } finally {
    span.end();
  }
}// ✅ SDK-Setup mit automatischer Instrumentierung
import { NodeSDK } from "@opentelemetry/sdk-node";
import {
getNodeAutoInstrumentations,
} from "@opentelemetry/auto-instrumentations-node";
import {
OTLPTraceExporter,
} from "@opentelemetry/exporter-trace-otlp-grpc";
import {
BatchSpanProcessor,
} from "@opentelemetry/sdk-trace-base";
import { Resource } from "@opentelemetry/resources";
import {
ATTR_SERVICE_NAME,
ATTR_SERVICE_VERSION,
} from "@opentelemetry/semantic-conventions";
const exporter = new OTLPTraceExporter({
url: "http://otel-collector:4317",
});
const sdk = new NodeSDK({
resource: new Resource({
[ATTR_SERVICE_NAME]: "order-service",
[ATTR_SERVICE_VERSION]: "2.4.1",
"deployment.environment": process.env.NODE_ENV ?? "development",
}),
spanProcessors: [
new BatchSpanProcessor(exporter, {
maxQueueSize: 2048,
maxExportBatchSize: 512,
scheduledDelayMillis: 5000,
}),
],
instrumentations: [
getNodeAutoInstrumentations({
"@opentelemetry/instrumentation-http": {
ignoreIncomingRequestHook: (req) =>
req.url === "/health" || req.url === "/ready",
},
"@opentelemetry/instrumentation-express": {
enabled: true,
},
"@opentelemetry/instrumentation-pg": {
enhancedDatabaseReporting: true,
},
}),
],
});
sdk.start();
// Graceful Shutdown
process.on("SIGTERM", async () => {
await sdk.shutdown();
process.exit(0);
});Auto-Instrumentierung deckt automatisch HTTP-Clients und -Server, Datenbanktreiber, Message Queues und gRPC ab. Manuelle Spans werden nur für Geschäftslogik-Grenzen benötigt, die die Auto-Instrumentierung nicht erkennen kann.
Sampling-Strategien
Im Produktionsmaßstab ist es unpraktikabel, 100% der Requests zu tracen: Die Datenmenge überfordert Speicher und Collector-Pipeline. Sampling entscheidet, welche Traces behalten werden.
// Head-based Sampling: am Trace-Start entscheiden
import {
  ParentBasedSampler,
  TraceIdRatioBasedSampler,
  AlwaysOnSampler,
} from "@opentelemetry/sdk-trace-base";
import { Sampler, SamplingResult } from "@opentelemetry/api";

// Kombinierter Sampler: unterschiedliche Raten für unterschiedlichen Traffic
class RuleBasedSampler implements Sampler {
  shouldSample(
    context: any,
    traceId: string,
    spanName: string,
    spanKind: any,
    attributes: Record<string, unknown>
  ): SamplingResult {
    const path = attributes["http.target"] as string;

    // Fehler immer tracen
    const statusCode = attributes["http.status_code"];
    if (statusCode && Number(statusCode) >= 500) {
      return { decision: 1 }; // RECORD_AND_SAMPLED
    }

    // Langsame Requests immer tracen (wird später via Tail Sampling entschieden)
    // High-Traffic Health Checks: nie
    if (path === "/health" || path === "/metrics") {
      return { decision: 0 }; // NOT_RECORD
    }

    // Zahlungs-Pfade: immer tracen
    if (path?.startsWith("/api/payments")) {
      return { decision: 1 };
    }

    // Standard: 10% Sampling
    const hash = traceId
      .slice(-8)
      .split("")
      .reduce((h, c) => h * 31 + c.charCodeAt(0), 0);

    return {
      decision: Math.abs(hash) % 100 < 10 ? 1 : 0,
    };
  }

  toString(): string {
    return "RuleBasedSampler";
  }
}# Tail-based Sampling im OTel Collector
# Entscheidet nach dem vollständigen Trace
processors:
tail_sampling:
decision_wait: 30s
num_traces: 100000
policies:
# Fehler-Traces immer behalten
- name: errors
type: status_code
status_code:
status_codes: [ERROR]
# Langsame Traces immer behalten
- name: latency
type: latency
latency:
threshold_ms: 2000
# 5% des normalen Traffics sampeln
- name: probabilistic
type: probabilistic
probabilistic:
sampling_percentage: 5
# Traces kritischer Services immer behalten
- name: critical-services
type: string_attribute
string_attribute:
key: service.name
values:
- payment-service
- auth-serviceTail-based Sampling im Collector ist mächtiger als Head-based Sampling im SDK, weil es den vollständigen Trace sehen kann, bevor es entscheidet. Fehler-Traces, langsame Traces und Traces kritischer Pfade werden immer behalten, während erfolgreiche Routine-Requests probabilistisch gesampelt werden.
Kontextpropagation über Services hinweg
Trace-Kontext muss korrekt über jede Kommunikationsgrenze hinweg propagiert werden. Ein einzelner Service, der den Kontext verliert, bricht den Trace.
// Kontextpropagation in asynchronen Nachrichtensystemen
import {
  propagation,
  context,
  trace,
  SpanKind,
} from "@opentelemetry/api";

// Producer: Trace-Kontext in Message-Headers injizieren
function publishEvent(
  queue: string,
  payload: Record<string, unknown>
): void {
  const tracer = trace.getTracer("publisher");
  const span = tracer.startSpan("publish", {
    kind: SpanKind.PRODUCER,
    attributes: {
      "messaging.system": "rabbitmq",
      "messaging.destination": queue,
    },
  });

  // Aktuellen Kontext in Message-Headers injizieren
  const headers: Record<string, string> = {};
  propagation.inject(
    trace.setSpan(context.active(), span),
    headers
  );

  channel.publish(queue, {
    body: Buffer.from(JSON.stringify(payload)),
    properties: { headers },
  });

  span.end();
}

// Consumer: Trace-Kontext aus Message-Headers extrahieren
function consumeEvent(message: Message): void {
  // Elternkontext aus Message-Headers extrahieren
  const parentContext = propagation.extract(
    context.active(),
    message.properties.headers
  );

  const tracer = trace.getTracer("consumer");

  // Consumer-Span mit Producer verknüpfen
  context.with(parentContext, () => {
    const span = tracer.startSpan("process", {
      kind: SpanKind.CONSUMER,
      attributes: {
        "messaging.system": "rabbitmq",
        "messaging.operation": "process",
      },
    });

    try {
      processMessage(message);
      span.setStatus({ code: 0 }); // OK
    } catch (error) {
      span.setStatus({
        code: 2, // ERROR
        message:
          error instanceof Error
            ? error.message
            : "Unknown error",
      });
      span.recordException(error as Error);
      throw error;
    } finally {
      span.end();
    }
  });
}
Traces mit Logs und Metriken korrelieren
Traces werden erst wirklich mächtig, wenn man sie mit Logs und Metriken korreliert. Eine Trace-ID in jedem Log-Eintrag ermöglicht den Sprung von einem Trace zu den genauen Logs dieses Requests.
// Strukturiertes Logging mit Trace-Korrelation
import { context, trace } from "@opentelemetry/api";
import pino from "pino";

function createLogger(serviceName: string) {
  const baseLogger = pino({
    level: process.env.LOG_LEVEL ?? "info",
  });

  return {
    info(message: string, data?: Record<string, unknown>) {
      baseLogger.info({
        ...data,
        ...getTraceContext(),
        service: serviceName,
        msg: message,
      });
    },

    error(
      message: string,
      error?: Error,
      data?: Record<string, unknown>
    ) {
      baseLogger.error({
        ...data,
        ...getTraceContext(),
        service: serviceName,
        msg: message,
        error: error
          ? {
              message: error.message,
              stack: error.stack,
              name: error.name,
            }
          : undefined,
      });
    },
  };
}

function getTraceContext(): Record<string, string> {
  const span = trace.getSpan(context.active());
  if (!span) return {};

  const spanContext = span.spanContext();
  return {
    traceId: spanContext.traceId,
    spanId: spanContext.spanId,
    traceFlags: String(spanContext.traceFlags),
  };
}

// Jeder Log-Eintrag enthält trace_id und span_id
// {"level":"info","traceId":"abc123...","spanId":"def456...",
//  "service":"order-service","msg":"Order created",
//  "orderId":"ord-789"}
Kernpunkte
Auto-Instrumentierung mit OpenTelemetry deckt HTTP-, Datenbank-, Message-Queue- und gRPC-Spans automatisch ab — manuelle Span-Erzeugung sollte nur für Geschäftslogik-Grenzen hinzugefügt werden, die die Auto-Instrumentierung nicht erkennen kann. Tail-based Sampling im OTel Collector behält alle Fehler-Traces, langsamen Traces und Traces kritischer Pfade bei und sampelt normalen Traffic probabilistisch, wodurch die blinden Flecken von Head-based-Sampling-Entscheidungen vermieden werden. Kontextpropagation muss jede Kommunikationsgrenze einschließlich Message Queues überqueren — das Injizieren von Trace-Kontext in Message-Headers und das Extrahieren in Consumern hält die Trace-Kette durch asynchrone Workflows aufrecht. Die Korrelation von Traces mit Logs über Trace-ID in strukturierten Log-Einträgen ermöglicht den Sprung von einem langsamen Span direkt zu den relevanten Log-Zeilen und verbindet das "was passiert ist" von Traces mit dem "warum" von Logs. Batch-Span-Processors mit abgestimmten Queue-Größen und Exportintervallen verhindern, dass Tracing die Anwendungsleistung beeinträchtigt — Spans werden gepuffert und asynchron exportiert, statt inline mit der Request-Verarbeitung gesendet zu werden.