
Backend
Request-Kontext in Node.js mit AsyncLocalStorage
Nutze AsyncLocalStorage, um Request-Kontext — Trace-IDs, Sitzungen, Mandantendaten — durch asynchrone Aufrufketten zu propagieren, statt ihn zu reichen.
·4 Min. Lesezeit
Tags
19 Artikel · Seite 1 von 2
Nutze AsyncLocalStorage, um Request-Kontext — Trace-IDs, Sitzungen, Mandantendaten — durch asynchrone Aufrufketten zu propagieren, statt ihn zu reichen.

Monitoring und Alerting, das echte Probleme zeigt: SLO-Alerts, symptombasierte Erkennung, Eskalationsrouting, Runbooks und Rauschreduzierung.

Ein bewährtes Framework zur schnellen Diagnose und Behebung von Produktionsvorfällen — vom ersten Alert bis zur Root-Cause-Analyse und Prävention.

Structured Logging in Node.js: maschinenlesbare, durchsuchbare Einträge mit Korrelations-IDs, einheitlichen Schweregraden und Kontextweitergabe.
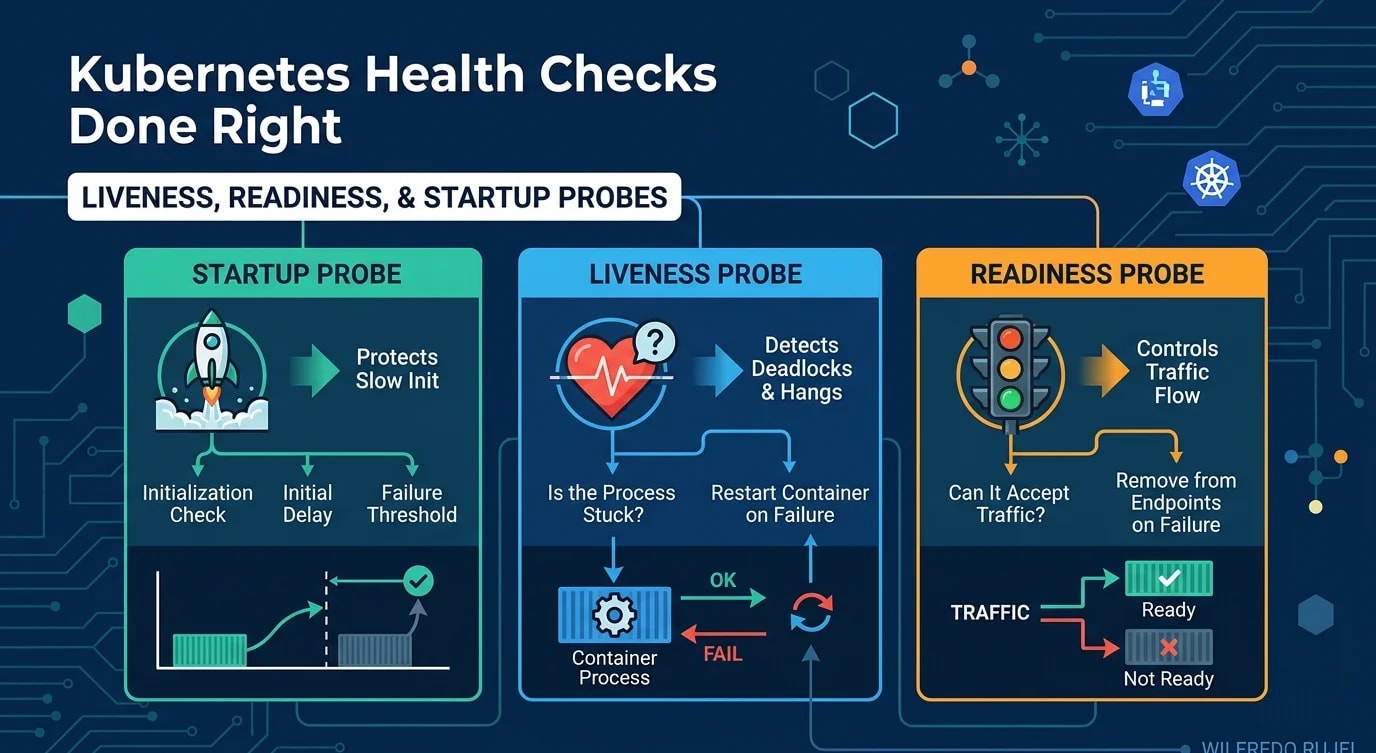
Konfiguriere Liveness-, Readiness- und Startup-Probes korrekt, um Kaskadenausfälle und unnötige Neustarts zu verhindern und Traffic richtig zu lenken.

Verschiebe Observability nach links: strukturierte Logs, verteilte Traces und aussagekräftige Metriken von Anfang an — schnelleres Debugging.
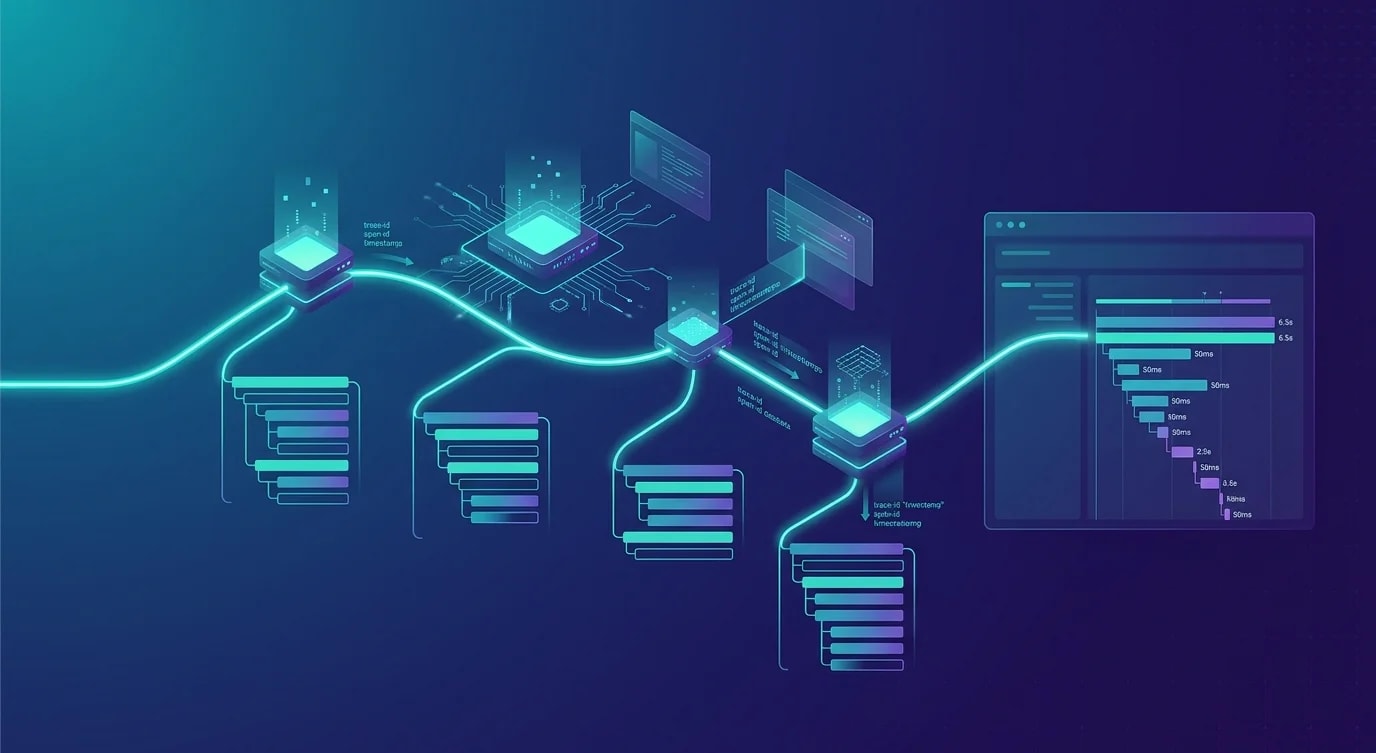
Distributed Tracing in Microservices mit OpenTelemetry: Kontextpropagation, Spans, Sampling und die Analyse, die Systeme debuggbar macht.

Baue einen vollständigen Observability-Stack mit Prometheus, strukturiertem JSON-Logging und OpenTelemetry — und verbinde die Signale sinnvoll.

Produktionsreifes Distributed Tracing mit OpenTelemetry: Kontextpropagation, Sampling, Storage-Backends, Log-Korrelation und Kardinalität.
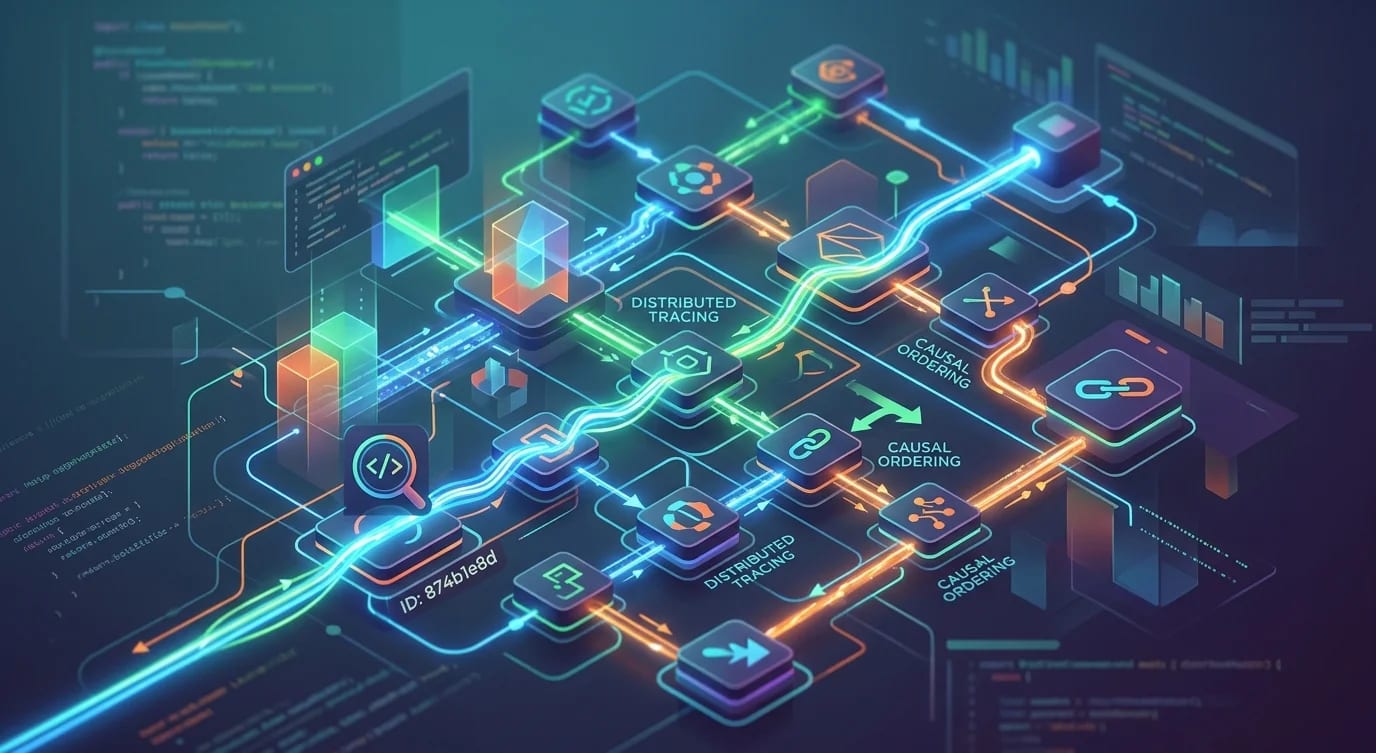
Debugge verteilte Systeme mit Correlation IDs, Tracing-Kontextpropagierung, Log-Aggregation und kausaler Ordnung bis zur eigentlichen Ursache.

Error-Boundary-Strategien, die Fehler elegant abfangen, sinnvolle Fallbacks liefern, brauchbare Diagnosen melden und den Schaden begrenzen.

Anomalieerkennung für Anwendungsmetriken: statistische Methoden, Z-Scores, gleitende Durchschnitte, saisonale Zerlegung und Alarme ohne Alert Fatigue.