Kubernetes-Probes: Liveness, Readiness und Startup
Konfiguriere Liveness-, Readiness- und Startup-Probes korrekt, um Kaskadenausfälle und unnötige Neustarts zu verhindern und Traffic richtig zu lenken.
Drei Probes, drei Zwecke
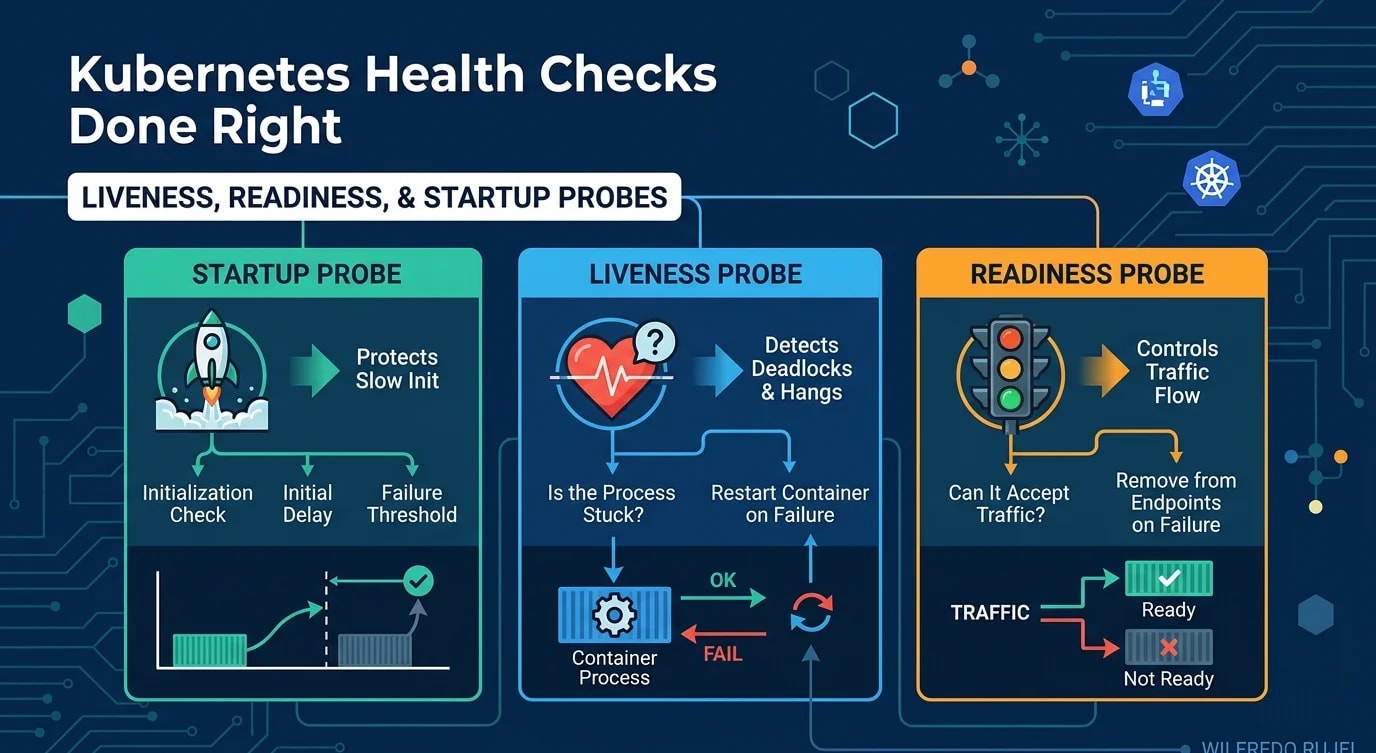
Kubernetes verwendet drei Arten von Health Checks, um den Lebenszyklus von Pods zu steuern. Werden sie verwechselt, drohen kaskadierende Neustarts, Traffic-Verluste und rätselhafte Ausfälle. Jede Probe beantwortet eine andere Frage: Lebt der Prozess? Kann er Traffic annehmen? Ist der Start abgeschlossen?
Startup-Probes: langsame Initialisierung
Startup-Probes schützen Container mit langsamem Start. Bis die Startup-Probe erfolgreich ist, deaktiviert Kubernetes die Liveness- und Readiness-Prüfungen. Ohne Startup-Probe wird ein Container, der 60 Sekunden zum Initialisieren braucht, von einer Liveness-Probe abgeschossen, die eine Antwort innerhalb von 10 Sekunden erwartet.
# ❌ No startup probe — slow apps get killed during init
apiVersion: apps/v1
kind: Deployment
metadata:
  name: api-server
spec:
  template:
    spec:
      containers:
        - name: api
          image: api-server:latest
          livenessProbe:
            httpGet:
              path: /healthz
              port: 8080
            initialDelaySeconds: 10  # Not enough for heavy init
            periodSeconds: 5
            failureThreshold: 3
# App needs 45 seconds to warm up — gets killed at 25s# ✅ Startup probe gives the app time to initialize
apiVersion: apps/v1
kind: Deployment
metadata:
name: api-server
spec:
template:
spec:
containers:
- name: api
image: api-server:latest
startupProbe:
httpGet:
path: /healthz/started
port: 8080
periodSeconds: 5
failureThreshold: 30 # 5s × 30 = 150s max startup time
livenessProbe:
httpGet:
path: /healthz/live
port: 8080
periodSeconds: 10
failureThreshold: 3
readinessProbe:
httpGet:
path: /healthz/ready
port: 8080
periodSeconds: 5
failureThreshold: 2
successThreshold: 1Liveness-Probes: Hängt der Prozess?
Liveness-Probes erkennen Deadlocks, Endlosschleifen und korrupten Zustand. Schlägt eine Liveness-Probe fehl, startet Kubernetes den Container neu. Setzen Sie Liveness-Probes zurückhaltend ein: Ein falsch positives Ergebnis startet einen gesunden Container neu und kann sich zu einem clusterweiten Ausfall auswachsen.
// Liveness endpoint: check if the process is fundamentally alive
// Do NOT check dependencies here — that's for readiness
app.get("/healthz/live", (req, res) => {
  // Check for deadlock conditions
  const eventLoopLag = measureEventLoopLag();
  const memoryUsage = process.memoryUsage();

  if (eventLoopLag > 5000) {
    // Event loop blocked for 5+ seconds — likely deadlocked
    res.status(503).json({
      status: "unhealthy",
      reason: "event_loop_blocked",
      lagMs: eventLoopLag,
    });
    return;
  }

  // Process is alive and responding
  res.status(200).json({ status: "ok" });
});

function measureEventLoopLag(): number {
  // Simplified — use a library like 'event-loop-lag' in production
  const start = performance.now();
  // If this takes significantly longer than expected,
  // the event loop is congested
  return performance.now() - start;
}// ❌ Liveness probe that checks database — causes cascading restarts
app.get("/healthz/live", async (req, res) => {
try {
await db.query("SELECT 1"); // DB down → pod restart → more load on DB
res.status(200).send("ok");
} catch {
res.status(503).send("unhealthy");
}
});
// ✅ Liveness only checks if the process itself is healthy
app.get("/healthz/live", (req, res) => {
// No external dependency checks — just process health
res.status(200).json({ status: "alive", uptime: process.uptime() });
});Readiness-Probes: Kann er Traffic annehmen?
Readiness-Probes steuern, ob ein Pod Traffic erhält. Schlägt eine Readiness-Probe fehl, wird der Pod aus den Endpoints des Service entfernt: Er bekommt keine Anfragen mehr, läuft aber weiter. Genau hier werden Abhängigkeiten geprüft.
interface DependencyCheck {
  name: string;
  check: () => Promise<boolean>;
  critical: boolean;
}

const dependencies: DependencyCheck[] = [
  {
    name: "database",
    critical: true,
    check: async () => {
      try {
        await db.query("SELECT 1");
        return true;
      } catch {
        return false;
      }
    },
  },
  {
    name: "redis",
    critical: true,
    check: async () => {
      try {
        await redis.ping();
        return true;
      } catch {
        return false;
      }
    },
  },
  {
    name: "external-api",
    critical: false, // Degraded but functional without it
    check: async () => {
      try {
        const response = await fetch("https://api.example.com/health", {
          signal: AbortSignal.timeout(2000),
        });
        return response.ok;
      } catch {
        return false;
      }
    },
  },
];

app.get("/healthz/ready", async (req, res) => {
  const results = await Promise.all(
    dependencies.map(async (dep) => ({
      name: dep.name,
      healthy: await dep.check(),
      critical: dep.critical,
    }))
  );

  const criticalFailures = results.filter(
    (r) => r.critical && !r.healthy
  );

  if (criticalFailures.length > 0) {
    res.status(503).json({
      status: "not_ready",
      failures: criticalFailures.map((f) => f.name),
      checks: results,
    });
    return;
  }

  res.status(200).json({
    status: "ready",
    checks: results,
  });
});
Geordnetes Herunterfahren mit PreStop-Hooks
Wenn Kubernetes einen Pod beendet, sendet es SIGTERM und entfernt den Pod gleichzeitig aus den Endpoints. Dabei entsteht eine Race Condition: Traffic kann noch eintreffen, nachdem der Pod bereits mit dem Herunterfahren begonnen hat. Ein preStop-Hook fügt eine Verzögerung ein, um laufende Anfragen sauber abzuarbeiten.
spec:
  containers:
    - name: api
      lifecycle:
        preStop:
          exec:
            command: ["sh", "-c", "sleep 10"]
terminationGracePeriodSeconds: 30// Handle graceful shutdown in Node.js
let isShuttingDown = false;
process.on("SIGTERM", async () => {
console.log("SIGTERM received, starting graceful shutdown");
isShuttingDown = true;
// Stop accepting new connections
server.close(async () => {
// Close database connections
await db.end();
await redis.quit();
console.log("Graceful shutdown complete");
process.exit(0);
});
// Force exit after timeout
setTimeout(() => {
console.error("Forced shutdown after timeout");
process.exit(1);
}, 25_000);
});
// Readiness probe returns not ready during shutdown
app.get("/healthz/ready", (req, res) => {
if (isShuttingDown) {
res.status(503).json({ status: "shutting_down" });
return;
}
// ... normal readiness checks
});Häufige Fehler und wie man sie behebt
Die gefährlichste Fehlkonfiguration sind zu aggressive Liveness-Probes, die Pods schon bei vorübergehenden Problemen neu starten und so einen Schneeballeffekt auslösen.
// Probe configuration guidelines as code
interface ProbeConfig {
  path: string;
  periodSeconds: number;
  failureThreshold: number;
  timeoutSeconds: number;
  successThreshold: number;
}

const recommendedConfig = {
  startup: {
    path: "/healthz/started",
    periodSeconds: 5,
    failureThreshold: 30,      // Allow 150s startup
    timeoutSeconds: 3,
    successThreshold: 1,
  } satisfies ProbeConfig,

  liveness: {
    path: "/healthz/live",
    periodSeconds: 15,          // Not too frequent
    failureThreshold: 3,        // 3 failures = 45s before restart
    timeoutSeconds: 5,
    successThreshold: 1,
  } satisfies ProbeConfig,

  readiness: {
    path: "/healthz/ready",
    periodSeconds: 5,           // Quick to remove from rotation
    failureThreshold: 2,        // 2 failures = 10s before traffic stops
    timeoutSeconds: 3,
    successThreshold: 1,        // 1 success = back in rotation
  } satisfies ProbeConfig,
};
Das Wichtigste in Kürze
Die drei Kubernetes-Probes erfüllen unterschiedliche Zwecke und dürfen nicht verwechselt werden. Startup-Probes schützen langsam initialisierende Container vor verfrühten Neustarts. Liveness-Probes erkennen blockierte Prozesse – sie prüfen ausschließlich die Prozessgesundheit, niemals externe Abhängigkeiten. Readiness-Probes steuern den Traffic – hier werden Datenbanken, Caches und nachgelagerte Dienste geprüft.
Prüfen Sie Abhängigkeiten niemals in Liveness-Probes. Eine ausfallende Datenbank sorgt dafür, dass alle Pods neu starten, was die Last auf genau dieser bereits angeschlagenen Datenbank weiter erhöht – eine kaskadierende Fehlerschleife. Konfigurieren Sie die Schwellenwerte der Probes konservativ: Die Liveness-Probe sollte träge auslösen (hoher failureThreshold), die Readiness-Probe sollte schnell reagieren. Implementieren Sie ein geordnetes Herunterfahren mit preStop-Hooks und SIGTERM-Handling, um laufende Anfragen während Deployments sauber abzuarbeiten. Health Checks sind einfach zu implementieren, aber bei falscher Konfiguration verheerend.