Sondas de Kubernetes: liveness, readiness y startup
Configura bien las sondas de liveness, readiness y startup para evitar fallos en cascada, reinicios innecesarios y tráfico a pods que no están listos.
Tres sondas, tres propósitos
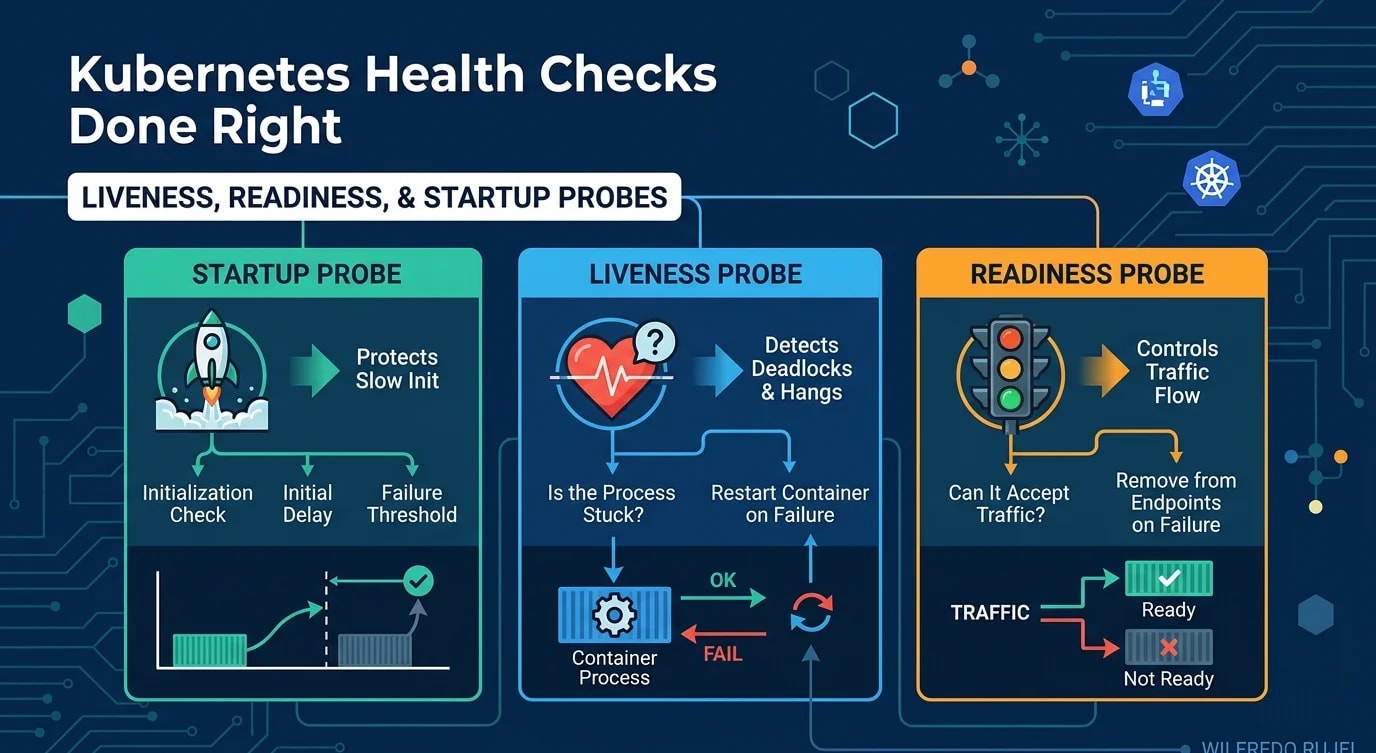
Kubernetes utiliza tres tipos de chequeos de salud para gestionar el ciclo de vida de los pods. Confundirlos provoca reinicios en cascada, pérdida de tráfico y caídas misteriosas. Cada sonda responde a una pregunta distinta: ¿está vivo el proceso? ¿puede aceptar tráfico? ¿ha terminado de iniciar?
Sondas de startup: inicialización lenta
Las sondas de startup protegen a los contenedores que tardan en arrancar. Hasta que la sonda de startup se completa con éxito, Kubernetes desactiva las comprobaciones de liveness y readiness. Sin una sonda de startup, un contenedor que tarda 60 segundos en inicializarse termina siendo eliminado por una sonda de liveness que espera una respuesta en 10 segundos.
# ❌ No startup probe — slow apps get killed during init
apiVersion: apps/v1
kind: Deployment
metadata:
  name: api-server
spec:
  template:
    spec:
      containers:
        - name: api
          image: api-server:latest
          livenessProbe:
            httpGet:
              path: /healthz
              port: 8080
            initialDelaySeconds: 10  # Not enough for heavy init
            periodSeconds: 5
            failureThreshold: 3
# App needs 45 seconds to warm up — gets killed at 25s# ✅ Startup probe gives the app time to initialize
apiVersion: apps/v1
kind: Deployment
metadata:
name: api-server
spec:
template:
spec:
containers:
- name: api
image: api-server:latest
startupProbe:
httpGet:
path: /healthz/started
port: 8080
periodSeconds: 5
failureThreshold: 30 # 5s × 30 = 150s max startup time
livenessProbe:
httpGet:
path: /healthz/live
port: 8080
periodSeconds: 10
failureThreshold: 3
readinessProbe:
httpGet:
path: /healthz/ready
port: 8080
periodSeconds: 5
failureThreshold: 2
successThreshold: 1Sondas de liveness: ¿está el proceso bloqueado?
Las sondas de liveness detectan interbloqueos, bucles infinitos y estados corruptos. Cuando una sonda de liveness falla, Kubernetes reinicia el contenedor. Utiliza las sondas de liveness con moderación: un falso positivo reinicia un contenedor sano y puede desencadenar una caída en todo el clúster.
// Liveness endpoint: check if the process is fundamentally alive
// Do NOT check dependencies here — that's for readiness
app.get("/healthz/live", (req, res) => {
  // Check for deadlock conditions
  const eventLoopLag = measureEventLoopLag();
  const memoryUsage = process.memoryUsage();

  if (eventLoopLag > 5000) {
    // Event loop blocked for 5+ seconds — likely deadlocked
    res.status(503).json({
      status: "unhealthy",
      reason: "event_loop_blocked",
      lagMs: eventLoopLag,
    });
    return;
  }

  // Process is alive and responding
  res.status(200).json({ status: "ok" });
});

function measureEventLoopLag(): number {
  // Simplified — use a library like 'event-loop-lag' in production
  const start = performance.now();
  // If this takes significantly longer than expected,
  // the event loop is congested
  return performance.now() - start;
}// ❌ Liveness probe that checks database — causes cascading restarts
app.get("/healthz/live", async (req, res) => {
try {
await db.query("SELECT 1"); // DB down → pod restart → more load on DB
res.status(200).send("ok");
} catch {
res.status(503).send("unhealthy");
}
});
// ✅ Liveness only checks if the process itself is healthy
app.get("/healthz/live", (req, res) => {
// No external dependency checks — just process health
res.status(200).json({ status: "alive", uptime: process.uptime() });
});Sondas de readiness: ¿puede aceptar tráfico?
Las sondas de readiness controlan si un pod recibe tráfico. Cuando una sonda de readiness falla, el pod se retira de los endpoints del Service: deja de recibir solicitudes, pero sigue en ejecución. Aquí es donde se comprueban las dependencias.
interface DependencyCheck {
  name: string;
  check: () => Promise<boolean>;
  critical: boolean;
}

const dependencies: DependencyCheck[] = [
  {
    name: "database",
    critical: true,
    check: async () => {
      try {
        await db.query("SELECT 1");
        return true;
      } catch {
        return false;
      }
    },
  },
  {
    name: "redis",
    critical: true,
    check: async () => {
      try {
        await redis.ping();
        return true;
      } catch {
        return false;
      }
    },
  },
  {
    name: "external-api",
    critical: false, // Degraded but functional without it
    check: async () => {
      try {
        const response = await fetch("https://api.example.com/health", {
          signal: AbortSignal.timeout(2000),
        });
        return response.ok;
      } catch {
        return false;
      }
    },
  },
];

app.get("/healthz/ready", async (req, res) => {
  const results = await Promise.all(
    dependencies.map(async (dep) => ({
      name: dep.name,
      healthy: await dep.check(),
      critical: dep.critical,
    }))
  );

  const criticalFailures = results.filter(
    (r) => r.critical && !r.healthy
  );

  if (criticalFailures.length > 0) {
    res.status(503).json({
      status: "not_ready",
      failures: criticalFailures.map((f) => f.name),
      checks: results,
    });
    return;
  }

  res.status(200).json({
    status: "ready",
    checks: results,
  });
});
Apagado ordenado con hooks de preStop
Cuando Kubernetes termina un pod, envía SIGTERM y, al mismo tiempo, lo retira de los endpoints. Ahí se produce una condición de carrera: puede llegar tráfico después de que el pod haya empezado a apagarse. Un hook de preStop añade un retraso para drenar las solicitudes en curso.
spec:
  containers:
    - name: api
      lifecycle:
        preStop:
          exec:
            command: ["sh", "-c", "sleep 10"]
terminationGracePeriodSeconds: 30// Handle graceful shutdown in Node.js
let isShuttingDown = false;
process.on("SIGTERM", async () => {
console.log("SIGTERM received, starting graceful shutdown");
isShuttingDown = true;
// Stop accepting new connections
server.close(async () => {
// Close database connections
await db.end();
await redis.quit();
console.log("Graceful shutdown complete");
process.exit(0);
});
// Force exit after timeout
setTimeout(() => {
console.error("Forced shutdown after timeout");
process.exit(1);
}, 25_000);
});
// Readiness probe returns not ready during shutdown
app.get("/healthz/ready", (req, res) => {
if (isShuttingDown) {
res.status(503).json({ status: "shutting_down" });
return;
}
// ... normal readiness checks
});Errores comunes y cómo solucionarlos
La configuración incorrecta más peligrosa son las sondas de liveness demasiado agresivas, que reinician los pods ante problemas transitorios y generan un efecto bola de nieve.
// Probe configuration guidelines as code
interface ProbeConfig {
  path: string;
  periodSeconds: number;
  failureThreshold: number;
  timeoutSeconds: number;
  successThreshold: number;
}

const recommendedConfig = {
  startup: {
    path: "/healthz/started",
    periodSeconds: 5,
    failureThreshold: 30,      // Allow 150s startup
    timeoutSeconds: 3,
    successThreshold: 1,
  } satisfies ProbeConfig,

  liveness: {
    path: "/healthz/live",
    periodSeconds: 15,          // Not too frequent
    failureThreshold: 3,        // 3 failures = 45s before restart
    timeoutSeconds: 5,
    successThreshold: 1,
  } satisfies ProbeConfig,

  readiness: {
    path: "/healthz/ready",
    periodSeconds: 5,           // Quick to remove from rotation
    failureThreshold: 2,        // 2 failures = 10s before traffic stops
    timeoutSeconds: 3,
    successThreshold: 1,        // 1 success = back in rotation
  } satisfies ProbeConfig,
};
Conclusiones clave
Las tres sondas de Kubernetes cumplen propósitos distintos y no deben confundirse. Las sondas de startup protegen a los contenedores de inicialización lenta frente a reinicios prematuros. Las sondas de liveness detectan procesos bloqueados: comprueban únicamente la salud del proceso, nunca dependencias externas. Las sondas de readiness controlan el tráfico: aquí es donde se comprueban bases de datos, cachés y servicios secundarios.
Nunca incluyas comprobaciones de dependencias en las sondas de liveness. Una base de datos caída provoca que todos los pods se reinicien, lo que aumenta la carga sobre esa misma base de datos ya afectada: un bucle de fallos en cascada. Configura los umbrales de las sondas con criterio conservador: la de liveness debe tardar en dispararse (failureThreshold alto) y la de readiness debe reaccionar con rapidez. Implementa un apagado ordenado con hooks de preStop y gestión de SIGTERM para drenar las solicitudes en curso durante los despliegues. Los chequeos de salud son sencillos de implementar, pero catastróficos si se configuran mal.