Pipelines de CI/CD que no te estorban
Cómo diseñar pipelines de CI/CD rápidos, fiables y en los que tu equipo confíe: caché, paralelismo, paridad de entornos y estrategias de despliegue.
El pipeline que mata la productividad
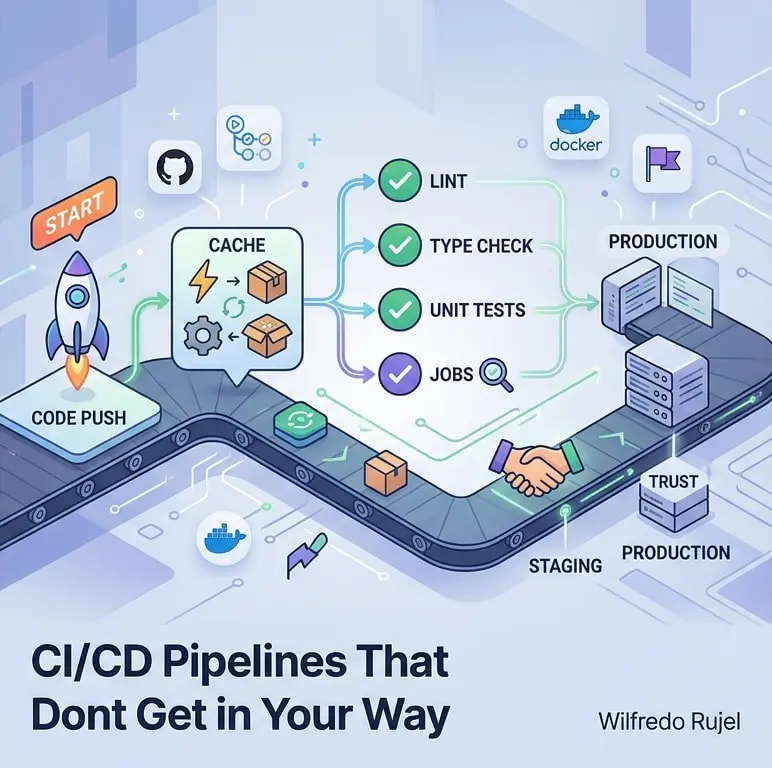
Un pipeline de CI/CD que tarda 25 minutos en ejecutarse no es una red de seguridad — es un impuesto sobre cada desarrollador, cada commit, cada día. Los pipelines lentos se ignoran. Los checks en verde se convierten en sellos automáticos. El pipeline deja de protegerte.
Así es como pienso la construcción de sistemas de CI/CD en los que los equipos realmente confían y usan.
Principio 1: La velocidad es una funcionalidad
Apunta a menos de 5 minutos para el ciclo de feedback desde el push hasta los resultados de los tests. Así se consigue:
Cachea todo lo que puedas
# GitHub Actions — aggressive dependency caching
- name: Cache node_modules
  uses: actions/cache@v4
  with:
    path: |
      ~/.npm
      node_modules
      .next/cache
    key: ${{ runner.os }}-node-${{ hashFiles('package-lock.json') }}
    restore-keys: |
      ${{ runner.os }}-node-

# Docker layer caching
- name: Build image
  uses: docker/build-push-action@v5
  with:
    context: .
    cache-from: type=gha
    cache-to: type=gha,mode=max
Con una caché bien configurada, npm install baja de 3 minutos a 8 segundos cuando hay cache hit.
Paraleliza los jobs independientes
jobs:
  lint:
    runs-on: ubuntu-latest
    steps: [checkout, setup-node, run-lint]

  type-check:
    runs-on: ubuntu-latest
    steps: [checkout, setup-node, run-tsc]

  unit-tests:
    runs-on: ubuntu-latest
    steps: [checkout, setup-node, run-jest]

  # Only run after all checks pass
  deploy:
    needs: [lint, type-check, unit-tests]
    if: github.ref == 'refs/heads/main'
    runs-on: ubuntu-latest
    steps: [deploy-to-staging]
Ejecutar lint, type-check y tests en paralelo reduce el tiempo del pipeline un 60%.
Principio 2: Paridad de entornos
«En mi máquina funciona» es un síntoma de desajuste entre entornos. Trata la paridad de entornos como un requisito innegociable.
# Pin exact tool versions everywhere
- uses: actions/setup-node@v4
  with:
    node-version-file: ".nvmrc" # Read from project file, not hardcoded

- uses: actions/setup-python@v5
  with:
python-version-file: ".python-version"# Development and CI use the same base image
FROM node:22.11.0-alpine AS base
# Deterministic installs
RUN npm ci --frozen-lockfile
# Match production exactly
ENV NODE_ENV=productionLos lock files, .nvmrc, .tool-versions y los digests fijados de las imágenes Docker son la infraestructura de los builds reproducibles.
Principio 3: Falla rápido, falla con claridad
Los desarrolladores deberían saber en menos de 60 segundos si su push tiene un error evidente.
jobs:
  quick-checks:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4

      # These run in seconds and catch 80% of failures
      - name: Check formatting
        run: npx prettier --check .

      - name: Type check
        run: npx tsc --noEmit

      - name: Lint
        run: npx eslint . --max-warnings 0

  # Run the slow tests only after quick checks pass
  integration-tests:
    needs: quick-checks
    runs-on: ubuntu-latest
    steps:
      - name: Run integration tests
        run: npm run test:integration
Ordena los jobs por velocidad y probabilidad de fallo. El check más rápido e informativo debe ejecutarse primero.
Principio 4: Estrategias de despliegue
Nunca despliegues directamente a producción. Usa despliegues por etapas.
Despliegues blue-green
#!/bin/bash
# Deploy to inactive slot, then swap
CURRENT=$(get_active_slot)  # "blue" or "green"
NEXT=$([ "$CURRENT" = "blue" ] && echo "green" || echo "blue")

# Deploy new version to inactive slot
deploy_to_slot $NEXT $IMAGE_TAG

# Run smoke tests against new slot
run_smoke_tests $NEXT

# Swap traffic
swap_traffic $CURRENT $NEXT

# Keep old slot warm for rollback
echo "Old slot ($CURRENT) ready for rollback"
Esto te da rollback instantáneo: devuelve el tráfico al slot anterior.
Feature flags para cambios arriesgados
// Deploy code to production before enabling it
import { createClient } from "@vercel/edge-config";

const config = createClient(process.env.EDGE_CONFIG);

export async function getFeatureFlag(
  flag: string,
  userId: string,
): Promise<boolean> {
  const flags =
    await config.get<Record<string, { enabled: boolean; rollout: number }>>(
      "features",
    );
  const feature = flags?.[flag];

  if (!feature?.enabled) return false;

  // Gradual rollout — deterministic per userId
  const hash = parseInt(userId.slice(-2), 16);
  return (hash / 255) * 100 < feature.rollout;
}
Publica el código. Actívalo para el 1% de los usuarios. Verifica las métricas. Aumenta gradualmente. Así se desacopla el despliegue del release.
Principio 5: Observabilidad en el pipeline
Tu pipeline debería ser tan observable como tu aplicación.
- name: Upload test results
  if: always() # Upload even if tests fail
  uses: actions/upload-artifact@v4
  with:
    name: test-results
    path: |
      coverage/
      test-results.xml

- name: Annotate PR with test failures
  if: failure()
  uses: actions/github-script@v7
  with:
    script: |
      const results = require('./test-results.json');
      const failures = results.testResults
        .flatMap(r => r.testResults.filter(t => t.status === 'failed'))
        .map(t => `- ${t.ancestorTitles.join(' > ')} > ${t.title}`)
        .join('\n');
      github.rest.issues.createComment({
        issue_number: context.issue.number,
        owner: context.repo.owner,
        repo: context.repo.repo,
        body: `## Test Failures\n${failures}`,
      });
Los checks de PR fallidos deberían decirte exactamente qué falló y por qué, sin necesidad de entrar a revisar los logs.
Checklist de salud del pipeline
Ejecuta esta auditoría sobre tu pipeline actual:
- El tiempo p95 del pipeline es inferior a 8 minutos
- La tasa de cache hits supera el 80% en la instalación de dependencias
- Los errores de lint y de tipos se reportan en menos de 90 segundos
- Los despliegues son por etapas (staging → canary → producción)
- El rollback tarda menos de 2 minutos
- Los fallos del pipeline crean anotaciones accionables en los PRs
- Los tests inestables (flaky) se registran y se ponen en cuarentena
Un pipeline bien diseñado es invisible — corre rápido, reporta con claridad y no estorba. Cuando tu equipo deja de quejarse del CI, lo has hecho bien.