Errores de diseño de bases de datos y cómo corregirlos
Los errores recurrentes de diseño que causan consultas lentas, migraciones dolorosas e incidentes, con soluciones prácticas y su razonamiento.
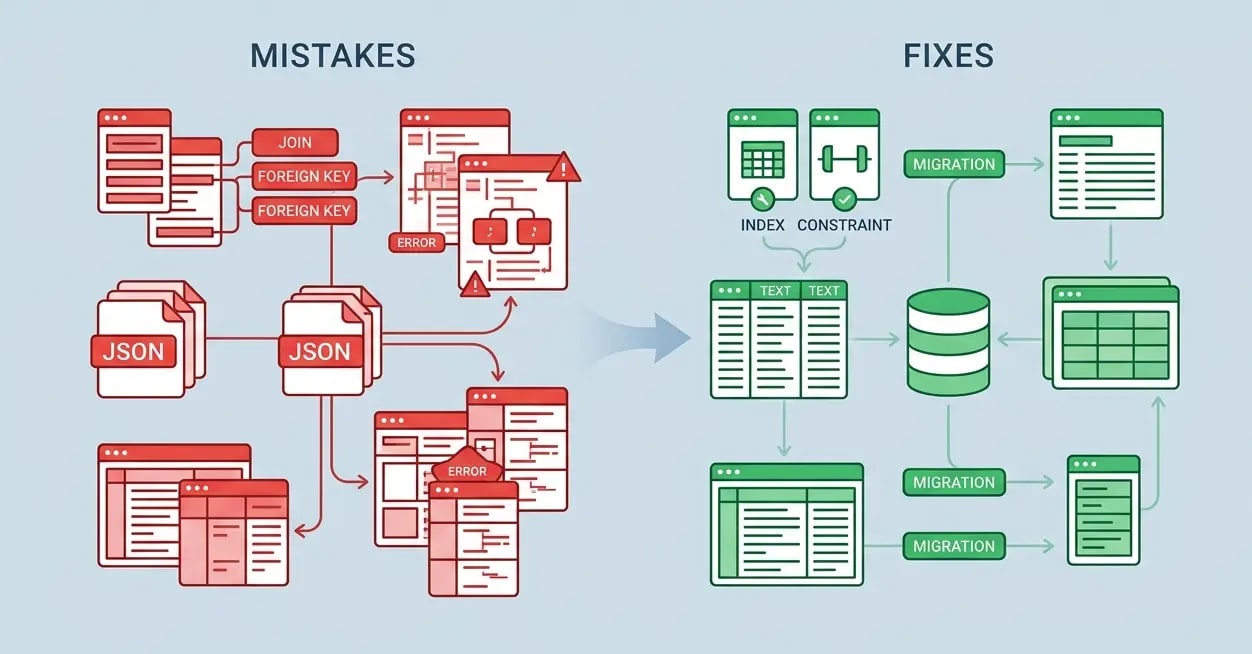
La base de datos no es un detalle de implementación
El esquema de tu base de datos es una de las decisiones más importantes de un proyecto. A diferencia del código, las migraciones de esquema son difíciles de revertir, pueden bloquear tablas durante minutos y repercuten en todas las capas de tu aplicación.
Estos son los errores que he visto —y corregido— con más frecuencia en sistemas en producción.
Error 1: Sin índices en las claves foráneas
Este es el asesino de rendimiento más común que encuentro. Las columnas de clave foránea casi siempre se usan en joins y cláusulas WHERE, pero PostgreSQL no las indexa automáticamente.
-- ❌ No index — this join does a full table scan on orders
SELECT u.name, COUNT(o.id) as order_count
FROM users u
JOIN orders o ON o.user_id = u.id
GROUP BY u.id;

-- ✅ Add indexes to foreign key columns
CREATE INDEX CONCURRENTLY idx_orders_user_id ON orders(user_id);
CREATE INDEX CONCURRENTLY idx_order_items_order_id ON order_items(order_id);
Usa EXPLAIN ANALYZE para detectar escaneos secuenciales en tablas grandes. Un índice faltante en una tabla de 5M de filas puede convertir una consulta de 10 ms en una de 30 segundos.
Error 2: Usar VARCHAR(255) para todo
El límite de 255 caracteres es un artefacto de cargo cult heredado de las antiguas limitaciones de índices de MySQL. En PostgreSQL, las cadenas cortas y largas tienen el mismo coste de almacenamiento. Más importante aún, los límites arbitrarios generan migraciones futuras.
-- ❌ Arbitrary limits that don't reflect real constraints
CREATE TABLE users (
  id UUID PRIMARY KEY,
  email VARCHAR(255),         -- Why 255? Email addresses can be 320 chars per RFC 5321
  username VARCHAR(255),      -- Should this really be the same limit as email?
  bio VARCHAR(255)            -- Bios are often longer; users will hit this
);

-- ✅ Use TEXT with CHECK constraints for actual business rules
CREATE TABLE users (
  id UUID PRIMARY KEY,
  email TEXT NOT NULL CHECK (length(email) <= 320),
  username TEXT NOT NULL CHECK (length(username) BETWEEN 3 AND 30),
  bio TEXT CHECK (length(bio) <= 2000)
);
Esto hace que las restricciones sean explícitas y detectables, y elimina toda una clase de migraciones futuras dolorosas.
Error 3: Almacenar JSON para datos estructurados
Las columnas JSON son potentes, pero con frecuencia se usan mal como vía de escape para evitar un diseño de esquema adecuado.
-- ❌ "Flexible" JSON that creates hidden structure
CREATE TABLE products (
  id UUID PRIMARY KEY,
  name TEXT,
  attributes JSONB  -- {"color": "red", "size": "M", "weight_kg": 0.5}
);

-- Problem: Can't efficiently query, can't enforce types, can't join
SELECT * FROM products WHERE attributes->>'color' = 'red'; -- No index, slow

-- ✅ Proper columns for structured, queryable data
CREATE TABLE products (
  id UUID PRIMARY KEY,
  name TEXT NOT NULL,
  color TEXT,
  size TEXT CHECK (size IN ('XS', 'S', 'M', 'L', 'XL')),
  weight_kg NUMERIC(6,3)
);

-- ✅ JSON is great for genuinely unstructured, rarely-queried metadata
CREATE TABLE products (
  id UUID PRIMARY KEY,
  name TEXT NOT NULL,
  color TEXT,
  metadata JSONB  -- supplier notes, custom fields, etc.
);
CREATE INDEX idx_products_metadata ON products USING gin(metadata);
Si escribes WHERE metadata->>'field' = 'value' con frecuencia, ese campo pertenece a una columna.
Error 4: Soft deletes sin índices parciales
El patrón de borrado lógico (deleted_at IS NULL) es un enfoque sólido, pero sin índices parciales, cada consulta que filtra por registros activos también recorre las filas eliminadas.
-- ❌ Standard index includes deleted rows — queries filter them at runtime
CREATE INDEX idx_users_email ON users(email);

-- Query: WHERE email = 'user@example.com' AND deleted_at IS NULL
-- Has to scan all matching emails, then filter out deleted ones

-- ✅ Partial index — only indexes non-deleted rows
CREATE INDEX idx_users_email_active ON users(email)
  WHERE deleted_at IS NULL;

-- Same query now hits only the partial index — dramatically smaller scan
En tablas grandes con muchas filas borradas lógicamente (común en aplicaciones con mucha auditoría), esto puede suponer una mejora de 10 a 100 veces en el rendimiento de las consultas.
Error 5: Migraciones que bloquean tablas
Los comandos ALTER TABLE suelen adquirir un bloqueo ACCESS EXCLUSIVE, que bloquea todas las lecturas y escrituras hasta que terminan. En producción, con tablas grandes, esto provoca caídas del servicio.
-- ❌ This locks the entire users table while running
ALTER TABLE users ADD COLUMN last_login_at TIMESTAMPTZ;

-- ✅ In PostgreSQL, adding a nullable column is safe (instant)
-- The lock is held briefly, not for the duration of backfill
ALTER TABLE users ADD COLUMN last_login_at TIMESTAMPTZ;

-- ❌ This rewrites the entire table, locks for minutes/hours
ALTER TABLE orders ALTER COLUMN status TYPE TEXT;

-- ✅ Zero-downtime column type change
-- Step 1: Add new column
ALTER TABLE orders ADD COLUMN status_new TEXT;
-- Step 2: Backfill in batches (outside a transaction)
UPDATE orders SET status_new = status::TEXT WHERE id BETWEEN x AND y;
-- Step 3: Swap and drop (with a short lock window)
BEGIN;
ALTER TABLE orders RENAME COLUMN status TO status_old;
ALTER TABLE orders RENAME COLUMN status_new TO status;
COMMIT;
DROP COLUMN status_old; -- Safe, no lock needed
Usa herramientas como pgroll o reshape para gestionar migraciones sin tiempo de inactividad de forma sistemática.
Error 6: Consultas N+1 ocultas en el código del ORM
Los ORM facilitan ejecutar accidentalmente una consulta por fila en lugar de una consulta para todas las filas.
// ❌ N+1 hidden in a loop — 1 query to get orders + 1 per order for user
const orders = await db.order.findMany({ take: 50 });
for (const order of orders) {
  const user = await db.user.findUnique({ where: { id: order.userId } });
  console.log(user.name, order.total);
}
// Result: 51 database round trips

// ✅ Eager loading with include — 2 queries total
const orders = await db.order.findMany({
  take: 50,
  include: { user: true },
});
// Result: 2 database round trips, regardless of order count
Usa un logger de consultas en desarrollo. Si ves la misma consulta repetida en un bucle, tienes un N+1.
La lista de verificación para revisar esquemas
Antes de fusionar cualquier migración:
- Cada columna de clave foránea tiene un índice
- Las nuevas columnas tienen restricciones NOT NULL y CHECK apropiadas
- No se almacena TEXT sin límite donde un tipo restringido tiene más sentido
- La migración se probó contra una instantánea de datos de producción
- Las migraciones de larga duración usan
CONCURRENTLYy se ejecutan por lotes - Se añadió la salida de EXPLAIN ANALYZE al PR para las consultas sobre las nuevas columnas
El coste de corregir errores de esquema después de llegar a producción es de 10 a 100 veces el coste de detectarlos en la revisión.