Datenbank-Designfehler in jeder Codebase und ihre Behebung
Die wiederkehrenden Designfehler hinter langsamen Abfragen, schmerzhaften Migrationen und Produktionsvorfällen — mit Lösungen und Begründung.
Die Datenbank ist kein Implementierungsdetail
Dein Datenbankschema ist eine der folgenreichsten Entscheidungen in einem Projekt. Anders als Code lassen sich Schema-Migrationen nur schwer rückgängig machen, können Tabellen minutenlang sperren und wirken durch jede Schicht deiner Anwendung.
Das sind die Fehler, die ich in Produktionssystemen am häufigsten gesehen — und behoben — habe.
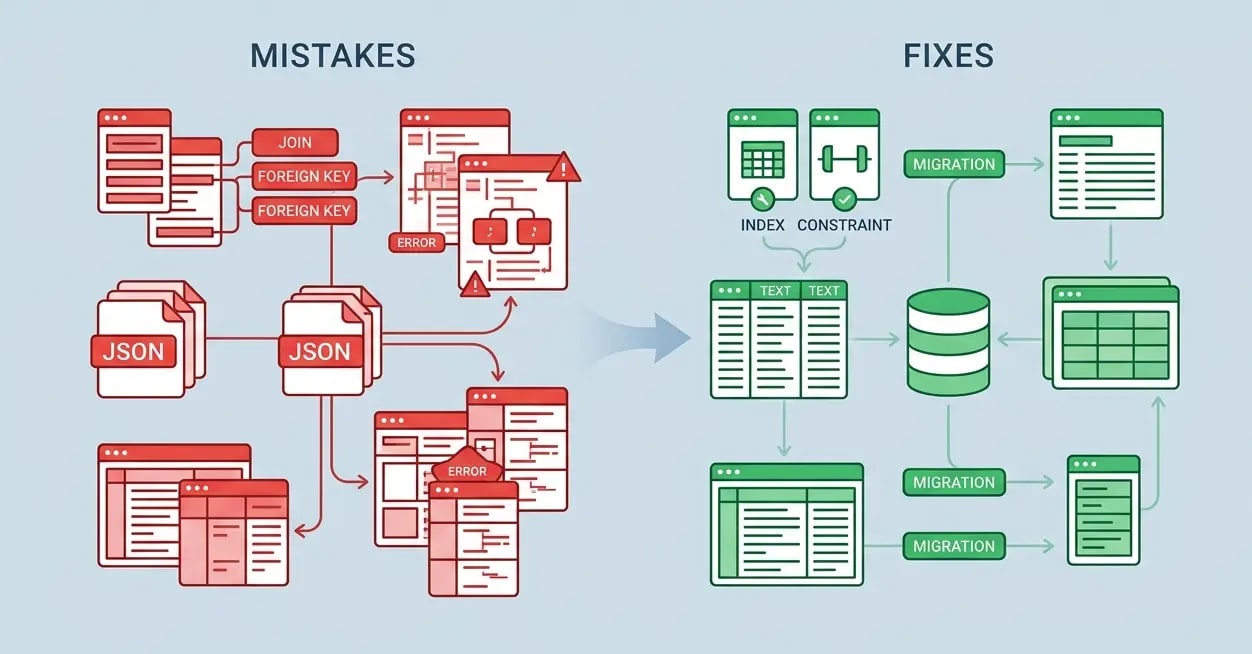
Fehler 1: Keine Indizes auf Fremdschlüsseln
Das ist der häufigste Performance-Killer, dem ich begegne. Fremdschlüssel-Spalten werden fast immer in Joins und WHERE-Klauseln verwendet, aber PostgreSQL indiziert sie nicht automatisch.
-- ❌ No index — this join does a full table scan on orders
SELECT u.name, COUNT(o.id) as order_count
FROM users u
JOIN orders o ON o.user_id = u.id
GROUP BY u.id;

-- ✅ Add indexes to foreign key columns
CREATE INDEX CONCURRENTLY idx_orders_user_id ON orders(user_id);
CREATE INDEX CONCURRENTLY idx_order_items_order_id ON order_items(order_id);
Nutze EXPLAIN ANALYZE, um sequentielle Scans auf großen Tabellen zu erkennen. Ein fehlender Index auf einer Tabelle mit 5 Mio. Zeilen kann aus einer 10-ms-Abfrage eine 30-Sekunden-Abfrage machen.
Fehler 2: VARCHAR(255) für alles verwenden
Die 255-Zeichen-Grenze ist ein Cargo-Kult-Artefakt aus den alten Index-Beschränkungen von MySQL. In PostgreSQL kosten kurze und lange Strings gleich viel Speicher. Wichtiger noch: Willkürliche Grenzen erzeugen künftige Migrationen.
-- ❌ Arbitrary limits that don't reflect real constraints
CREATE TABLE users (
  id UUID PRIMARY KEY,
  email VARCHAR(255),         -- Why 255? Email addresses can be 320 chars per RFC 5321
  username VARCHAR(255),      -- Should this really be the same limit as email?
  bio VARCHAR(255)            -- Bios are often longer; users will hit this
);

-- ✅ Use TEXT with CHECK constraints for actual business rules
CREATE TABLE users (
  id UUID PRIMARY KEY,
  email TEXT NOT NULL CHECK (length(email) <= 320),
  username TEXT NOT NULL CHECK (length(username) BETWEEN 3 AND 30),
  bio TEXT CHECK (length(bio) <= 2000)
);
Das macht Constraints explizit und auffindbar und beseitigt eine ganze Klasse schmerzhafter künftiger Migrationen.
Fehler 3: JSON für strukturierte Daten speichern
JSON-Spalten sind mächtig — werden aber häufig als Notausgang missbraucht, um sich vor sauberem Schema-Design zu drücken.
-- ❌ "Flexible" JSON that creates hidden structure
CREATE TABLE products (
  id UUID PRIMARY KEY,
  name TEXT,
  attributes JSONB  -- {"color": "red", "size": "M", "weight_kg": 0.5}
);

-- Problem: Can't efficiently query, can't enforce types, can't join
SELECT * FROM products WHERE attributes->>'color' = 'red'; -- No index, slow

-- ✅ Proper columns for structured, queryable data
CREATE TABLE products (
  id UUID PRIMARY KEY,
  name TEXT NOT NULL,
  color TEXT,
  size TEXT CHECK (size IN ('XS', 'S', 'M', 'L', 'XL')),
  weight_kg NUMERIC(6,3)
);

-- ✅ JSON is great for genuinely unstructured, rarely-queried metadata
CREATE TABLE products (
  id UUID PRIMARY KEY,
  name TEXT NOT NULL,
  color TEXT,
  metadata JSONB  -- supplier notes, custom fields, etc.
);
CREATE INDEX idx_products_metadata ON products USING gin(metadata);
Wenn du häufig WHERE metadata->>'field' = 'value' schreibst, gehört dieses Feld in eine Spalte.
Fehler 4: Soft Deletes ohne partielle Indizes
Das Soft-Delete-Muster (deleted_at IS NULL) ist ein solider Ansatz, aber ohne partielle Indizes scannt jede Abfrage, die nach aktiven Datensätzen filtert, auch die gelöschten Zeilen.
-- ❌ Standard index includes deleted rows — queries filter them at runtime
CREATE INDEX idx_users_email ON users(email);

-- Query: WHERE email = 'user@example.com' AND deleted_at IS NULL
-- Has to scan all matching emails, then filter out deleted ones

-- ✅ Partial index — only indexes non-deleted rows
CREATE INDEX idx_users_email_active ON users(email)
  WHERE deleted_at IS NULL;

-- Same query now hits only the partial index — dramatically smaller scan
Bei großen Tabellen mit vielen soft-gelöschten Zeilen (üblich in audit-intensiven Anwendungen) kann das die Abfrageleistung um Faktor 10 bis 100 verbessern.
Fehler 5: Migrationen, die Tabellen sperren
ALTER TABLE-Befehle holen sich oft einen ACCESS EXCLUSIVE-Lock und blockieren alle Lese- und Schreibzugriffe, bis sie fertig sind. In Produktion mit großen Tabellen führt das zu Ausfällen.
-- ❌ This locks the entire users table while running
ALTER TABLE users ADD COLUMN last_login_at TIMESTAMPTZ;

-- ✅ In PostgreSQL, adding a nullable column is safe (instant)
-- The lock is held briefly, not for the duration of backfill
ALTER TABLE users ADD COLUMN last_login_at TIMESTAMPTZ;

-- ❌ This rewrites the entire table, locks for minutes/hours
ALTER TABLE orders ALTER COLUMN status TYPE TEXT;

-- ✅ Zero-downtime column type change
-- Step 1: Add new column
ALTER TABLE orders ADD COLUMN status_new TEXT;
-- Step 2: Backfill in batches (outside a transaction)
UPDATE orders SET status_new = status::TEXT WHERE id BETWEEN x AND y;
-- Step 3: Swap and drop (with a short lock window)
BEGIN;
ALTER TABLE orders RENAME COLUMN status TO status_old;
ALTER TABLE orders RENAME COLUMN status_new TO status;
COMMIT;
DROP COLUMN status_old; -- Safe, no lock needed
Nutze Tools wie pgroll oder reshape, um Zero-Downtime-Migrationen systematisch zu verwalten.
Fehler 6: N+1-Abfragen, versteckt im ORM-Code
ORMs machen es leicht, versehentlich eine Abfrage pro Zeile auszuführen statt einer Abfrage für alle Zeilen.
// ❌ N+1 hidden in a loop — 1 query to get orders + 1 per order for user
const orders = await db.order.findMany({ take: 50 });
for (const order of orders) {
  const user = await db.user.findUnique({ where: { id: order.userId } });
  console.log(user.name, order.total);
}
// Result: 51 database round trips

// ✅ Eager loading with include — 2 queries total
const orders = await db.order.findMany({
  take: 50,
  include: { user: true },
});
// Result: 2 database round trips, regardless of order count
Nutze im Development einen Query-Logger. Wenn du dieselbe Abfrage in einer Schleife wiederholt siehst, hast du ein N+1.
Die Schema-Review-Checkliste
Vor dem Merge jeder Migration:
- Jede Fremdschlüssel-Spalte hat einen Index
- Neue Spalten haben passende NOT NULL- und CHECK-Constraints
- Kein unbegrenztes TEXT, wo ein eingeschränkter Typ sinnvoller wäre
- Die Migration wurde gegen einen Produktionsdaten-Snapshot getestet
- Lang laufende Migrationen nutzen
CONCURRENTLYund werden in Batches ausgeführt - EXPLAIN ANALYZE-Ausgabe für Abfragen auf neuen Spalten dem PR hinzugefügt
Die Kosten, Schema-Fehler nach dem Produktionsgang zu beheben, sind 10- bis 100-mal höher als die Kosten, sie im Review zu erwischen.