CI/CD-Pipelines, die nicht im Weg stehen
Wie man CI/CD-Pipelines baut, die schnell, zuverlässig und vertrauenswürdig sind: Caching, Parallelisierung, Umgebungsparität und Deployment-Strategien.
Die Pipeline, die die Produktivität killt
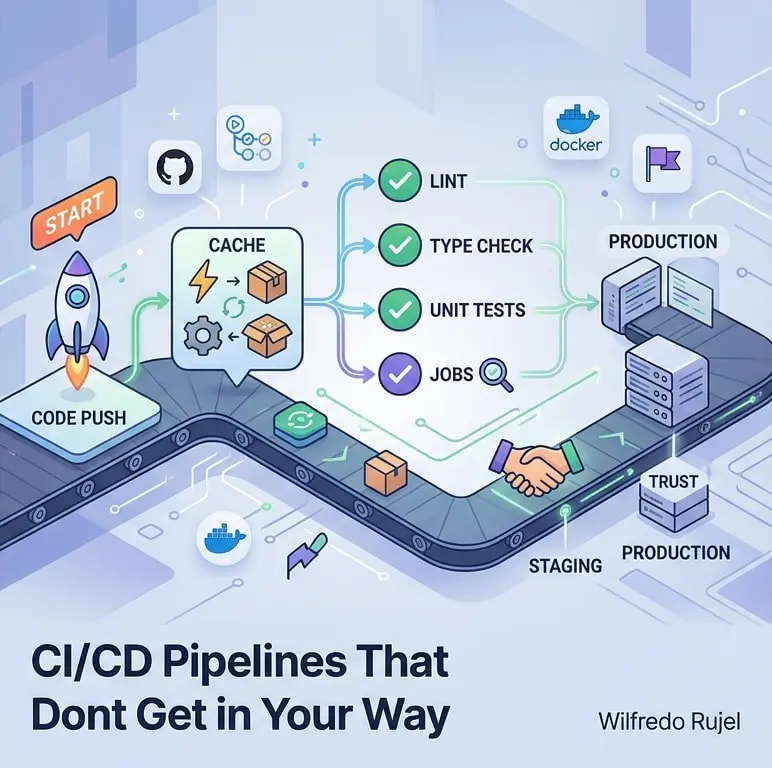
Eine CI/CD-Pipeline, die 25 Minuten pro Lauf braucht, ist kein Sicherheitsnetz — sie ist eine Steuer auf jeden Entwickler, jeden Commit, jeden Tag. Langsame Pipelines werden ignoriert. Grüne Checks werden zu Blanko-Stempeln. Die Pipeline schützt dich nicht mehr.
So denke ich über den Bau von CI/CD-Systemen, denen Teams tatsächlich vertrauen und die sie nutzen.
Prinzip 1: Geschwindigkeit ist ein Feature
Ziel: unter 5 Minuten für die Feedback-Schleife vom Push bis zu den Testergebnissen. So geht's:
Cache alles, was geht
# GitHub Actions — aggressive dependency caching
- name: Cache node_modules
  uses: actions/cache@v4
  with:
    path: |
      ~/.npm
      node_modules
      .next/cache
    key: ${{ runner.os }}-node-${{ hashFiles('package-lock.json') }}
    restore-keys: |
      ${{ runner.os }}-node-

# Docker layer caching
- name: Build image
  uses: docker/build-push-action@v5
  with:
    context: .
    cache-from: type=gha
    cache-to: type=gha,mode=max
Mit sauberem Caching sinkt npm install bei einem Cache-Hit von 3 Minuten auf 8 Sekunden.
Unabhängige Jobs parallelisieren
jobs:
  lint:
    runs-on: ubuntu-latest
    steps: [checkout, setup-node, run-lint]

  type-check:
    runs-on: ubuntu-latest
    steps: [checkout, setup-node, run-tsc]

  unit-tests:
    runs-on: ubuntu-latest
    steps: [checkout, setup-node, run-jest]

  # Only run after all checks pass
  deploy:
    needs: [lint, type-check, unit-tests]
    if: github.ref == 'refs/heads/main'
    runs-on: ubuntu-latest
    steps: [deploy-to-staging]
Lint, Type-Check und Tests parallel auszuführen verkürzt die Pipeline-Zeit um 60%.
Prinzip 2: Umgebungsparität
„Bei mir läuft's" ist ein Symptom für abweichende Umgebungen. Behandle Umgebungsparität als harte Anforderung.
# Pin exact tool versions everywhere
- uses: actions/setup-node@v4
  with:
    node-version-file: ".nvmrc" # Read from project file, not hardcoded

- uses: actions/setup-python@v5
  with:
python-version-file: ".python-version"# Development and CI use the same base image
FROM node:22.11.0-alpine AS base
# Deterministic installs
RUN npm ci --frozen-lockfile
# Match production exactly
ENV NODE_ENV=productionLockfiles, .nvmrc, .tool-versions und gepinnte Docker-Image-Digests sind die Infrastruktur für reproduzierbare Builds.
Prinzip 3: Schnell scheitern, klar scheitern
Entwickler sollten innerhalb von 60 Sekunden wissen, ob ihr Push einen offensichtlichen Fehler enthält.
jobs:
  quick-checks:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4

      # These run in seconds and catch 80% of failures
      - name: Check formatting
        run: npx prettier --check .

      - name: Type check
        run: npx tsc --noEmit

      - name: Lint
        run: npx eslint . --max-warnings 0

  # Run the slow tests only after quick checks pass
  integration-tests:
    needs: quick-checks
    runs-on: ubuntu-latest
    steps:
      - name: Run integration tests
        run: npm run test:integration
Ordne Jobs nach Geschwindigkeit und Fehlerwahrscheinlichkeit. Der schnellste, informativste Check läuft zuerst.
Prinzip 4: Deployment-Strategien
Deploye niemals direkt in die Produktion. Nutze gestufte Rollouts.
Blue-Green-Deployments
#!/bin/bash
# Deploy to inactive slot, then swap
CURRENT=$(get_active_slot)  # "blue" or "green"
NEXT=$([ "$CURRENT" = "blue" ] && echo "green" || echo "blue")

# Deploy new version to inactive slot
deploy_to_slot $NEXT $IMAGE_TAG

# Run smoke tests against new slot
run_smoke_tests $NEXT

# Swap traffic
swap_traffic $CURRENT $NEXT

# Keep old slot warm for rollback
echo "Old slot ($CURRENT) ready for rollback"
Das gibt dir sofortiges Rollback: Schalte den Traffic einfach zurück auf den vorherigen Slot.
Feature Flags für riskante Änderungen
// Deploy code to production before enabling it
import { createClient } from "@vercel/edge-config";

const config = createClient(process.env.EDGE_CONFIG);

export async function getFeatureFlag(
  flag: string,
  userId: string,
): Promise<boolean> {
  const flags =
    await config.get<Record<string, { enabled: boolean; rollout: number }>>(
      "features",
    );
  const feature = flags?.[flag];

  if (!feature?.enabled) return false;

  // Gradual rollout — deterministic per userId
  const hash = parseInt(userId.slice(-2), 16);
  return (hash / 255) * 100 < feature.rollout;
}
Code ausliefern. Für 1% der Nutzer aktivieren. Metriken prüfen. Hochfahren. So entkoppelst du Deployment vom Release.
Prinzip 5: Observability in der Pipeline
Deine Pipeline sollte genauso beobachtbar sein wie deine Anwendung.
- name: Upload test results
  if: always() # Upload even if tests fail
  uses: actions/upload-artifact@v4
  with:
    name: test-results
    path: |
      coverage/
      test-results.xml

- name: Annotate PR with test failures
  if: failure()
  uses: actions/github-script@v7
  with:
    script: |
      const results = require('./test-results.json');
      const failures = results.testResults
        .flatMap(r => r.testResults.filter(t => t.status === 'failed'))
        .map(t => `- ${t.ancestorTitles.join(' > ')} > ${t.title}`)
        .join('\n');
      github.rest.issues.createComment({
        issue_number: context.issue.number,
        owner: context.repo.owner,
        repo: context.repo.repo,
        body: `## Test Failures\n${failures}`,
      });
Fehlgeschlagene PR-Checks sollten dir genau sagen, was fehlgeschlagen ist und warum — ohne dass du erst ins Log klicken musst.
Die Pipeline-Gesundheitscheckliste
Führe dieses Audit auf deiner aktuellen Pipeline aus:
- Die p95-Pipeline-Zeit liegt unter 8 Minuten
- Die Cache-Hit-Rate liegt über 80% bei Dependency-Installationen
- Lint- und Type-Fehler werden in unter 90 Sekunden gemeldet
- Deployments sind gestuft (Staging → Canary → Produktion)
- Rollback dauert unter 2 Minuten
- Pipeline-Fehler erzeugen umsetzbare Annotationen in PRs
- Flaky Tests werden erfasst und unter Quarantäne gestellt
Eine gut gebaute Pipeline ist unsichtbar — sie läuft schnell, berichtet klar und bleibt im Hintergrund. Wenn dein Team aufhört, sich über CI zu beschweren, hast du alles richtig gemacht.