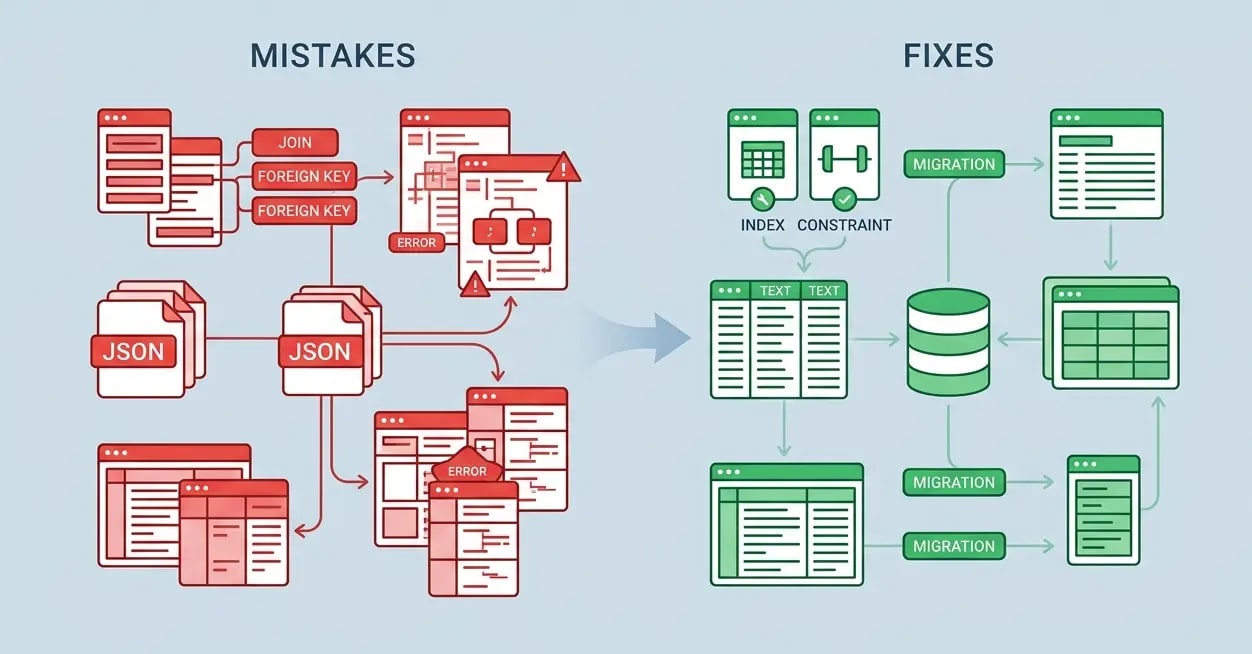
Soft Deletes: Das Feature, das mehr kostet, als es einspart
Soft Deletes wirken wie ein Sicherheitsnetz, doch sie beschädigen dein Schema, verfälschen Abfragen und brechen Constraints — bessere Alternativen.

Soft Deletes wirken zunächst einfach: eine deleted_at-Spalte hinzufügen, sie in jeder Abfrage herausfiltern, fertig. Sie tauchen in jedem ORM-Tutorial auf, in jedem SaaS-Boilerplate, in jeder Anleitung „So baust du eine Multi-Tenant-Anwendung". Sie fühlen sich an wie eine kostenlose Versicherung. In der Praxis sind sie eine Schema-Katastrophe in Zeitlupe, die Indizes beschädigt, Constraints bricht und über Jahre hinweg unsichtbare Datenlecks erzeugt.
Der Reiz ist real – Hard Deletes sind beängstigend, und deleted_at gibt dir eine Undo-Funktion. Aber zwischen dem, was Soft Deletes versprechen, und dem, was sie im großen Maßstab kosten, klafft eine erhebliche Lücke.
Das Index-Problem
Wenn du deleted_at zu einer Tabelle mit Millionen von Zeilen hinzufügst, wird jeder bestehende Index falsch. Ein Index auf email in der Tabelle users deckt jetzt sowohl aktive als auch gelöschte Zeilen ab – aber 99 % deiner Abfragen interessieren sich nur für die aktiven. Der Index wächst mit jedem Tombstone, den du ansammelst, und die Selektivität verschlechtert sich mit der Zeit.
Partielle Indizes in PostgreSQL lösen dieses Problem, führen aber eine neue Invariante ein, die du für immer pflegen musst:
-- ❌ Covers all rows — makes every active-user lookup scan deleted junk
CREATE INDEX idx_users_email ON users(email);

-- ✅ Partial index — only indexes rows you actually query
CREATE INDEX idx_users_email_active ON users(email)
WHERE deleted_at IS NULL;
Der Haken: Der Query-Planer verwendet einen partiellen Index nur, wenn die WHERE-Klausel der Abfrage das Prädikat des Index impliziert. Fehlt deleted_at IS NULL in einer einzigen Abfrage, landest du bei einem Sequential Scan. Jeder Entwickler, jedes Migrationsskript, jede Analytics-Abfrage muss an den Filter denken – sonst ist der Index nur Dekoration.
Unique Constraints brechen unbemerkt
Genau hier verbrennen sich Teams richtig die Finger. Du hast einen Unique Constraint auf users(email). Ein Nutzer löscht sein Konto. Drei Monate später registriert sich jemand mit derselben Adresse. Constraint-Verletzung – obwohl es keinen aktiven Datensatz mit dieser E-Mail-Adresse gibt.
-- ❌ Prevents re-registration — the unique constraint sees deleted rows too
ALTER TABLE users ADD CONSTRAINT users_email_unique UNIQUE (email);

-- ✅ Partial unique index — enforces uniqueness only among active rows
CREATE UNIQUE INDEX users_email_active_unique
  ON users(email)
  WHERE deleted_at IS NULL;
PostgreSQL unterstützt partielle Unique-Indizes, und das funktioniert einwandfrei. MySQL nicht – dort bist du gezwungen, die Eindeutigkeit im Anwendungscode durchzusetzen, was Race Conditions unter gleichzeitiger Last bedeutet. Zwei Anfragen können die Prüfung beide bestehen, bevor eine von beiden committet.
Eindeutigkeitsprüfungen auf Anwendungsebene sind unter gleichzeitiger Last nicht sicher. Verwende wo immer möglich Constraints auf Datenbankebene. Wenn deine Datenbank keine partiellen Unique-Indizes unterstützt, sind Soft Deletes und Eindeutigkeit grundsätzlich unvereinbar.
Query-Verschmutzung summiert sich über die Zeit
Sobald deleted_at IS NULL zur Pflicht wird, gehört es in jede Abfrage. In jeden ORM-Scope, jedes rohe SQL, jede Subquery, jede Join-Bedingung. Vergisst du es auch nur einmal, lieferst du gelöschte Daten an Nutzer aus.
Teams gehen das auf drei Arten an: Standard-Scopes im ORM (die für Verwirrung sorgen, wenn du tatsächlich gelöschte Zeilen brauchst), darauf vertrauen, dass Entwickler daran denken (werden sie nicht), oder Views, die standardmäßig filtern (vernünftig, fügt aber eine weitere Indirektionsebene hinzu). Keiner dieser Ansätze schließt die Lücke vollständig.
// ❌ Easy to forget — forgetting exposes deleted records silently
const users = await db
  .select()
  .from(usersTable)
  .where(eq(usersTable.organizationId, orgId));

// ✅ Explicit default scope baked into a repository boundary
async function getActiveUsers(orgId: string): Promise<User[]> {
  return db
    .select()
    .from(usersTable)
    .where(
      and(
        eq(usersTable.organizationId, orgId),
        isNull(usersTable.deletedAt),
      ),
    );
}
Selbst wenn eine Repository-Schicht die Anwendungsabfragen absichert, taucht rohes SQL weiterhin in Migrationen, einmaligen Skripten, Admin-Tools und Analytics-Pipelines auf. Der Filter muss überall existieren, wo er gebraucht wird – sonst ist er nicht zuverlässig.
Das Kaskaden-Problem
Fremdschlüssel mit ON DELETE CASCADE gehören zu den besten Funktionen, die relationale Datenbanken bieten – du löschst eine übergeordnete Zeile, und die untergeordneten Zeilen verschwinden automatisch, atomar, ganz ohne Anwendungslogik. Soft Deletes setzen das vollständig außer Kraft. Die Datenbank glaubt, es wurde nichts gelöscht, also feuern die Kaskaden nie.
Jetzt brauchst du Kaskadenlogik auf Anwendungsebene. Eine Organisation löschen? Alle ihre Nutzer, Workspaces, Einladungen und API-Keys finden und dann jede Entität innerhalb einer Transaktion per Soft Delete entfernen. Und diese Logik jedes Mal aktualisieren, wenn eine neue Kind-Tabelle hinzukommt.
// ❌ Manual cascade — someone will add a new table and forget this function
async function softDeleteOrganization(orgId: string, tx: Transaction) {
  await tx.update(usersTable)
    .set({ deletedAt: new Date() })
    .where(eq(usersTable.organizationId, orgId));

  await tx.update(workspacesTable)
    .set({ deletedAt: new Date() })
    .where(eq(workspacesTable.organizationId, orgId));

  // Invitations table added six months later — already a leak
  await tx.update(organizationsTable)
    .set({ deletedAt: new Date() })
    .where(eq(organizationsTable.id, orgId));
}
Jede neue Kind-Tabelle, die nach dem Schreiben dieser Funktion eingeführt wird, ist ein potenzielles Datenleck. Die Datenbank setzte referenzielle Integrität bisher kostenlos durch. Jetzt pflegst du sie von Hand über eine unbegrenzte Anzahl von Entitätstypen hinweg.
Was du stattdessen verwenden solltest
Bevor du zu deleted_at greifst, frag dich, welches Problem du eigentlich lösen willst:
| Ziel | Besserer Ansatz |
|---|---|
| Versehentliche Löschungen rückgängig machen | Point-in-Time Recovery, WAL-basierte Backups |
| Vollständiger Audit-Trail von Änderungen | Append-only Audit-Log oder Event Sourcing |
| Daten für Abrechnung oder Compliance aufbewahren | Archivtabelle mit echten Löschungen aus der Haupttabelle |
| „Papierkorb"-Feature in der UX | deleted_at mit explizitem Ablauf-Job |
| Fehlersuche bei Produktionsproblemen | Strukturierte Logs, Change Data Capture |
Archivtabellen
Für Compliance-Anforderungen verschiebt ein Hintergrundjob gelöschte Zeilen in eine Tabelle users_archive, bevor sie in users per Hard Delete entfernt werden. Die Haupttabelle bleibt sauber, Constraints funktionieren, Indizes bleiben schlank, und das Archiv wird nur einmal beschrieben und im Hot Path nie angefasst.
-- Archive first, then hard delete — main table stays clean
BEGIN;

INSERT INTO users_archive
SELECT *, NOW() AS archived_at
FROM users
WHERE id = $1;

DELETE FROM users WHERE id = $1;

COMMIT;
Append-only Audit-Logs
Wenn die Anforderung lautet „Wie sah dieser Datensatz vor sechs Monaten aus?", liefert dir ein Audit-Log die vollständige Historie – nicht nur, ob die Zeile gelöscht wurde. Du kannst jeden vergangenen Zustand rekonstruieren, indem du die Events erneut abspielst, und die Produktionstabelle enthält keine Tombstones.
// Write the event, then hard delete — full history without polluting the table
async function deleteUser(userId: string, actorId: string, tx: Transaction) {
  const user = await tx.query.usersTable.findFirst({
    where: eq(usersTable.id, userId),
  });

  await tx.insert(auditLogTable).values({
    entityType: "user",
    entityId: userId,
    action: "deleted",
    payload: JSON.stringify(user),
    actorId,
    createdAt: new Date(),
  });

  await tx.delete(usersTable).where(eq(usersTable.id, userId));
}
Wann Soft Deletes vertretbar sind
Sie sind nicht immer falsch. Eine deleted_at-Spalte ist vertretbar, wenn die Tabelle klein ist und ihr Wachstum begrenzt bleibt, wenn du explizit ein Papierkorb-Feature mit einem geplanten Ablauf-Job baust, oder wenn die Bedenken zu Eindeutigkeit und Kaskaden für diese Entität wirklich nicht zutreffen. Der Fehler liegt nicht im Muster selbst, sondern darin, es standardmäßig auf jede Tabelle im Schema anzuwenden, ohne zu bedenken, was dadurch kaputtgeht.
Die wichtigsten Erkenntnisse
- Partielle Indizes helfen, verlangen aber absolute Disziplin – jede Abfrage muss das Filterprädikat enthalten, sonst wird der Index ignoriert
- Unique Constraints und Soft Deletes sind unter MySQL inkompatibel und erfordern partielle Unique-Indizes unter PostgreSQL – prüfe deine Datenbank, bevor du dich festlegst
- Kaskaden auf Anwendungsebene verrotten – jede neue Kind-Tabelle ist ein potenzielles Datenleck, wenn die Kaskadenfunktion nicht synchron gehalten wird
- Archivtabellen lösen die Compliance-Anforderung sauber – die Haupttabelle bleibt normalisiert, das Archiv ist append-only und liegt außerhalb des Hot Path
- Audit-Logs geben dir die vollständige Historie, statt nur eines Löschzeitpunkts – und sie lassen sich gut mit Event Sourcing kombinieren
- Wähle das Werkzeug passend zur tatsächlichen Anforderung: Papierkorb →
deleted_atmit Ablauf; Compliance → Archivtabelle; Audit-Trail → append-only Event-Log