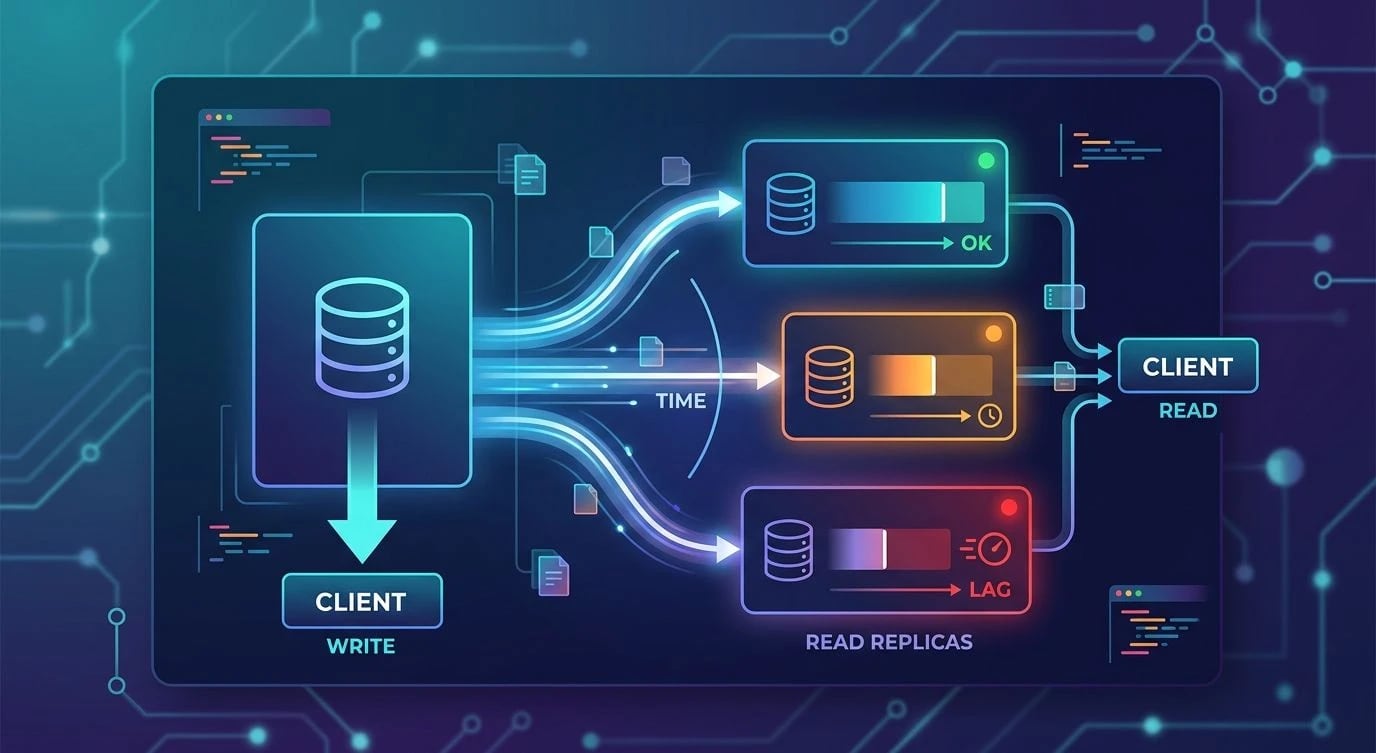
Backend
Replication Lag: Die versteckten Kosten von Read Replicas
Warum Read Replicas veraltete Daten liefern, wie Replication Lag Konsistenzannahmen bricht, und Patterns, um damit sicher umzugehen.
·4 Min. Lesezeit
Tags
20 Artikel · Seite 1 von 2
Warum Read Replicas veraltete Daten liefern, wie Replication Lag Konsistenzannahmen bricht, und Patterns, um damit sicher umzugehen.
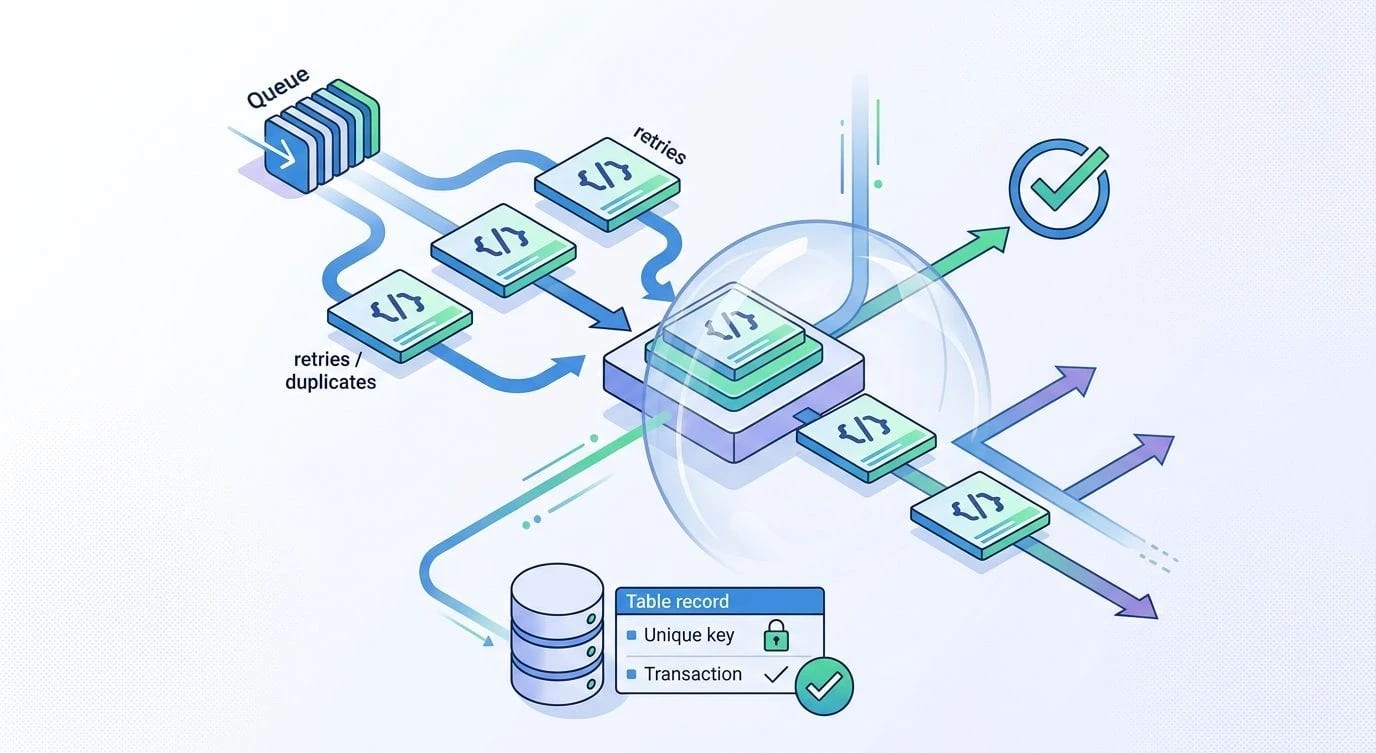
Exactly-Once gibt es in verteilten Systemen nicht – so entwirfst du Background-Jobs, die Retries, Abstürze und doppelte Zustellungen überstehen.
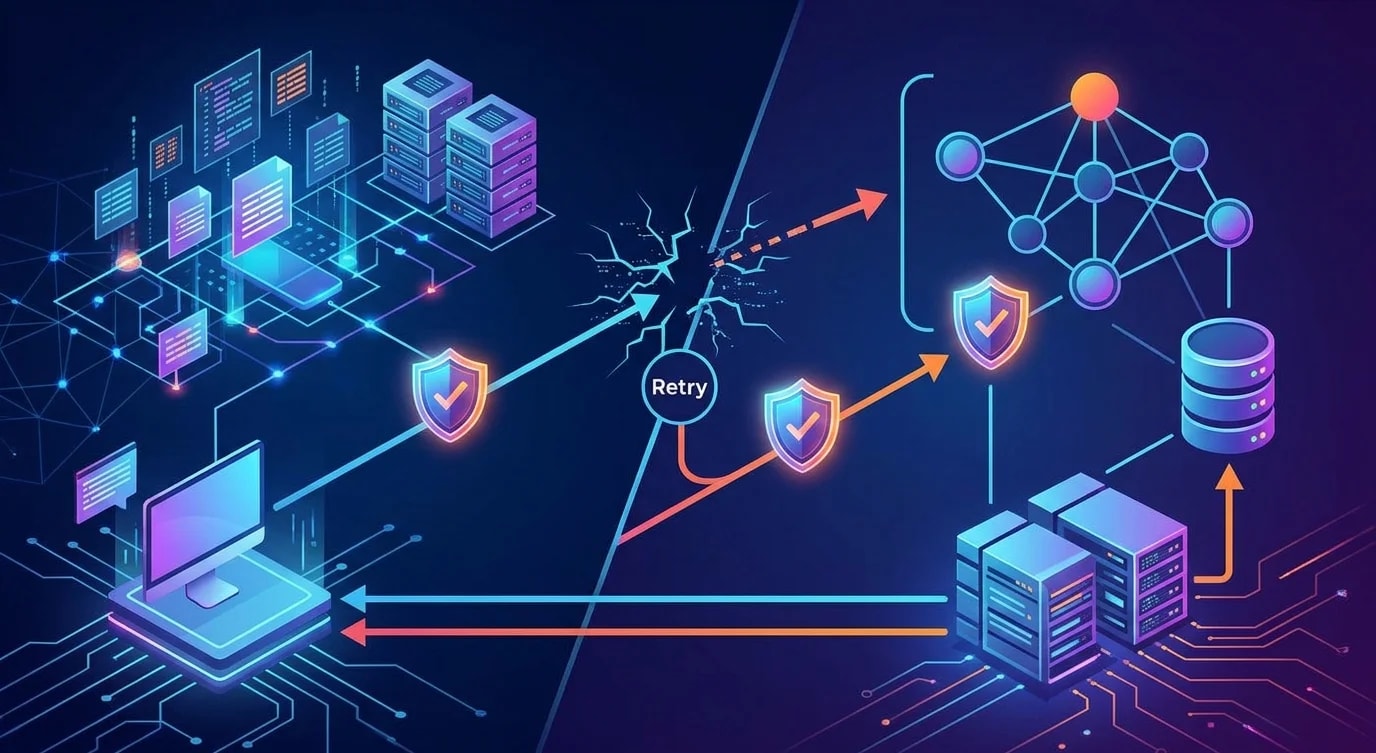
Wie man Idempotenzschlüssel entwirft und implementiert, damit wiederholte Anfragen nie doppelt abrechnen, doppelt senden oder doppelt Ressourcen anlegen.
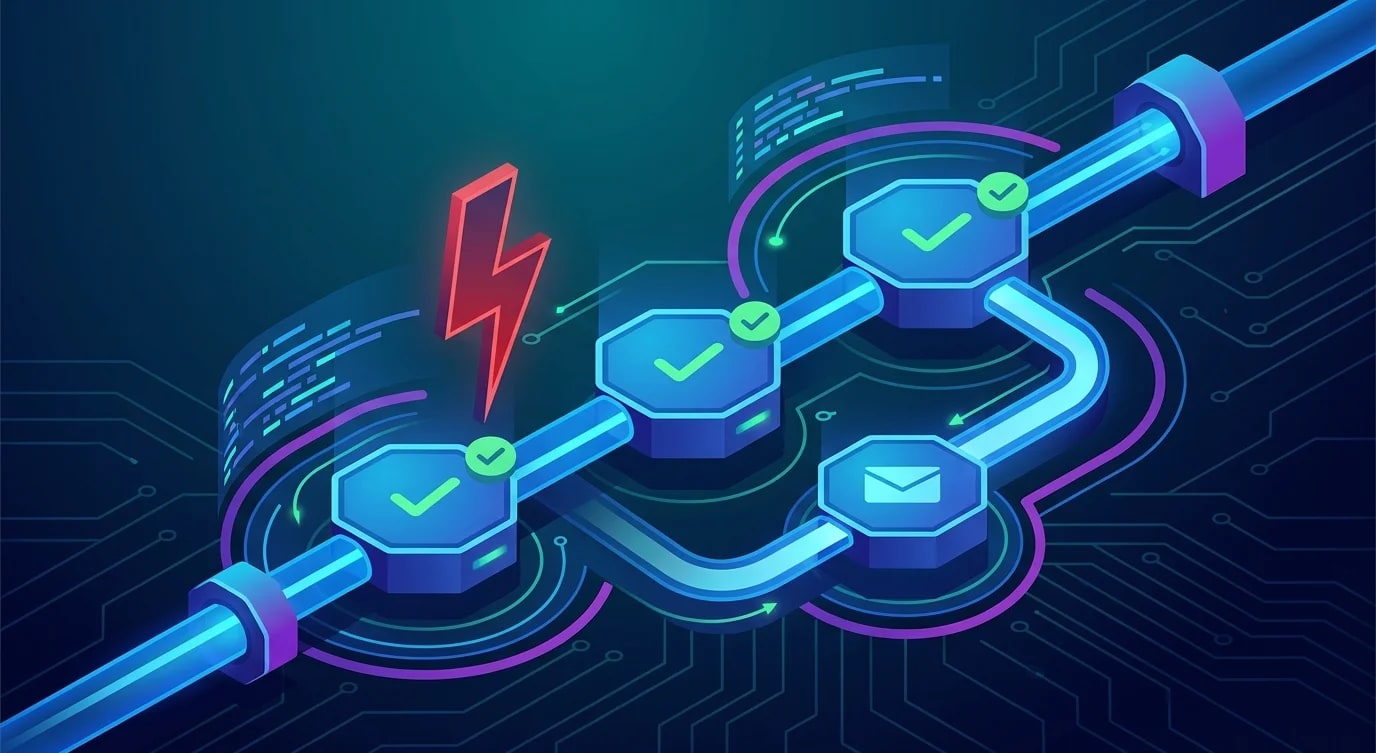
Warum Job-Queues und Datenbank-Zustandsmaschinen bei mehrstufigen Prozessen scheitern und wie Durable Execution mit Temporal Abstürze übersteht.

Wie das Transactional-Outbox-Pattern das Dual-Write-Problem löst und zuverlässiges Event-Publishing garantiert, ohne DB und Broker zu koppeln.
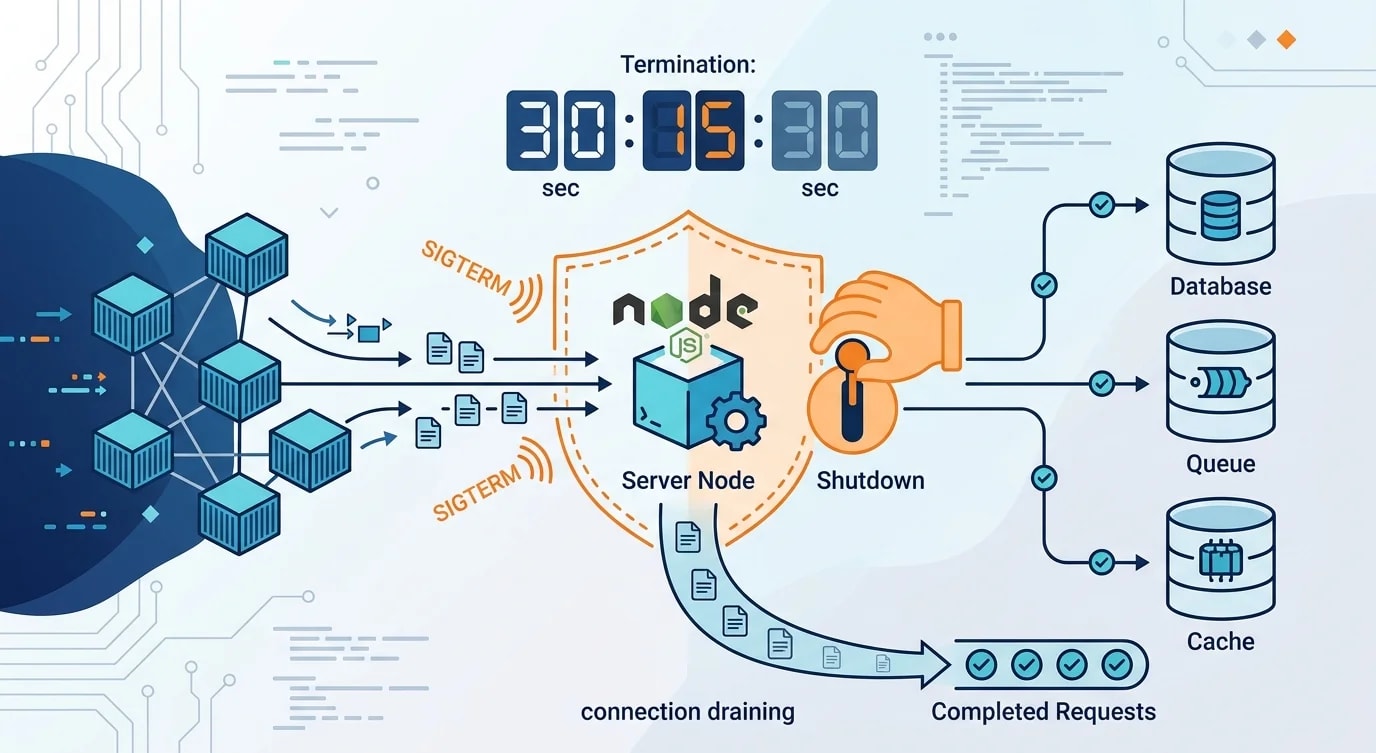
Die meisten Node.js-Dienste verlieren bei jedem Deployment laufende Requests: SIGTERM korrekt behandeln, Verbindungen drainen, sauber beenden.
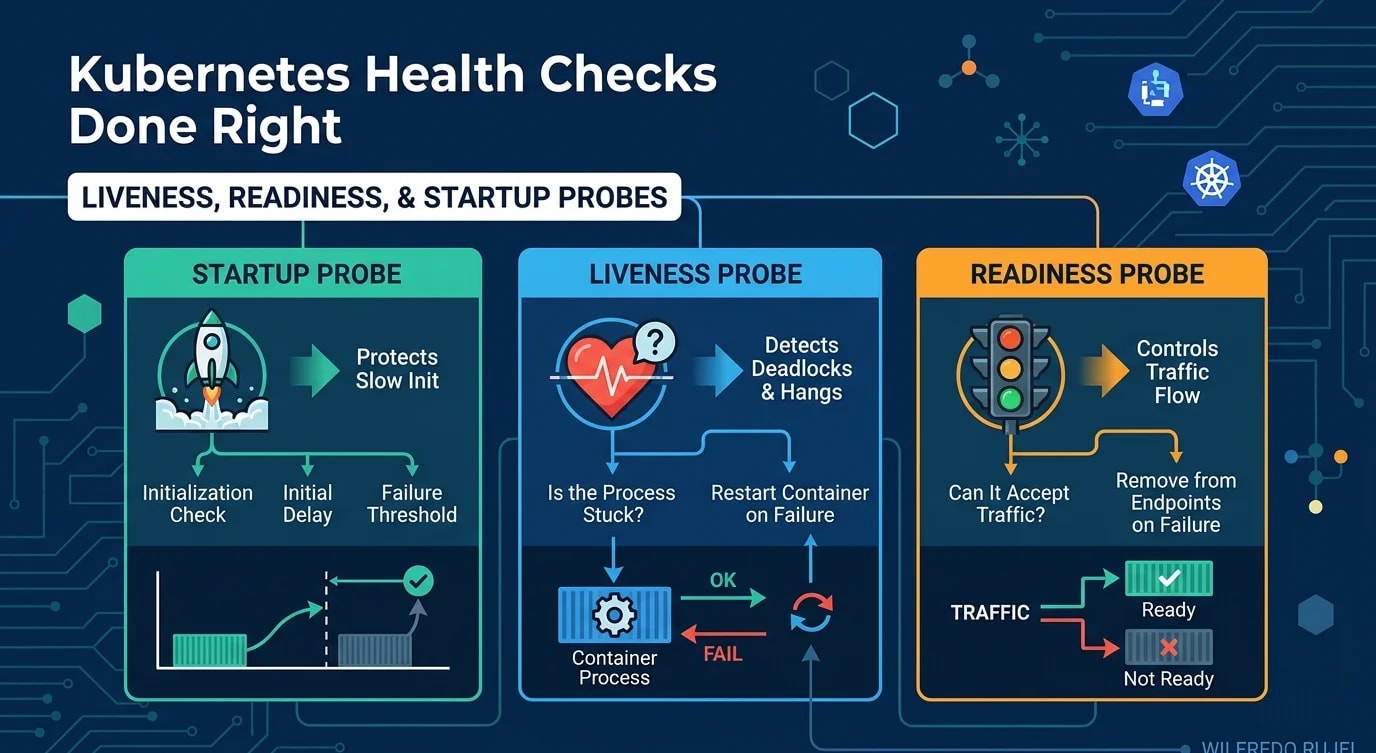
Konfiguriere Liveness-, Readiness- und Startup-Probes korrekt, um Kaskadenausfälle und unnötige Neustarts zu verhindern und Traffic richtig zu lenken.

Praktische Teststrategien für verteilte Architekturen: Contract Testing, Chaos Engineering, Integrationstests und Vertrauen ohne vollständige E2E.
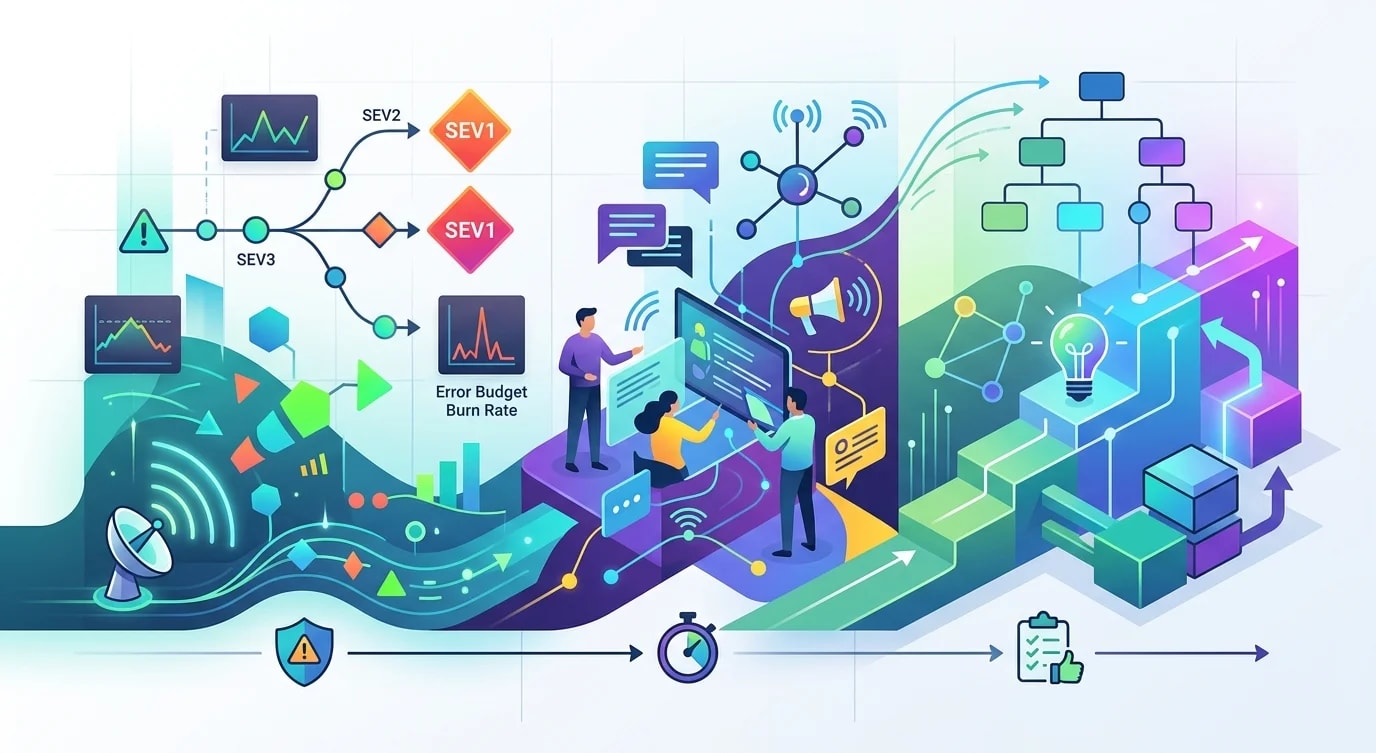
Ein systematischer Ansatz für Incident Management: Alert-Design, Schweregrade, On-Call-Workflows, Kommunikation und schuldfreie Post-Mortems.
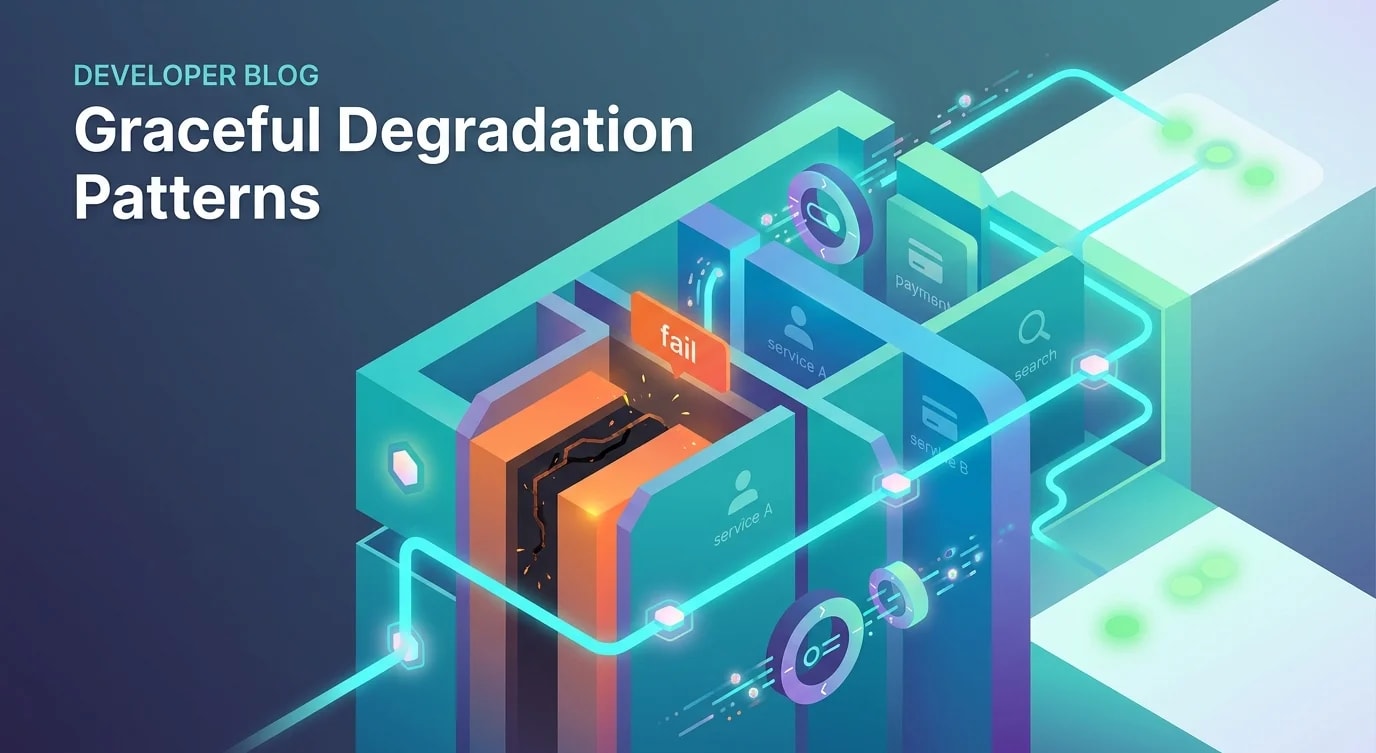
Fehlertoleranz in der Praxis: Circuit Breaker, Bulkheads, Fallback-Ketten und Degradationsstrategien, die Systeme bei Teilausfällen nutzbar halten.
Chaos Engineering in der Praxis: kontrollierte Fehler in Produktionssystemen aufdecken Schwachstellen — Netzwerkpartitionen, Ressourcen, Abhängigkeiten.

Baue idempotente API-Endpunkte mit Idempotency-Keys, Datenbank-Constraints und Zustandsautomaten — für Zahlungen, Bestellungen und Webhooks.