Replication Lag: Die versteckten Kosten von Read Replicas
Warum Read Replicas veraltete Daten liefern, wie Replication Lag Konsistenzannahmen bricht, und Patterns, um damit sicher umzugehen.
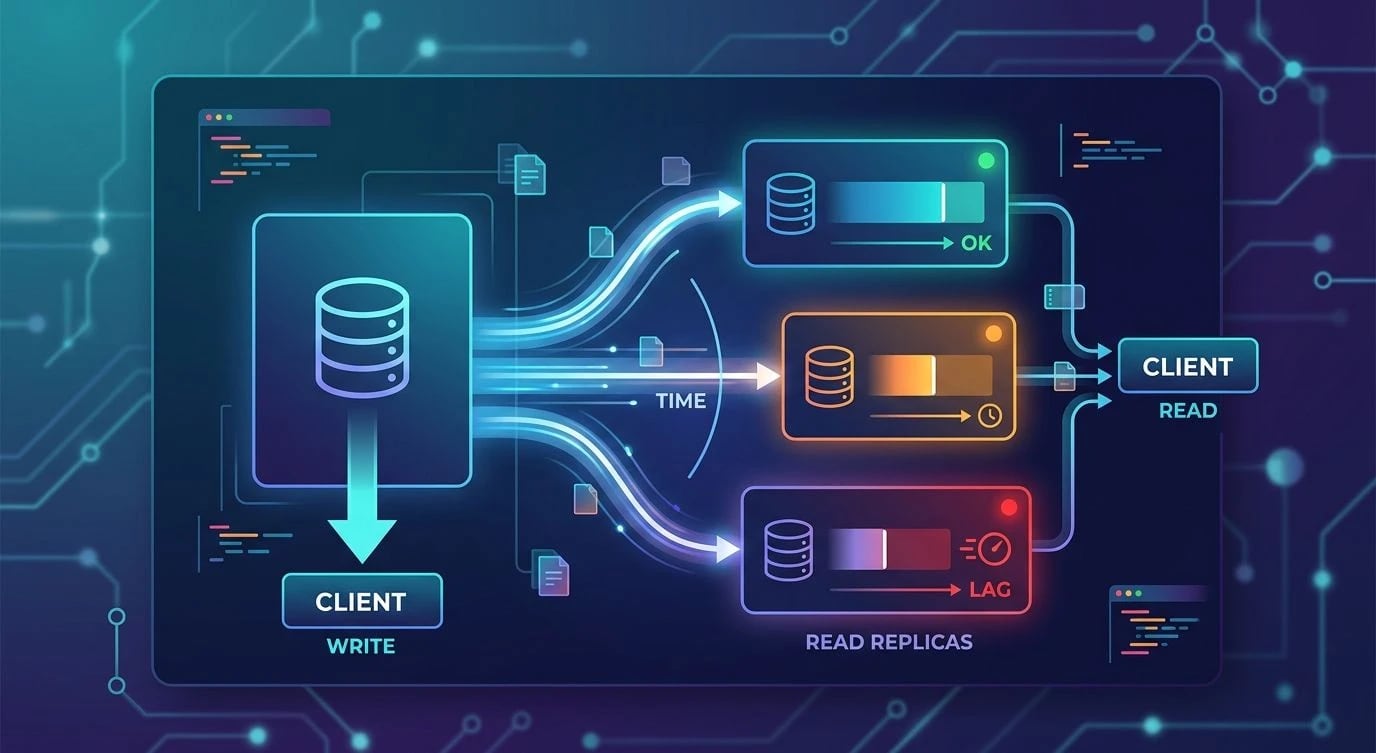
Jemand öffnet einen Pull Request, approved ihn, lädt die Seite neu, und das Approval ist weg. Jemand aktualisiert sein Profil, und für ein paar Sekunden blitzt der alte Name wieder auf. Nichts davon ist ein Bug im Anwendungscode — es ist Replication Lag, und das ist der Preis, den man für horizontale Skalierung von Reads zahlt.
Read Replicas sind meist der erste Skalierungshebel, zu dem Teams greifen, sobald eine einzelne Postgres-Instanz nicht mehr mithält. Sie sind billig hinzuzufügen und erfordern kaum Anwendungsänderungen — bis zu dem Moment, in dem ein User seinen eigenen Write von einer Replica liest, die noch nicht nachgezogen hat. Dann wird aus „kaum Anwendungsänderungen" ein Incident, der das halbe Team beschäftigt.
Wie Replikation tatsächlich Lag erzeugt
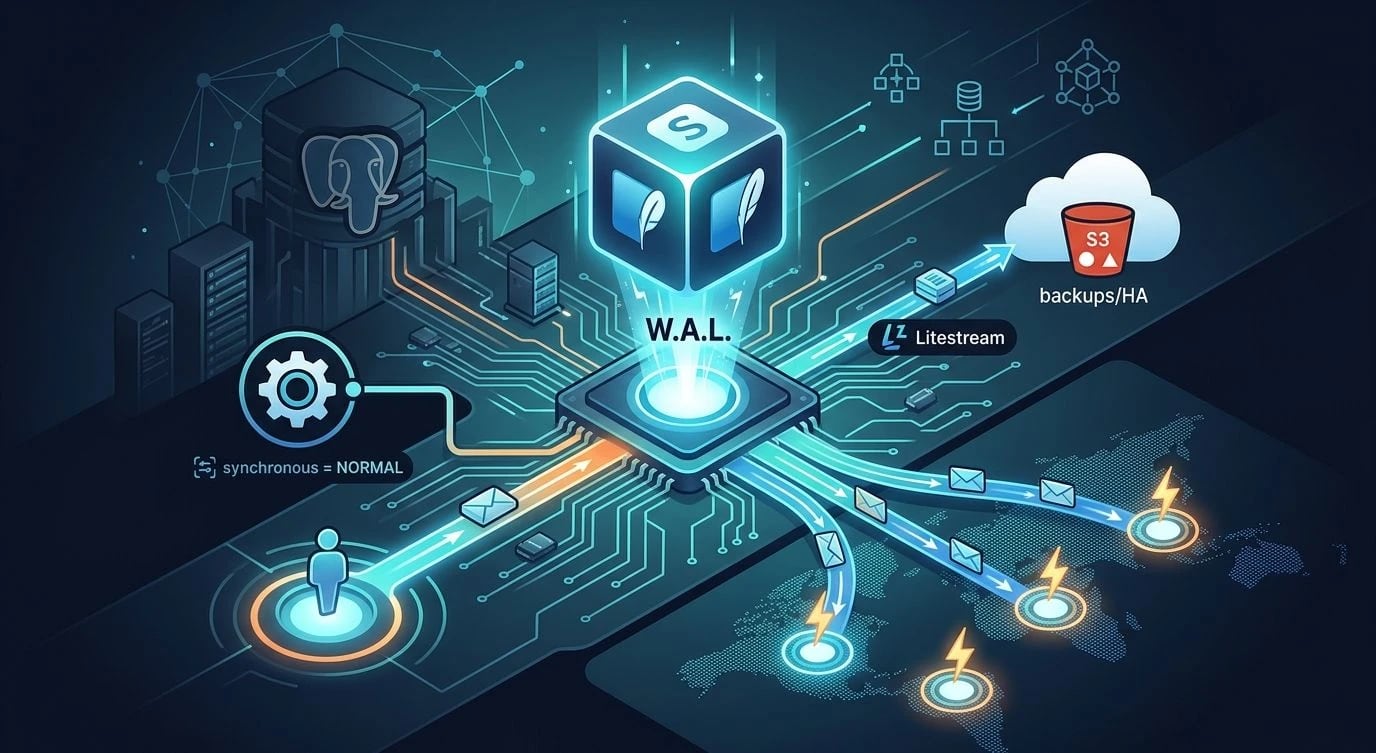
Streaming Replication in Postgres funktioniert, indem das Write-Ahead Log (WAL) vom Primary zu jeder Replica geschickt wird, die es dann abspielt, um denselben Zustand zu rekonstruieren. Das läuft standardmäßig asynchron ab: Der Primary committet eine Transaktion und meldet dem Client Erfolg zurück, bevor irgendeine Replica sie angewendet hat. Die PostgreSQL-Dokumentation zu Streaming Replication beschreibt das explizit — Durability auf dem Primary und Visibility auf der Replica sind zwei getrennte Garantien.
Lag ist keine feste Größe. Er wächst unter Last, bei Netzwerkpartitionen, durch lang laufende Queries auf der Replica (die das WAL-Apply blockieren können) und bei großen Batch-Writes auf dem Primary. Man kann ihn live beobachten:
-- Run on the primary: lag per connected replica, in bytes and seconds
SELECT
    client_addr,
    state,
    pg_wal_lsn_diff(pg_current_wal_lsn(), replay_lsn) AS lag_bytes,
    EXTRACT(EPOCH FROM (now() - reply_time)) AS lag_seconds
FROM pg_stat_replication;
Ein Lag von 50ms ist für die meisten User unsichtbar. Ein Lag von 3 Sekunden während eines Traffic-Spikes reicht locker, damit „Read your own write"-Bugs in Support-Tickets landen.
Synchrone Replikation (synchronous_commit = remote_apply) eliminiert den Lag für die synchronisierte Replica, bringt aber zusätzliche Write-Latenz und einen Single Point of Failure mit — fällt diese Replica aus, blockieren Writes. Das ist ein Werkzeug für eine spezifische Konsistenzgarantie, kein Default.
Das Bug-Pattern, das niemand im Staging findet
Das reproduziert sich fast nie in einer Dev-Umgebung mit einer einzigen Datenbank ohne Replicas. Es zeigt sich in Production unter Last, was die Diagnose teuer macht.
// ❌ Bad: write to primary, immediately read from the load-balanced pool
async function updateProfile(userId: string, name: string) {
  await primaryDb.query(
    "UPDATE users SET name = $1 WHERE id = $2", [name, userId]
  );

  // This read might hit a replica that hasn't applied the write yet
  const user = await replicaPool.query(
    "SELECT * FROM users WHERE id = $1", [userId]
  );
  return user.rows[0]; // stale name, confused user
}// ✅ Good: route reads that must reflect the just-committed write to
// the primary, and only send genuinely eventually-consistent reads
// to replicas
async function updateProfile(userId: string, name: string) {
const result = await primaryDb.query(
`UPDATE users SET name = $1
WHERE id = $2
RETURNING *`,
[name, userId]
);
return result.rows[0]; // no extra read-after-write round trip at all
}Die zweite Version umgeht das Problem komplett mit RETURNING. Das ist meist der günstigste Fix: Keinen separaten Read ausführen, wenn der Write bereits die benötigten Daten liefert.
Reads gezielt routen
Wenn wirklich ein nachgelagerter Read nötig ist — eine andere Query-Form, ein Join über Tabellen, die man nicht gerade beschrieben hat — braucht man eine explizite Policy dafür, wohin dieser Read geht, statt eines Load Balancers, der jede Replica als gleich aktuell behandelt.
| Read-Typ | Wohin er gehen sollte |
|---|---|
| Direkt nach einem Write desselben Users | Primary, oder dieselbe Replica via Session-Pinning |
| Dashboards, Analytics, Reports | Beliebige Replica |
| Suche, Listings, öffentliche Seiten | Beliebige Replica |
| Account-Einstellungen direkt nach dem Speichern | Primary |
Ein gängiger Mittelweg ist Session-Level-Konsistenz: Den User für ein kurzes Zeitfenster nach einem Write an dieselbe Replica (oder den Primary) binden, über eine Sticky-Kennung im Connection Pooler oder in der Anwendungsschicht.
// ✅ Session consistency: track the LSN of the user's last write and
// require the chosen replica to have caught up to it before routing
interface ReadRouter {
  getConnection(userId: string): Promise<PoolClient>;
}

class LagAwareRouter implements ReadRouter {
  constructor(
    private primary: Pool,
    private replicas: Pool[],
    private lastWriteLsn: Map<string, string>
  ) {}

  async getConnection(userId: string): Promise<PoolClient> {
    const requiredLsn = this.lastWriteLsn.get(userId);
    if (!requiredLsn) return this.replicas[0].connect();

    for (const replica of this.replicas) {
      const { rows } = await replica.query("SELECT pg_last_wal_replay_lsn()");
      if (rows[0].pg_last_wal_replay_lsn >= requiredLsn) {
        return replica.connect();
      }
    }
    // No replica is caught up — fall back to the primary rather than
    // serve a stale read
    return this.primary.connect();
  }
}
Das bringt zusätzliche Komplexität mit sich, also sollte man es nur dort einsetzen, wo Staleness tatsächlich ein sichtbares Problem für User verursacht — Checkout-Bestätigungen, Berechtigungsänderungen, alles Sicherheitsrelevante. Für das Analytics-Dashboard braucht es kein lag-bewusstes Routing.
Lag als Production-Metrik überwachen, nicht als Nachgedanke
Managed Services wie Amazon RDS stellen ReplicaLag als erstklassige CloudWatch-Metrik bereit — genau deshalb, weil sie der Frühindikator für Read-Correctness-Incidents ist, nicht nur eine Performance-Kennzahl. Wer selbst hostet, sollte pg_stat_replication genauso scrapen wie Queue-Tiefe.
Setzt Alerts an zwei Schwellenwerten:
- Soft Threshold (1–2s): nachforschen — wahrscheinlich eine langsame Query oder ein Write-Burst.
- Hard Threshold (10s+): automatisch aufhören, neue Sessions an die hinterherhinkende Replica zu routen, und paging auslösen, wenn es anhält.
# Prometheus alerting rule for Postgres replication lag
groups:
  - name: postgres-replication
    rules:
      - alert: ReplicationLagHigh
        expr: pg_replication_lag_seconds > 10
        for: 2m
        labels:
          severity: warning
        annotations:
          summary: "Replica {{ $labels.instance }} lagging {{ $value }}s"
Ohne das ist das erste Signal ein Support-Ticket, und bis man es mit einer bestimmten Replica korreliert hat, die während eines Deploys zurückgefallen ist, ist der Incident längst gelöst und die Root Cause verschwunden.
Die wichtigsten Punkte
- Asynchrone Replikation bedeutet: Ein committeter Write ist nirgendwo garantiert sichtbar außer auf dem Primary — das ist dokumentiertes Verhalten, kein Bug.
RETURNINGoder ein Read über dieselbe Connection, die den Write ausgeführt hat, ist einer separaten Read-after-Write-Query gegen einen Replica-Pool vorzuziehen.- Reads explizit klassifizieren: Session-sensitive Reads gehen zum Primary oder über eine lag-bewusste Route, alles andere verträgt eine Replica.
- Synchrone Replikation nur für die spezifische Garantie einsetzen, die man braucht — sie tauscht Verfügbarkeit und Latenz gegen Aktualität, sie hebt den Tradeoff nicht auf.
- Lag als Production-Metrik mit Alert-Schwellenwerten überwachen, statt es erst zu entdecken, wenn ein User sich beschwert, seine Daten seien „verschwunden".
- Read Replicas von Anfang an als eventually-consistent System behandeln — für Staleness designen, statt zu hoffen, dass sie klein genug bleibt, um sie zu ignorieren.