Retraso de replicación: el costo oculto de las réplicas de lectura
Por qué las réplicas de lectura causan lecturas obsoletas, cómo el retraso de replicación rompe la consistencia y patrones prácticos para manejarlo.
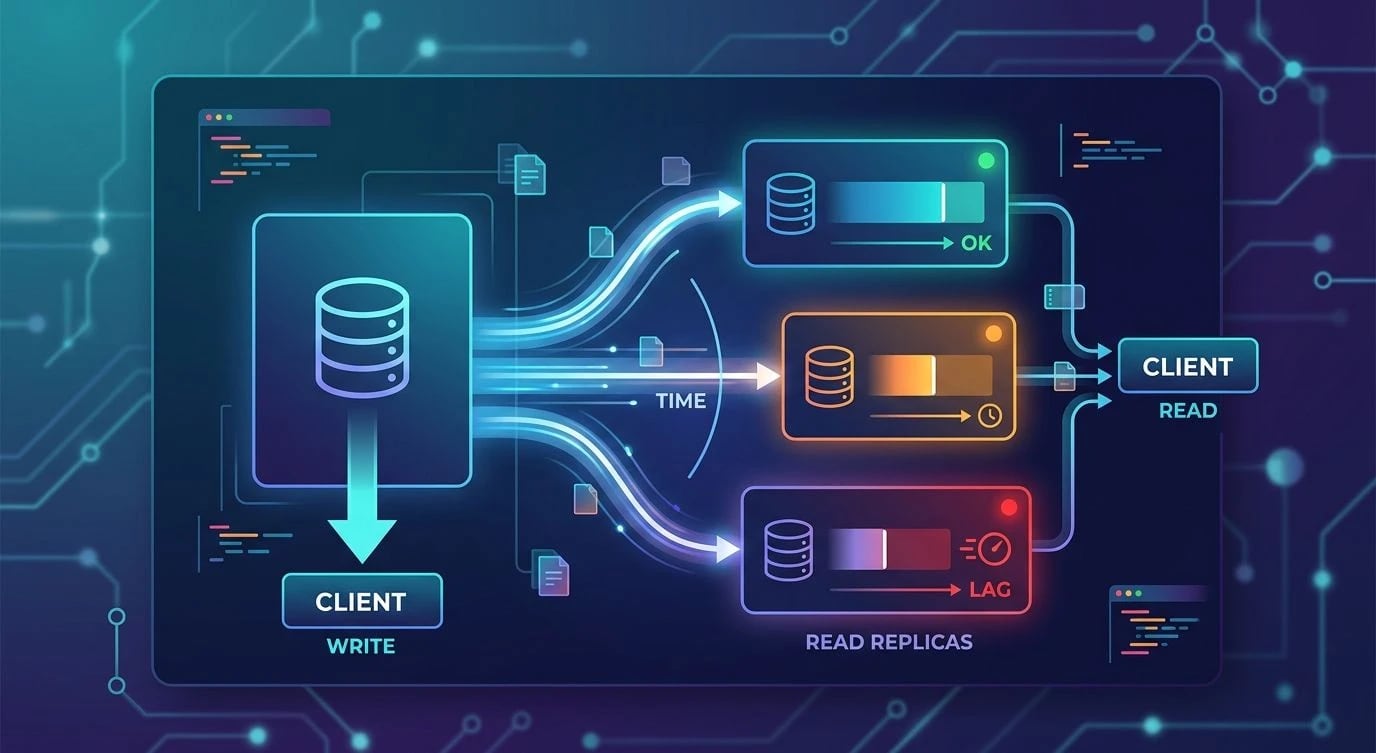
Alguien abre un pull request, lo aprueba, recarga la página y la aprobación desaparece. Alguien actualiza su perfil y el nombre anterior vuelve a aparecer por unos segundos. Nada de esto es un bug en el código de tu aplicación: es retraso de replicación, el impuesto que pagas por escalar lecturas horizontalmente.
Las réplicas de lectura son la primera palanca de escalado a la que recurre la mayoría de los equipos cuando una sola instancia de Postgres ya no da abasto. Son baratas de agregar y casi no requieren cambios en la aplicación... hasta el momento en que un usuario lee su propia escritura desde una réplica que todavía no se puso al día. En ese punto, el "casi no requieren cambios en la aplicación" se convierte en un incidente que moviliza a todo el equipo.
Cómo la replicación introduce retraso en realidad
La replicación en streaming de Postgres funciona enviando el write-ahead log (WAL) desde la primaria a cada réplica, que lo reproduce para reconstruir el mismo estado. Esto es asíncrono por defecto: la primaria confirma (commit) una transacción y devuelve éxito al cliente antes de que ninguna réplica la haya aplicado. La documentación de PostgreSQL sobre replicación en streaming lo describe explícitamente: la durabilidad en la primaria y la visibilidad en la réplica son dos garantías separadas.
El retraso no es un número fijo. Crece bajo carga, con particiones de red, con consultas de larga duración en la réplica (que pueden bloquear la aplicación del WAL) y con escrituras masivas por lotes en la primaria. Puedes observarlo en tiempo real:
-- Run on the primary: lag per connected replica, in bytes and seconds
SELECT
    client_addr,
    state,
    pg_wal_lsn_diff(pg_current_wal_lsn(), replay_lsn) AS lag_bytes,
    EXTRACT(EPOCH FROM (now() - reply_time)) AS lag_seconds
FROM pg_stat_replication;
Un retraso de 50ms es invisible para la mayoría de los usuarios. Un retraso de 3 segundos durante un pico de tráfico es justo lo suficiente para que los bugs de "leer tu propia escritura" aparezcan en los tickets de soporte.
La replicación síncrona (synchronous_commit = remote_apply) elimina el retraso para la réplica sincronizada, pero agrega latencia de escritura y un punto único de falla: si esa réplica cae, las escrituras se bloquean. Trátala como una herramienta para una garantía de consistencia específica, no como una opción por defecto.
El patrón de bug que nadie detecta en staging
Esto casi nunca se reproduce en un entorno de desarrollo con una sola base de datos y sin réplicas. Aparece en producción bajo carga, lo que hace que sea costoso de diagnosticar.
// ❌ Bad: write to primary, immediately read from the load-balanced pool
async function updateProfile(userId: string, name: string) {
  await primaryDb.query(
    "UPDATE users SET name = $1 WHERE id = $2", [name, userId]
  );

  // This read might hit a replica that hasn't applied the write yet
  const user = await replicaPool.query(
    "SELECT * FROM users WHERE id = $1", [userId]
  );
  return user.rows[0]; // stale name, confused user
}// ✅ Good: route reads that must reflect the just-committed write to
// the primary, and only send genuinely eventually-consistent reads
// to replicas
async function updateProfile(userId: string, name: string) {
const result = await primaryDb.query(
`UPDATE users SET name = $1
WHERE id = $2
RETURNING *`,
[name, userId]
);
return result.rows[0]; // no extra read-after-write round trip at all
}La segunda versión evita el problema por completo usando RETURNING. Normalmente esa es la solución más barata: no hagas una lectura separada si la escritura ya te da los datos que necesitas.
Enrutar lecturas con intención
Cuando realmente necesitas una lectura posterior —una consulta con otra forma, un join con tablas en las que no acabas de escribir—, necesitas una política explícita sobre a dónde va esa lectura, no un balanceador de carga que trate a todas las réplicas como igual de frescas.
| Tipo de lectura | A dónde debería ir |
|---|---|
| Inmediatamente después de una escritura del mismo usuario | Primaria, o la misma réplica mediante session pinning |
| Dashboards, analítica, reportes | Cualquier réplica |
| Búsqueda, listados, páginas públicas | Cualquier réplica |
| Configuración de cuenta justo después de guardar | Primaria |
Un punto medio común es la consistencia a nivel de sesión: fijar a un usuario a la misma réplica (o a la primaria) durante una ventana corta después de escribir, usando un identificador "sticky" en el connection pooler o en la capa de la aplicación.
// ✅ Session consistency: track the LSN of the user's last write and
// require the chosen replica to have caught up to it before routing
interface ReadRouter {
  getConnection(userId: string): Promise<PoolClient>;
}

class LagAwareRouter implements ReadRouter {
  constructor(
    private primary: Pool,
    private replicas: Pool[],
    private lastWriteLsn: Map<string, string>
  ) {}

  async getConnection(userId: string): Promise<PoolClient> {
    const requiredLsn = this.lastWriteLsn.get(userId);
    if (!requiredLsn) return this.replicas[0].connect();

    for (const replica of this.replicas) {
      const { rows } = await replica.query("SELECT pg_last_wal_replay_lsn()");
      if (rows[0].pg_last_wal_replay_lsn >= requiredLsn) {
        return replica.connect();
      }
    }
    // No replica is caught up — fall back to the primary rather than
    // serve a stale read
    return this.primary.connect();
  }
}
Esto agrega complejidad, así que resérvalo para los flujos donde la obsolescencia realmente causa un problema visible para el usuario: confirmaciones de checkout, cambios de permisos, cualquier cosa relacionada con seguridad. No construyas enrutamiento consciente del retraso para tu dashboard de analítica.
Monitorear el retraso como una métrica de producción, no como un detalle secundario
Servicios administrados como Amazon RDS exponen ReplicaLag como una métrica de primera clase en CloudWatch precisamente porque es el indicador principal de incidentes de corrección en las lecturas, no solo una estadística de rendimiento. Si haces self-hosting, recolecta pg_stat_replication de la misma forma en que recolectarías la profundidad de una cola.
Configura alertas en dos umbrales:
- Umbral suave (1-2s): investiga — probablemente una consulta lenta o una ráfaga de escrituras.
- Umbral crítico (10s+): deja de enrutar automáticamente nuevas sesiones a la réplica rezagada, y envía una alerta (page) si persiste.
# Prometheus alerting rule for Postgres replication lag
groups:
  - name: postgres-replication
    rules:
      - alert: ReplicationLagHigh
        expr: pg_replication_lag_seconds > 10
        for: 2m
        labels:
          severity: warning
        annotations:
          summary: "Replica {{ $labels.instance }} lagging {{ $value }}s"
Sin esto, la primera señal que recibes es un ticket de soporte, y para cuando logras correlacionarlo con una réplica específica que se quedó atrás durante un deploy, el incidente ya se resolvió solo y la causa raíz desapareció.
Puntos clave
- La replicación asíncrona significa que una escritura confirmada no tiene garantizada su visibilidad en ningún lugar excepto en la primaria — es un comportamiento documentado, no un bug.
- Prefiere
RETURNINGo leer desde la misma conexión que realizó la escritura, en lugar de una consulta separada de lectura-tras-escritura contra un pool de réplicas. - Clasifica las lecturas explícitamente: las lecturas sensibles a la sesión van a la primaria o a una ruta consciente del retraso; todo lo demás puede tolerar una réplica.
- Reserva la replicación síncrona para la garantía específica que necesitas: intercambia disponibilidad y latencia por frescura, no elimina el trade-off.
- Monitorea el retraso como una métrica de producción con umbrales de alerta, no algo que solo descubres cuando un usuario se queja de que sus datos "desaparecieron".
- Trata a las réplicas de lectura como un sistema eventualmente consistente desde el primer día: diseña para la obsolescencia en lugar de esperar que se mantenga lo bastante pequeña como para ignorarla.