Backend
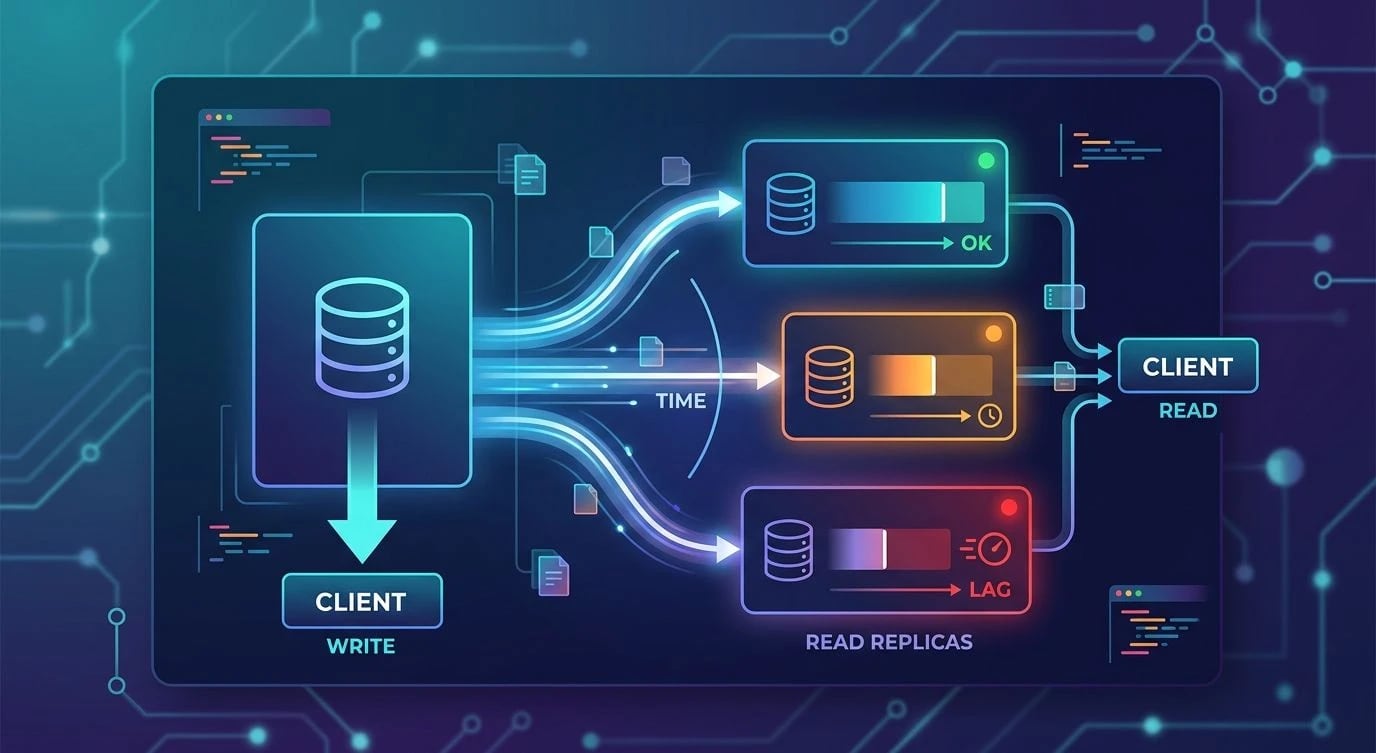
Retraso de replicación: el costo oculto de las réplicas de lectura
Por qué las réplicas de lectura causan lecturas obsoletas, cómo el retraso de replicación rompe la consistencia y patrones prácticos para manejarlo.
·5 min de lectura
Etiquetas
39 artículos · Página 1 de 4
Por qué las réplicas de lectura causan lecturas obsoletas, cómo el retraso de replicación rompe la consistencia y patrones prácticos para manejarlo.
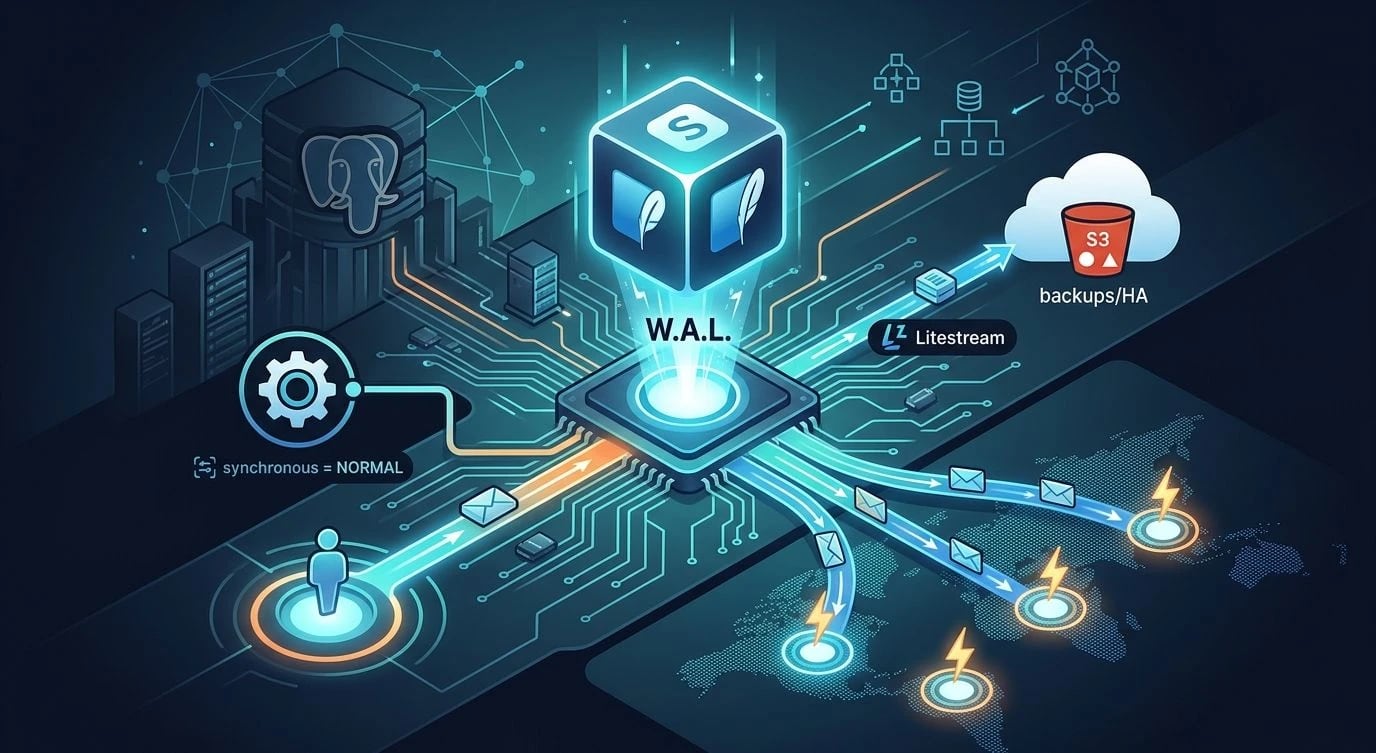
Con modo WAL y la estrategia de réplica correcta, SQLite corre cargas de producción con menos overhead operativo que Postgres.
HTTP/3 reemplaza TCP por QUIC sobre UDP y elimina el head-of-line blocking en la capa de transporte: esto es lo que cambia para tus servicios.
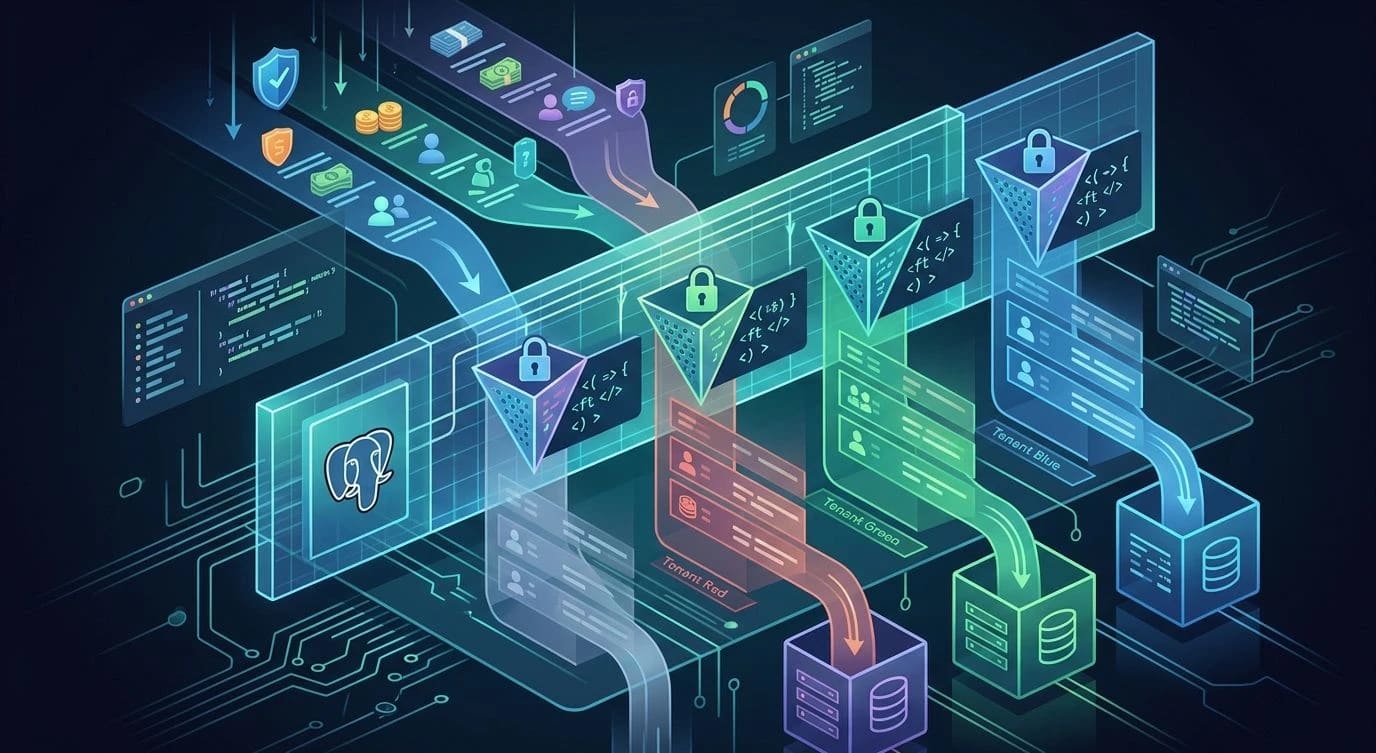
Cómo forzar el aislamiento de tenants en la propia base de datos con Postgres RLS, en vez de confiar en que el código recuerde una cláusula WHERE.

Los soft deletes parecen una red de seguridad, pero corrompen el esquema, contaminan las consultas y rompen restricciones: qué usar en su lugar.
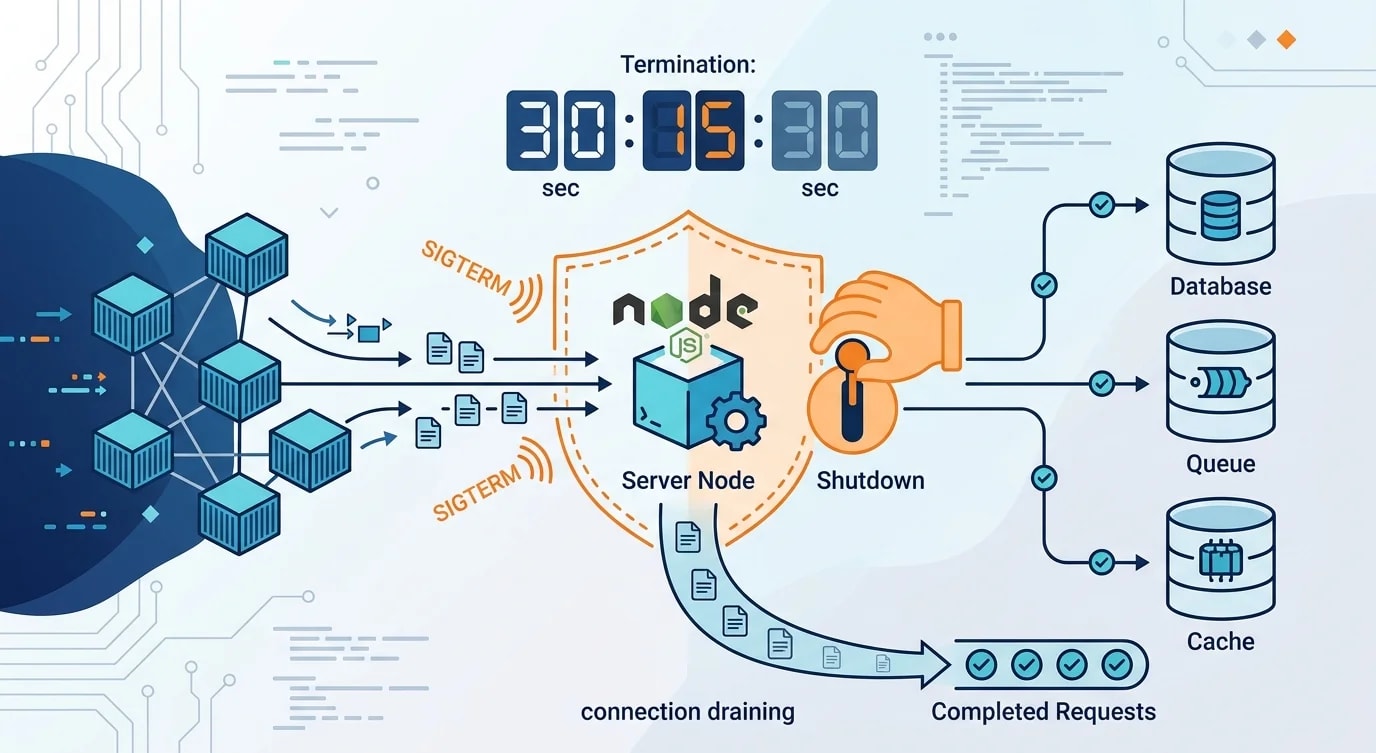
La mayoría de servicios Node.js descartan peticiones en curso en cada despliegue: cómo manejar SIGTERM, drenar conexiones y salir limpio en Kubernetes.

El sistema de tipos de TypeScript se detiene al compilar: Zod cierra la brecha validando los datos en los límites de ejecución, donde de verdad importa.

Una guía práctica de las cabeceras de caché HTTP — qué hace realmente cada directiva, cuándo usar ETags y cómo dejar de pelearte con tu CDN.

Guía práctica de tipado seguro de extremo a extremo en GraphQL con generación desde el esquema: resolvers tipados, tipos de consulta y cero discrepancias.
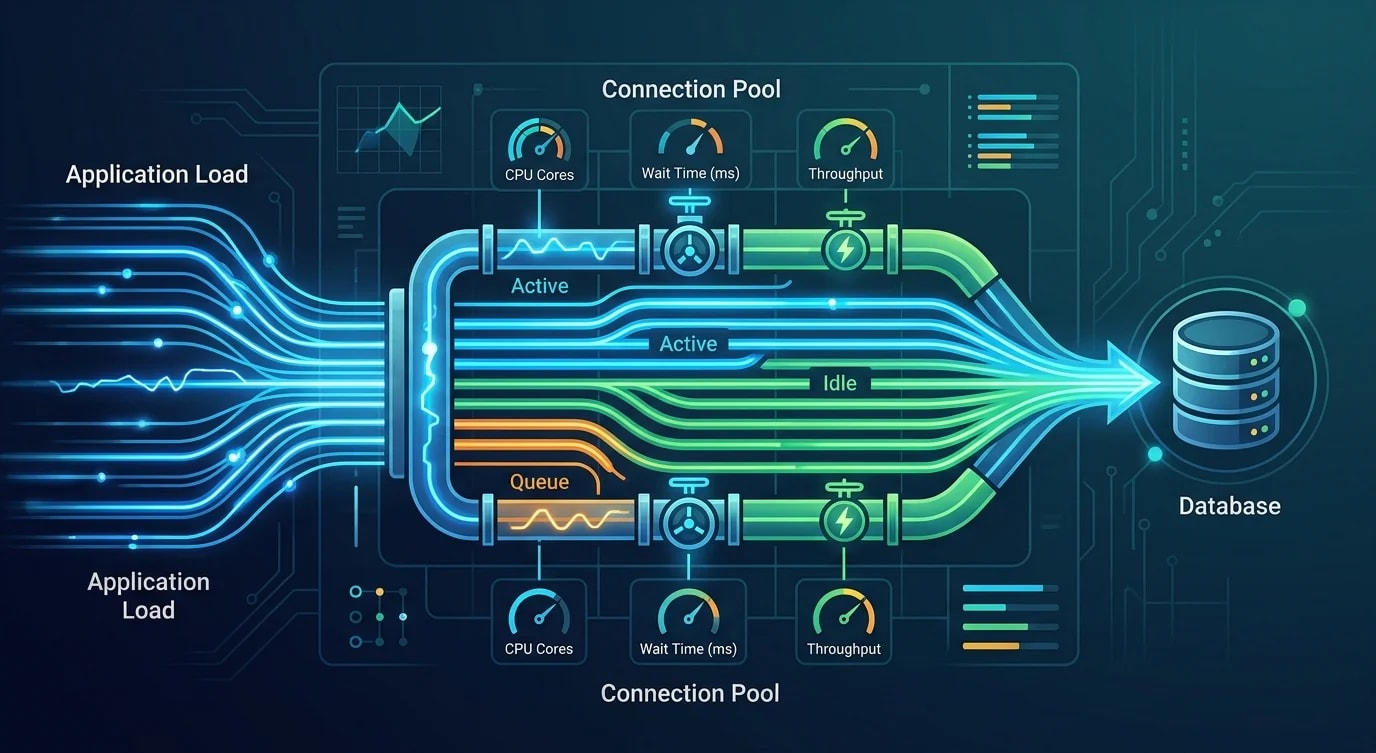
Análisis a fondo de la configuración del pool: fórmulas de dimensionado, ciclo de vida, comprobaciones de salud y diagnóstico del agotamiento en producción.

Análisis detallado de token bucket, sliding window y leaky bucket, con implementaciones distribuidas en Redis y patrones prácticos de middleware.

Implementa migraciones de esquema sin downtime con patrones expandir-contraer, cambios retrocompatibles y despliegues por fases que no cortan el tráfico.