Apagado controlado en servicios Node.js en producción
La mayoría de servicios Node.js descartan peticiones en curso en cada despliegue: cómo manejar SIGTERM, drenar conexiones y salir limpio en Kubernetes.
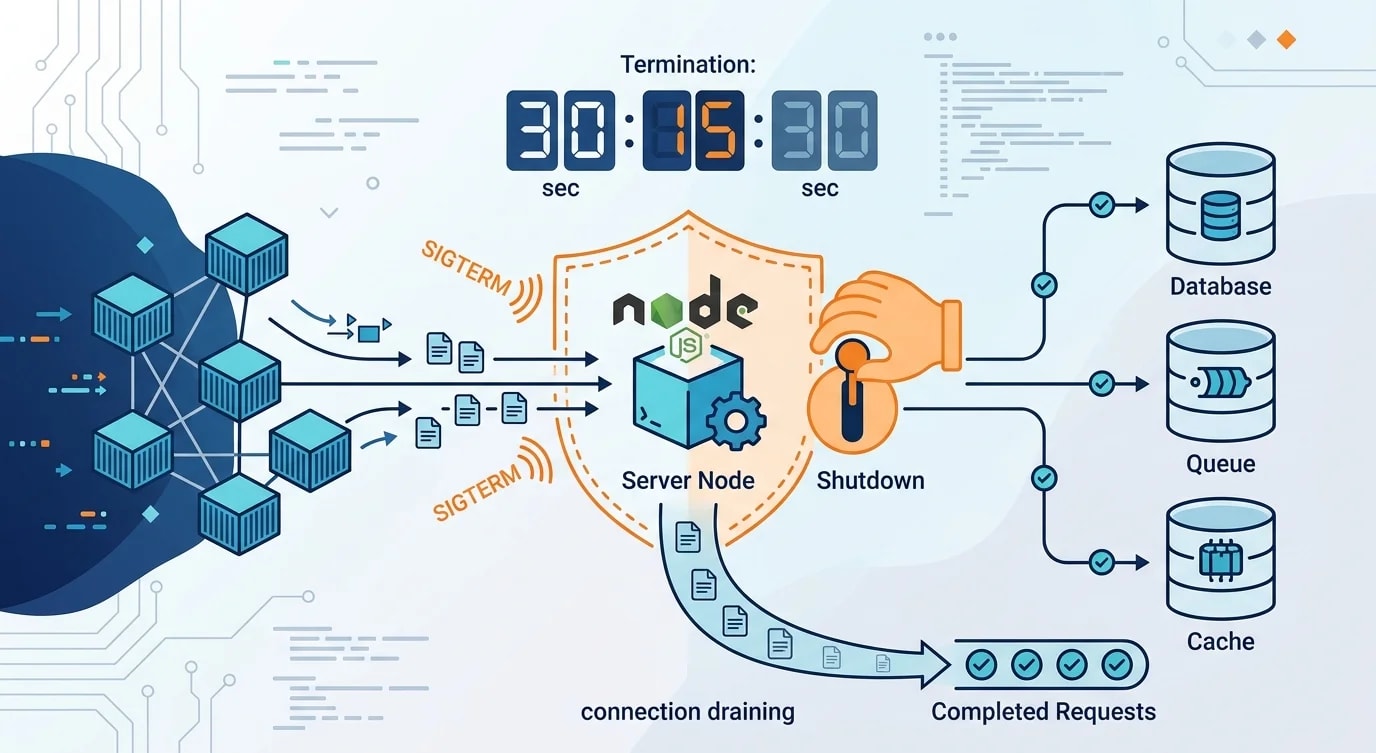
Cada vez que despliegas un servicio Node.js sin un manejador de apagado adecuado, estás jugando con las solicitudes en curso. El proceso recibe SIGTERM, Node.js lo ignora por defecto, Kubernetes eventualmente envía SIGKILL, y cualquier solicitud en curso recibe un error de conexión reiniciada. Esto ocurre en cada despliegue gradual, cada expulsión de pod y cada evento de reducción de escala.
La mayoría de los equipos solo descubren el problema a través de reportes de usuarios: 503 intermitentes durante despliegues pico que son difíciles de reproducir localmente. La solución no es complicada, pero requiere entender exactamente qué ocurre durante la secuencia de terminación de Kubernetes y conectar algunas piezas en el orden correcto.
Qué ocurre sin un manejador de apagado
Cuando Kubernetes termina un pod, envía SIGTERM al PID 1. Node.js no registra un manejador por defecto para SIGTERM — la señal se ignora en silencio hasta que terminationGracePeriodSeconds (por defecto: 30 segundos) expire y llegue SIGKILL. En ese punto el SO mata el proceso por la fuerza. Sin limpieza, sin drenaje, sin negociación.
// ❌ Common pattern — process dies abruptly on SIGKILL
const app = express();
const server = app.listen(3000);

// No SIGTERM handler. In-flight requests dropped.
// DB connections closed mid-transaction.
// Queue messages unacknowledged.
Ese comportamiento roto es invisible en desarrollo porque reinicias manualmente con Ctrl+C, que envía SIGINT y Node.js sí lo maneja por defecto. En producción es otra historia.
Un servicio bien comportado debe hacer cuatro cosas cuando recibe SIGTERM:
- Dejar de aceptar conexiones nuevas
- Esperar a que terminen las solicitudes en curso
- Cerrar las conexiones descendientes (base de datos, caché, colas)
- Salir con código
0
Registro de manejadores de señales
Los manejadores de señales deben registrarse temprano, antes de que el servidor inicie, antes de que se establezca cualquier conexión. Si el proceso falla durante el arranque antes de que los manejadores estén registrados, es aceptable. Una vez el servidor está vivo, necesita una ruta de salida limpia.
// ✅ Register before server.listen() — handles both Kubernetes and local dev
function registerShutdownHandlers(shutdown: () => Promise<void>): void {
  let isShuttingDown = false;

  const handler = async (signal: string) => {
    // Guard against duplicate signals — Kubernetes can send SIGTERM more than once
    if (isShuttingDown) return;
    isShuttingDown = true;

    console.log(`[shutdown] Received ${signal}. Starting graceful shutdown...`);

    try {
      await shutdown();
      console.log("[shutdown] Complete. Exiting.");
      process.exit(0);
    } catch (err) {
      console.error("[shutdown] Error during shutdown:", err);
      process.exit(1);
    }
  };

  process.on("SIGTERM", () => handler("SIGTERM")); // Kubernetes, docker stop
  process.on("SIGINT", () => handler("SIGINT"));   // Ctrl+C in development
}
El guarda isShuttingDown importa. Kubernetes ocasionalmente envía SIGTERM más de una vez antes de SIGKILL, y los desarrolladores que ejecutan localmente a veces presionan Ctrl+C repetidamente. Ejecutar dos secuencias de apagado en paralelo es peor que ejecutar una.
Drenaje de solicitudes HTTP en curso
server.close() detiene al servidor de aceptar nuevas conexiones TCP, pero tiene una limitación bien conocida: no cierra las conexiones keep-alive existentes. Un cliente con una conexión keep-alive abierta mantiene un socket abierto indefinidamente, lo que significa que server.close() puede quedarse bloqueado durante todo el periodo de gracia antes de que Kubernetes envíe SIGKILL.
La solución es rastrear las conexiones activas y forzar el cierre de las inactivas tras un tiempo de espera:
import { Server, IncomingMessage, ServerResponse } from "http";

function createDrainableServer(server: Server): {
  closeWithDrain: (timeoutMs?: number) => Promise<void>;
} {
  const connections = new Set<import("net").Socket>();

  server.on("connection", (socket) => {
    connections.add(socket);
    socket.on("close", () => connections.delete(socket));
  });

  const closeWithDrain = (timeoutMs = 10_000): Promise<void> => {
    return new Promise((resolve, reject) => {
      server.close((err) => {
        if (err) reject(err);
        else resolve();
      });

      // Destroy idle keep-alive connections immediately
      for (const socket of connections) {
        socket.destroy();
      }

      setTimeout(() => {
        reject(new Error(`Server drain timed out after ${timeoutMs}ms`));
      }, timeoutMs).unref();
    });
  };

  return { closeWithDrain };
}
Para servicios con alta utilización de keep-alive esto importa mucho. Destruir los sockets inactivos de inmediato permite que la ventana de drenaje se centre en las solicitudes realmente en curso en lugar de esperar a que los clientes noten que la conexión está muerta.
Configura tu tiempo de espera interno de drenaje 5 segundos menor que terminationGracePeriodSeconds. Si Kubernetes te da 30 segundos, apunta a salir antes de 25 — deja un margen para la contabilidad del apagado.
Cierre de dependencias descendientes en el orden correcto
Los pools de base de datos, los consumidores de colas y los clientes de caché necesitan un cierre explícito. El orden no es arbitrario: hacerlo mal causa corrupción de datos o procesamiento duplicado de mensajes.
interface ServiceDependencies {
  db: import("pg").Pool;
  cache: import("redis").RedisClientType;
  consumer: import("kafkajs").Consumer;
}

async function closeDependencies(deps: ServiceDependencies): Promise<void> {
  // 1. Stop consuming new messages before anything else.
  //    An in-flight message may need the DB — don't close it first.
  await deps.consumer.stop();
  await deps.consumer.disconnect();

  // 2. Flush and close cache client
  await deps.cache.quit();

  // 3. Close database pool last — lets any final writes from the consumer land
  await deps.db.end();
}
El error común es cerrar la base de datos primero. Si un consumidor de colas está a medio procesar un mensaje que requiere una escritura en base de datos, cerrar el pool por debajo deja el mensaje sin acuse de recibo. El broker de mensajes lo reenviará, y habrás introducido un escenario de procesamiento duplicado que tu lógica de idempotencia puede o no manejar.
La carrera de propagación de endpoints en Kubernetes
Hay una condición de carrera sutil en Kubernetes que incluso equipos con manejadores de apagado adecuados pasan por alto. Cuando se termina un pod, ocurren dos cosas en paralelo:
- Se envía
SIGTERMal pod - La IP del pod se elimina del objeto
Endpoints
El problema: la propagación de endpoints es eventualmente consistente. kube-proxy y tu controlador de ingress actualizan sus tablas de enrutamiento de forma asíncrona. Durante 200–500 milisegundos después de enviar SIGTERM, el balanceador de carga puede seguir enrutando solicitudes nuevas al pod que se está terminando. Si dejas de aceptar conexiones inmediatamente al recibir SIGTERM, esas solicitudes fallan con conexión rechazada.
La solución es barata: esperar brevemente antes de iniciar el drenaje real.
async function gracefulShutdown(
  server: ReturnType<typeof createDrainableServer>,
  deps: ServiceDependencies,
): Promise<void> {
  // Allow time for load balancer to drain traffic from this pod.
  // Endpoint propagation typically completes within 2 seconds.
  const PROPAGATION_BUFFER_MS = 2_000;
  await new Promise((resolve) => setTimeout(resolve, PROPAGATION_BUFFER_MS));

  // Stop accepting new connections and drain existing ones
  await server.closeWithDrain(20_000);

  // Close downstream clients after HTTP is drained
  await closeDependencies(deps);
}
Este patrón combina bien con un hook preStop de Kubernetes para servicios que necesitan más precisión:
lifecycle:
  preStop:
    exec:
      command: ["/bin/sh", "-c", "sleep 5"]
terminationGracePeriodSeconds: 30
El hook preStop se ejecuta antes de enviar SIGTERM, dándole a la propagación de endpoints una ventaja inicial. Tu manejador de SIGTERM entonces comienza a drenar un servidor que ya está tranquilo, en lugar de competir contra tablas de enrutamiento obsoletas.
Verificación de que funciona
El apagado controlado es una de esas cosas que es fácil implementar incorrectamente y difícil de notar hasta que falla en producción. Una prueba de humo mínima durante las pruebas de integración:
# Start service, send some long-running requests, then SIGTERM
curl -X POST http://localhost:3000/slow-endpoint &
CURL_PID=$!

sleep 0.5
kill -TERM $(lsof -ti:3000)  # Send SIGTERM to the server process

wait $CURL_PID
echo "Exit: $?"  # Should be 0 — request completed, not dropped
Si la solicitud devuelve 0, el servidor drenó correctamente. Si devuelve 52 (connection reset) o 7 (connection refused), tu manejador de apagado tiene un hueco.
Para una cobertura más exhaustiva, ejecuta escenarios de apagado en tu suite de pruebas de integración contra un proceso de servidor real usando child_process.spawn y process.kill(pid, "SIGTERM"). Las pruebas unitarias no detectarán los problemas de sincronización que realmente causan solicitudes perdidas.
No llames a process.exit() de forma sincrónica dentro de un manejador de señales sin esperar la secuencia de apagado. Una salida sincrónica deja transacciones de base de datos abiertas, pools de conexiones en un estado desconocido y mensajes de colas sin acuse de recibo.
Conclusiones clave
- Node.js no maneja
SIGTERMpor defecto — registra manejadores explícitos antes deserver.listen()o tu proceso ignorará la señal hastaSIGKILL. server.close()por sí solo no es suficiente — rastrea los sockets activos y destruye las conexiones keep-alive inactivas para evitar que el drenaje se atasque.- Cierra los consumidores de colas antes de cerrar la base de datos — un consumidor a medio procesar un mensaje necesita que el almacenamiento descendiente siga disponible.
- Espera de 2 a 5 segundos antes de iniciar el drenaje — la propagación de endpoints en Kubernetes es asíncrona, y las solicitudes siguen enrutándose a tu pod inmediatamente después de
SIGTERM. - Configura tu tiempo de espera interno 5 segundos por debajo de
terminationGracePeriodSeconds— deja un margen para salir limpiamente antes de que llegueSIGKILL. - Escribe una prueba de integración que envíe
SIGTERMa mitad de una solicitud — es la única forma confiable de verificar que la secuencia de apagado funcione de extremo a extremo.


