Graceful Shutdown in Node.js-Produktionsdiensten
Die meisten Node.js-Dienste verlieren bei jedem Deployment laufende Requests: SIGTERM korrekt behandeln, Verbindungen drainen, sauber beenden.
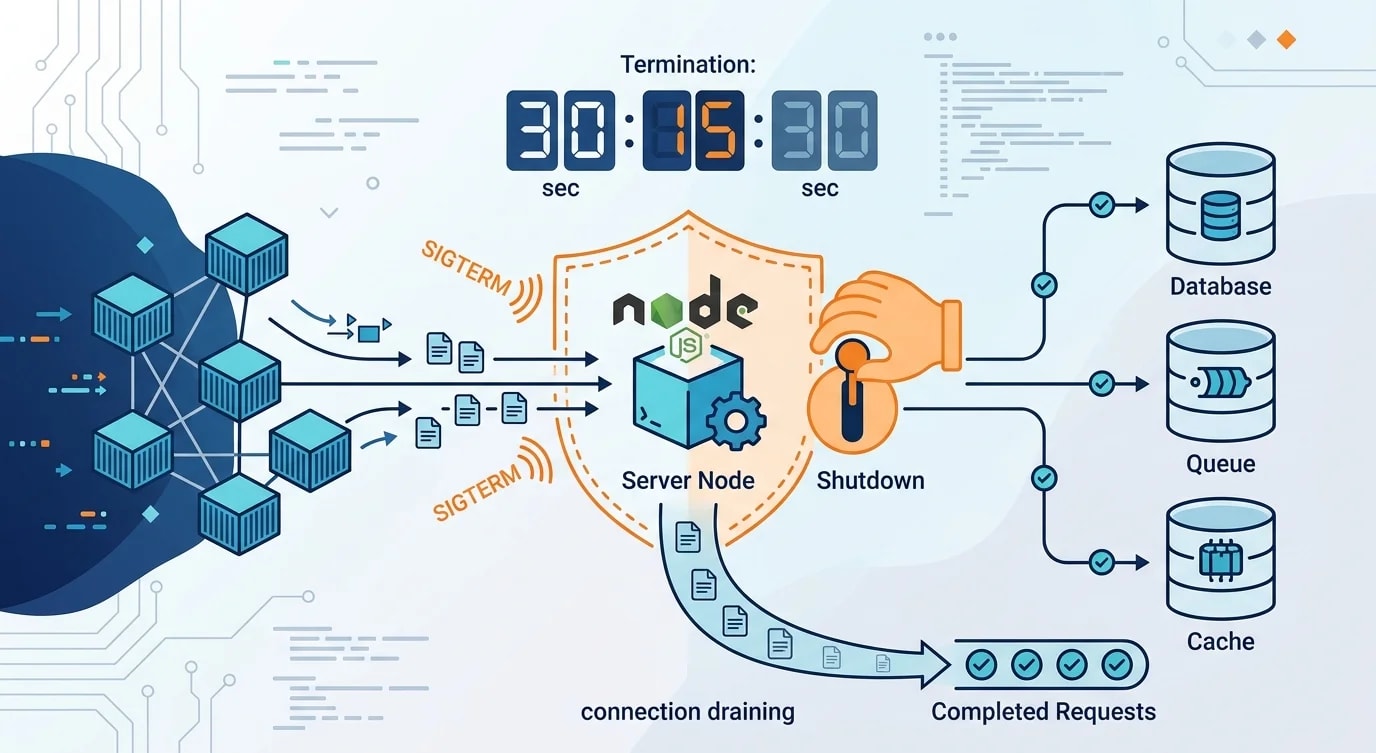
Jedes Mal, wenn du einen Node.js-Dienst ohne ordentlichen Shutdown-Handler deployst, spielst du mit laufenden Requests. Der Prozess erhält SIGTERM, Node.js ignoriert ihn standardmäßig, Kubernetes sendet irgendwann SIGKILL, und jeder Request, der gerade unterwegs ist, bekommt einen Verbindungs-Reset. Das passiert bei jedem Rolling Deployment, bei jeder Pod-Eviction und bei jedem Scale-Down-Event.
Die meisten Teams entdecken das Problem erst durch User-Reports — intermittierende 503er während Deployments in der Hochphase, die sich lokal schwer reproduzieren lassen. Der Fix ist nicht kompliziert, aber er erfordert, dass du genau verstehst, was während der Kubernetes-Terminierungssequenz passiert, und ein paar bewegliche Teile in der richtigen Reihenfolge zusammenführst.
Was passiert ohne Shutdown-Handler
Wenn Kubernetes einen Pod terminiert, sendet es SIGTERM an PID 1. Node.js registriert keinen Standard-Handler für SIGTERM — das Signal wird stillschweigend ignoriert, bis terminationGracePeriodSeconds (Standard: 30 Sekunden) abläuft und SIGKILL eintrifft. Dann killt das OS den Prozess gewaltsam. Kein Cleanup, kein Draining, keine Verhandlung.
// ❌ Common pattern — process dies abruptly on SIGKILL
const app = express();
const server = app.listen(3000);

// No SIGTERM handler. In-flight requests dropped.
// DB connections closed mid-transaction.
// Queue messages unacknowledged.
Das defekte Verhalten ist lokal unsichtbar, weil du manuell mit Strg+C neu startest, was SIGINT sendet und Node.js standardmäßig behandelt. In Produktion sieht die Sache anders aus.
Ein braves Service muss bei SIGTERM vier Dinge erledigen:
- Keine neuen Verbindungen mehr annehmen
- Auf laufende Requests warten
- Downstream-Verbindungen schließen (Datenbank, Cache, Queues)
- Mit Code
0beenden
Signal-Handler registrieren
Signal-Handler müssen früh registriert werden — bevor der Server startet, bevor Verbindungen aufgebaut werden. Wenn der Prozess während des Starts abstürzt, bevor die Handler registriert sind, ist das akzeptabel. Sobald der Server live ist, braucht er einen sauberen Ausstieg.
// ✅ Register before server.listen() — handles both Kubernetes and local dev
function registerShutdownHandlers(shutdown: () => Promise<void>): void {
  let isShuttingDown = false;

  const handler = async (signal: string) => {
    // Guard against duplicate signals — Kubernetes can send SIGTERM more than once
    if (isShuttingDown) return;
    isShuttingDown = true;

    console.log(`[shutdown] Received ${signal}. Starting graceful shutdown...`);

    try {
      await shutdown();
      console.log("[shutdown] Complete. Exiting.");
      process.exit(0);
    } catch (err) {
      console.error("[shutdown] Error during shutdown:", err);
      process.exit(1);
    }
  };

  process.on("SIGTERM", () => handler("SIGTERM")); // Kubernetes, docker stop
  process.on("SIGINT", () => handler("SIGINT"));   // Ctrl+C in development
}
Der isShuttingDown-Guard ist wichtig. Kubernetes sendet SIGTERM manchmal mehrfach, bevor SIGKILL kommt, und Entwickler drücken lokal manchmal mehrmals Strg+C. Zwei parallele Shutdown-Sequenzen laufen zu lassen ist schlimmer als eine.
Laufende HTTP-Requests drainen
server.close() verhindert, dass der Server neue TCP-Verbindungen annimmt, hat aber eine bekannte Einschränkung: bestehende Keep-Alive-Verbindungen werden nicht geschlossen. Ein Client mit einer offenen Keep-Alive-Verbindung hält einen Socket unbegrenzt offen — das bedeutet, server.close() kann sich über die gesamte Grace-Periode hinweg aufhängen, bevor Kubernetes SIGKILL sendet.
Der Fix: aktive Verbindungen verfolgen und inaktive nach einem Timeout hart schließen:
import { Server, IncomingMessage, ServerResponse } from "http";

function createDrainableServer(server: Server): {
  closeWithDrain: (timeoutMs?: number) => Promise<void>;
} {
  const connections = new Set<import("net").Socket>();

  server.on("connection", (socket) => {
    connections.add(socket);
    socket.on("close", () => connections.delete(socket));
  });

  const closeWithDrain = (timeoutMs = 10_000): Promise<void> => {
    return new Promise((resolve, reject) => {
      server.close((err) => {
        if (err) reject(err);
        else resolve();
      });

      // Destroy idle keep-alive connections immediately
      for (const socket of connections) {
        socket.destroy();
      }

      setTimeout(() => {
        reject(new Error(`Server drain timed out after ${timeoutMs}ms`));
      }, timeoutMs).unref();
    });
  };

  return { closeWithDrain };
}
Für Services mit hoher Keep-Alive-Auslastung macht das viel aus. Inaktive Sockets sofort zu zerstören, lässt das Drain-Fenster auf tatsächlich laufende Requests fokussieren, statt darauf zu warten, dass Clients bemerken, dass die Verbindung tot ist.
Setze dein internes Drain-Timeout 5 Sekunden unter terminationGracePeriodSeconds. Wenn Kubernetes dir 30 Sekunden gibt, ziele darauf ab, innerhalb von 25 zu beenden — als Puffer für das Shutdown-Bookkeeping.
Downstream-Abhängigkeiten in der richtigen Reihenfolge schließen
Datenbank-Pools, Queue-Consumer und Cache-Clients brauchen einen expliziten Teardown. Die Reihenfolge ist nicht beliebig — wenn du sie falsch machst, entstehen Datenkorruption oder doppelte Nachrichtenverarbeitung.
interface ServiceDependencies {
  db: import("pg").Pool;
  cache: import("redis").RedisClientType;
  consumer: import("kafkajs").Consumer;
}

async function closeDependencies(deps: ServiceDependencies): Promise<void> {
  // 1. Stop consuming new messages before anything else.
  //    An in-flight message may need the DB — don't close it first.
  await deps.consumer.stop();
  await deps.consumer.disconnect();

  // 2. Flush and close cache client
  await deps.cache.quit();

  // 3. Close database pool last — lets any final writes from the consumer land
  await deps.db.end();
}
Der häufige Fehler ist, die Datenbank zuerst zu schließen. Wenn ein Queue-Consumer gerade eine Nachricht verarbeitet, die einen Datenbank-Write braucht, und du den Pool darunter wegziehst, bleibt die Nachricht unbestätigt. Der Message-Broker wird sie erneut zustellen, und du hast ein Duplikat-Szenario eingeführt, das deine Idempotenz-Logik vielleicht — oder auch nicht — abfängt.
Das Kubernetes-Endpoint-Propagation-Race
Es gibt einen subtilen Race Condition in Kubernetes, den sogar Teams mit ordentlichen Shutdown-Handlern übersehen. Wenn ein Pod terminiert werden soll, passieren zwei Dinge parallel:
SIGTERMwird an den Pod gesendet- Die Pod-IP wird aus dem
Endpoints-Objekt entfernt
Das Problem: Endpoint-Propagation ist eventually consistent. kube-proxy und dein Ingress-Controller aktualisieren ihre Routing-Tabellen asynchron. Für 200–500 Millisekunden nach dem Senden von SIGTERM kann der Load Balancer neue Requests noch an den terminierenden Pod weiterleiten. Wenn du sofort bei SIGTERM aufhörst, Verbindungen anzunehmen, schlagen diese mit Connection refused fehl.
Der Fix ist billig: kurz schlafen, bevor das eigentliche Draining startet.
async function gracefulShutdown(
  server: ReturnType<typeof createDrainableServer>,
  deps: ServiceDependencies,
): Promise<void> {
  // Allow time for load balancer to drain traffic from this pod.
  // Endpoint propagation typically completes within 2 seconds.
  const PROPAGATION_BUFFER_MS = 2_000;
  await new Promise((resolve) => setTimeout(resolve, PROPAGATION_BUFFER_MS));

  // Stop accepting new connections and drain existing ones
  await server.closeWithDrain(20_000);

  // Close downstream clients after HTTP is drained
  await closeDependencies(deps);
}
Dieses Pattern passt gut zu einem Kubernetes preStop-Hook für Services, die mehr Präzision brauchen:
lifecycle:
  preStop:
    exec:
      command: ["/bin/sh", "-c", "sleep 5"]
terminationGracePeriodSeconds: 30
Der preStop-Hook wird ausgeführt, bevor SIGTERM gesendet wird, und gibt der Endpoint-Propagation einen Vorsprung. Dein SIGTERM-Handler drained dann einen bereits ruhigen Server, anstatt gegen veraltete Routing-Tabellen anzurennen.
Verifizieren, dass es funktioniert
Graceful Shutdown ist eine dieser Dinge, die man leicht falsch implementiert und die man erst bemerkt, wenn sie in Produktion brechen. Ein minimaler Smoke-Test während der Integrationstests:
# Start service, send some long-running requests, then SIGTERM
curl -X POST http://localhost:3000/slow-endpoint &
CURL_PID=$!

sleep 0.5
kill -TERM $(lsof -ti:3000)  # Send SIGTERM to the server process

wait $CURL_PID
echo "Exit: $?"  # Should be 0 — request completed, not dropped
Wenn der Request 0 zurückgibt, hat der Server sauber gedrained. Wenn er 52 (connection reset) oder 7 (connection refused) zurückgibt, hat dein Shutdown-Handler eine Lücke.
Für gründlichere Abdeckung solltest du Shutdown-Szenarien in deiner Integrationstest-Suite gegen einen echten Server-Prozess mit child_process.spawn und process.kill(pid, "SIGTERM") laufen lassen. Unit-Tests fangen die Timing-Probleme nicht ab, die tatsächlich zu abgebrochenen Requests führen.
Rufe process.exit() nicht synchron innerhalb eines Signal-Handlers auf, ohne die Shutdown-Sequenz abzuwarten. Ein synchroner Exit lässt Datenbank-Transaktionen offen, Connection-Pools in einem unbekannten Zustand und Queue-Nachrichten unbestätigt.
Wichtige Erkenntnisse
- Node.js behandelt
SIGTERMstandardmäßig nicht — registriere explizite Handler vorserver.listen(), sonst ignoriert dein Prozess das Signal bisSIGKILLeintrifft. server.close()allein reicht nicht — verfolge aktive Sockets und zerstöre inaktive Keep-Alive-Verbindungen, damit das Draining nicht steckenbleibt.- Schließe Queue-Consumer, bevor du die Datenbank schließt — ein Consumer, der gerade eine Nachricht verarbeitet, braucht den nachgelagerten Speicher noch verfügbar.
- Warte 2–5 Sekunden, bevor du das Draining startest — die Kubernetes-Endpoint-Propagation ist asynchron, und Requests werden direkt nach
SIGTERMnoch an deinen Pod geroutet. - Setze dein internes Timeout 5 Sekunden unter
terminationGracePeriodSeconds— lasse einen Puffer, damit du sauber beendest, bevorSIGKILLkommt. - Schreibe einen Integrationstest, der mitten im Request
SIGTERMsendet — das ist der einzige zuverlässige Weg, um die Shutdown-Sequenz wirklich End-to-End zu verifizieren.


