Backend
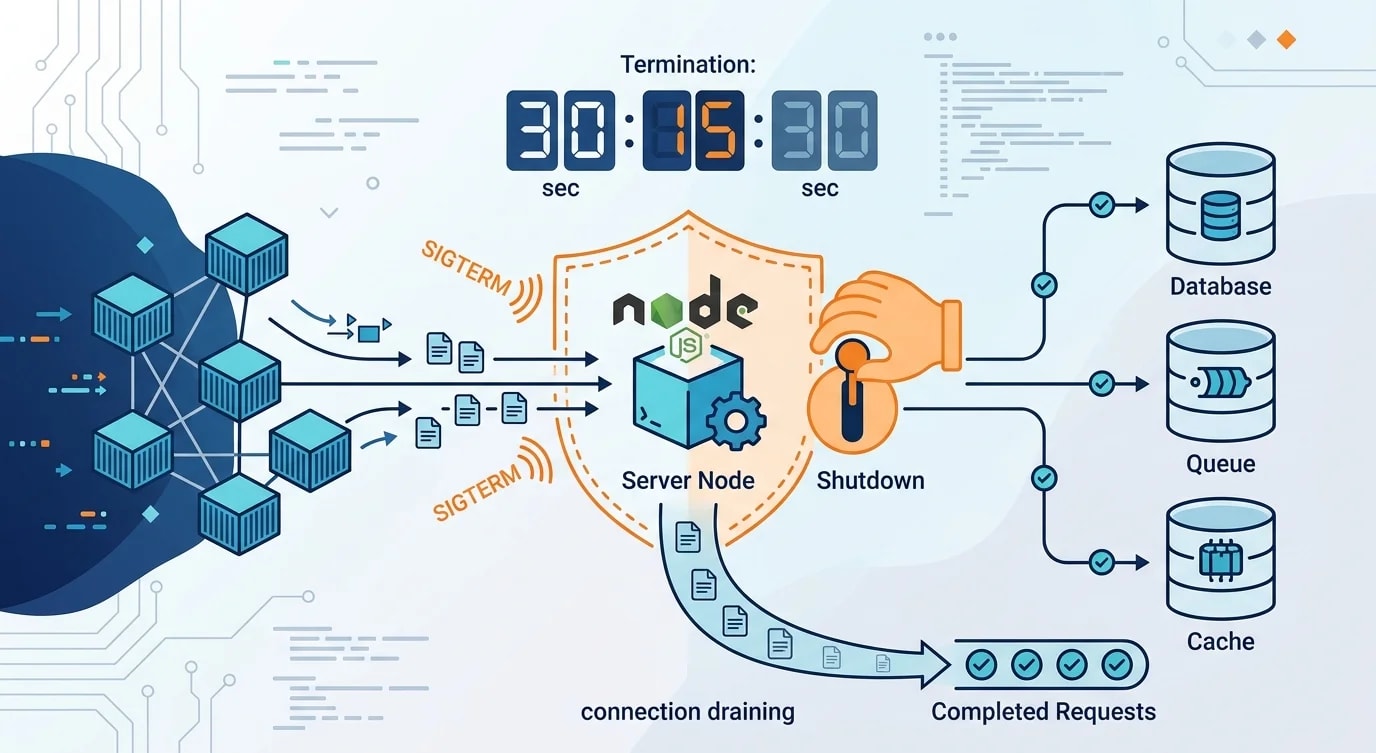
Graceful Shutdown in Node.js-Produktionsdiensten
Die meisten Node.js-Dienste verlieren bei jedem Deployment laufende Requests: SIGTERM korrekt behandeln, Verbindungen drainen, sauber beenden.
·5 Min. Lesezeit
Tags
13 Artikel · Seite 1 von 2
Die meisten Node.js-Dienste verlieren bei jedem Deployment laufende Requests: SIGTERM korrekt behandeln, Verbindungen drainen, sauber beenden.

Ein bewährtes Framework zur schnellen Diagnose und Behebung von Produktionsvorfällen — vom ersten Alert bis zur Root-Cause-Analyse und Prävention.

Structured Logging in Node.js: maschinenlesbare, durchsuchbare Einträge mit Korrelations-IDs, einheitlichen Schweregraden und Kontextweitergabe.
Chaos Engineering in der Praxis: kontrollierte Fehler in Produktionssystemen aufdecken Schwachstellen — Netzwerkpartitionen, Ressourcen, Abhängigkeiten.
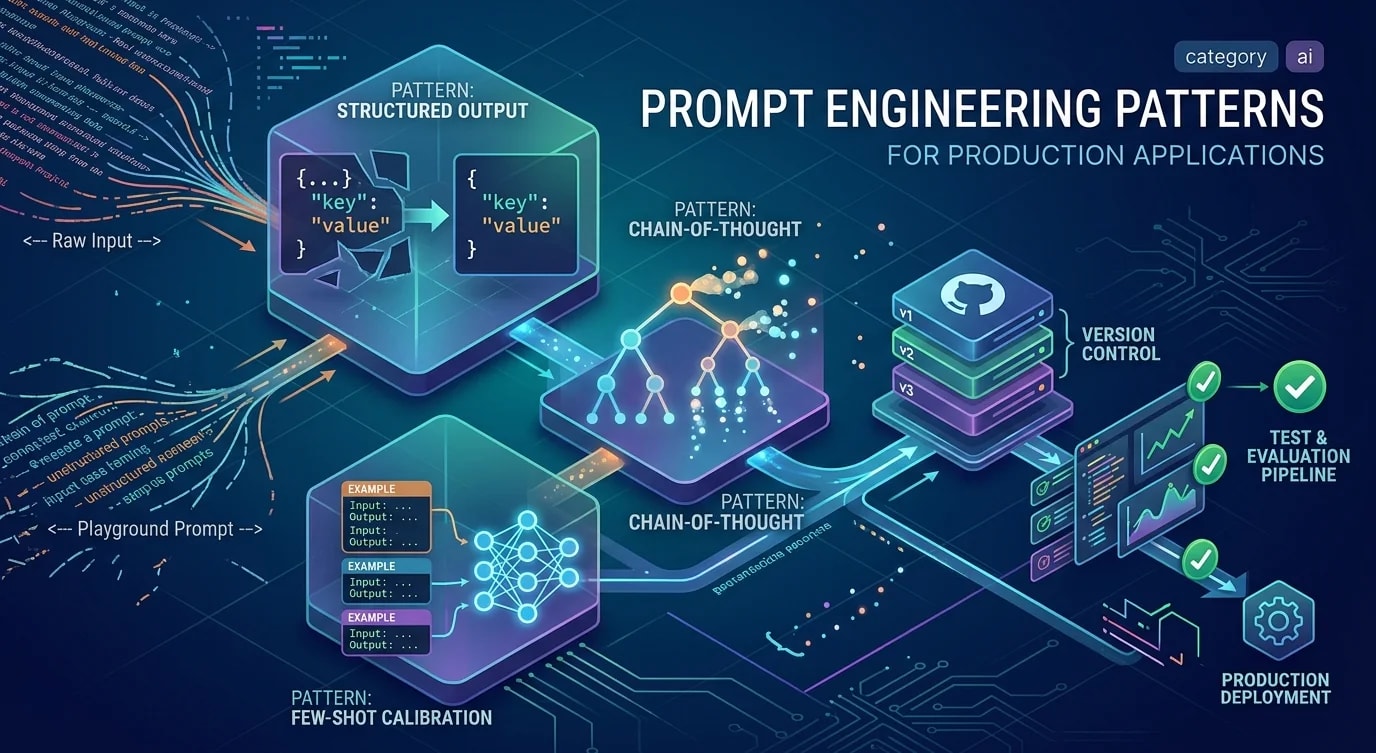
Systematische Prompt-Patterns für produktive LLM-Anwendungen: strukturierte Ausgaben, Chain-of-Thought, Few-Shot-Kalibrierung, Versionierung, Evals.

Praktische Techniken zur Härtung von Docker-Containern: Image-Scans, Least Privilege, Secrets-Management, Netzwerkrichtlinien und Laufzeit-Monitoring.

Wie man produktionsreife NLP-Pipelines baut: Textvorverarbeitung, Tokenisierung, Embeddings, Klassifikation und Entitätsextraktion.

Wie strukturiertes Logging die Fehlersuche beschleunigt: JSON-Formate, Kontextweitergabe, Log-Level, Maskierung sensibler Daten und Aggregation.

So konfigurierst und überwachst du Datenbank-Connection-Pools: Dimensionierung, Leak-Erkennung, Failover-Handling und typische Fehlkonfigurationen.

Techniken zur Diagnose von Memory Leaks, übermäßiger Allokation und OOM-Kills in Produktion — mit Heap Snapshots, Profiling-Tools und gängigen Leak-Patterns.

Chaos Engineering ist die Praxis, absichtlich Fehler in Produktionssysteme zu injizieren, um Schwachstellen zu entdecken, bevor sie echte Ausfälle verursachen.
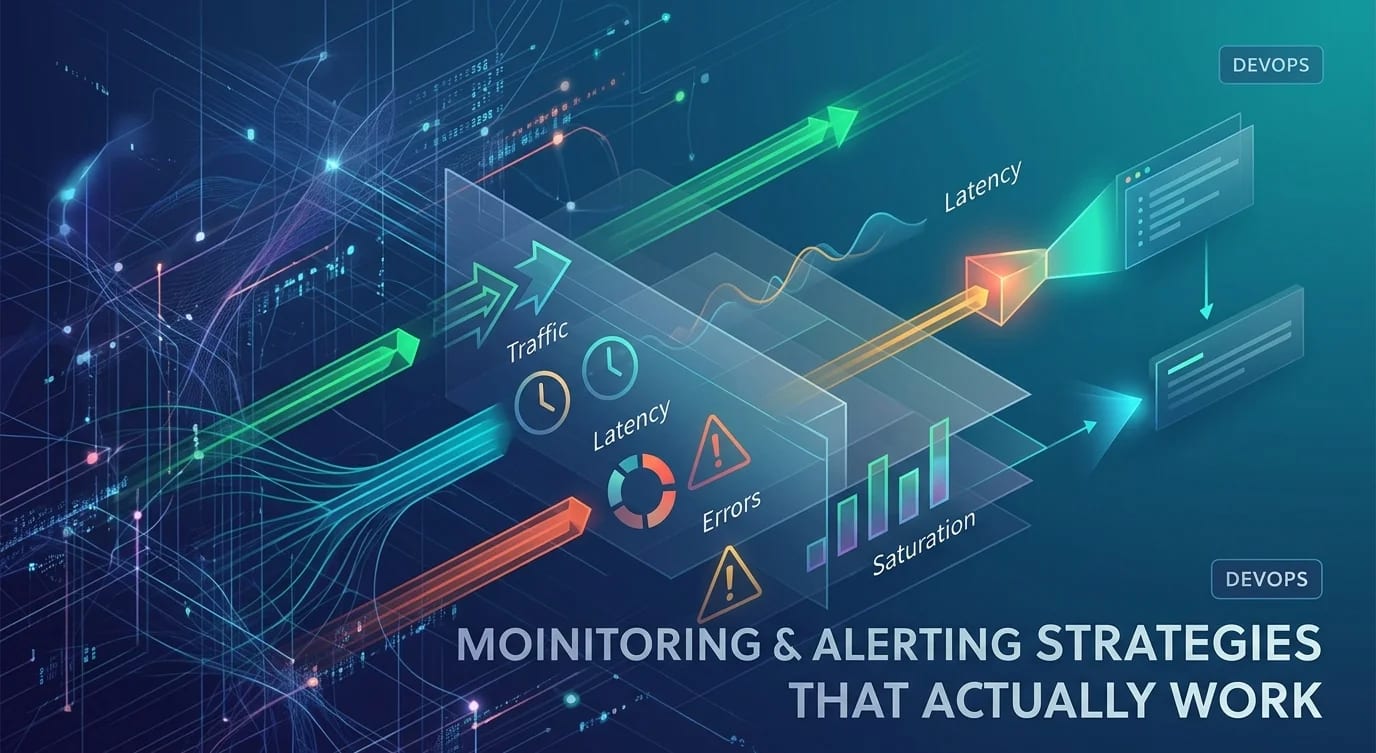
Alarmmüdigkeit sabotiert die Incident-Reaktion — baue deine Monitoring-Strategie auf SLIs, sinnvollen Schwellenwerten und umsetzbaren Alarmen auf.