Prompt-Engineering-Patterns für Produktionsanwendungen
Systematische Prompt-Patterns für produktive LLM-Anwendungen: strukturierte Ausgaben, Chain-of-Thought, Few-Shot-Kalibrierung, Versionierung, Evals.
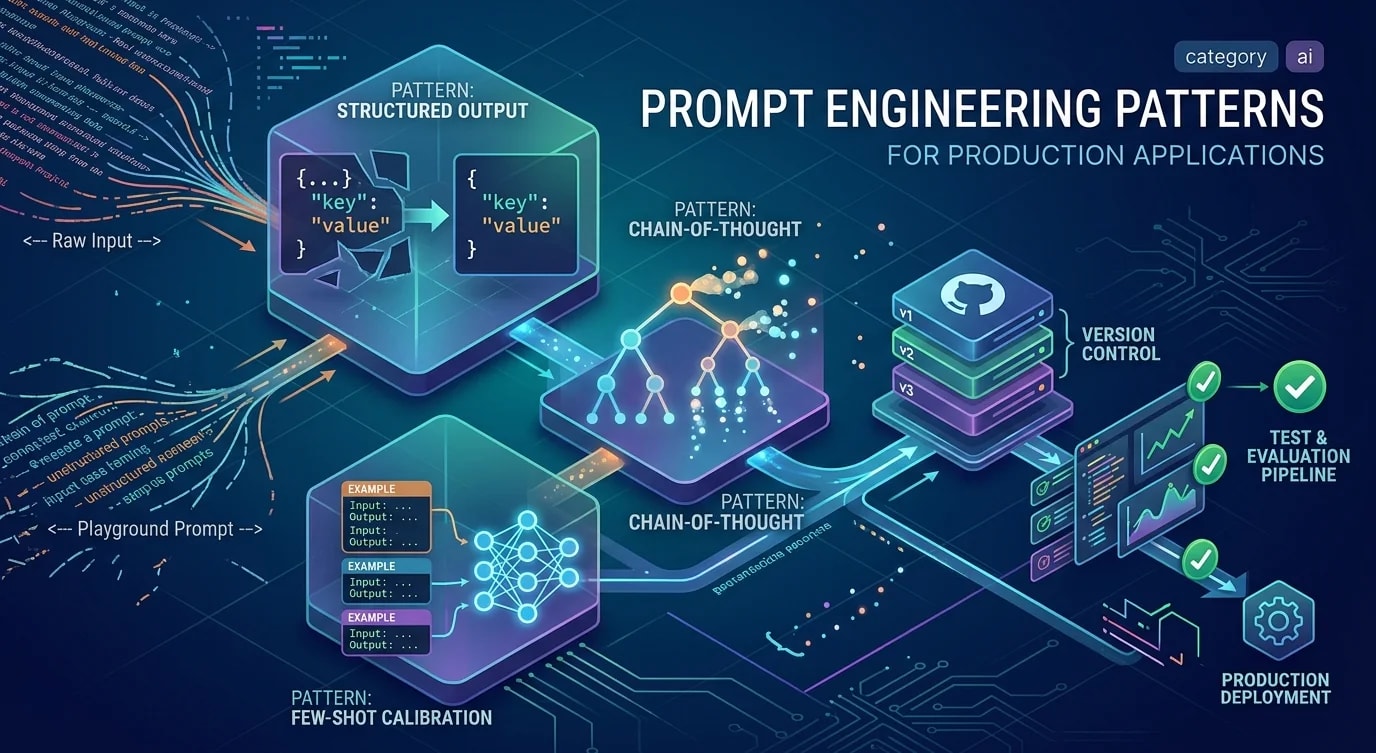
Prompt-Engineering in Produktivsystemen hat nichts mit dem gelegentlichen Chatten mit einer KI zu tun. Gefragt sind deterministische Ausgabeformate, konsistentes Verhalten in Grenzfällen, Versionskontrolle für Prompts und Evaluierungs-Pipelines, die Regressionen erkennen, bevor es die Nutzer tun. Der Unterschied zwischen einem Prompt, der in einer Spielwiese funktioniert, und einem, der im großen Maßstab zuverlässig ist, entspricht dem Unterschied zwischen einem Skript und einem produktionsreifen Dienst.
Diese Patterns behandeln Prompts wie Code: versioniert, getestet, evaluiert und mit derselben Sorgfalt gepflegt wie jede andere Systemkomponente.
Extraktion strukturierter Ausgaben
Das gängigste Pattern in Produktivsystemen: unstrukturierte Eingaben rein, strukturierte Ausgaben raus. Der Prompt muss das Modell so einschränken, dass es parsebare Ergebnisse liefert.
// ❌ Hoping the model returns JSON
const prompt = `Extract the product info from this review:
"The new Sony WH-1000XM5 headphones are amazing at $349"

Return as JSON.`;
// Sometimes returns JSON, sometimes markdown, sometimes prose// ✅ Constrained structured output extraction
interface ProductExtraction {
name: string;
brand: string;
price: number | null;
currency: string;
sentiment: "positive" | "negative" | "neutral";
confidence: number;
}
function buildExtractionPrompt(
review: string
): string {
return `Extract product information from the customer review below.
RULES:
- Return ONLY a JSON object, no other text
- Use null for fields that cannot be determined
- Sentiment must be exactly one of: "positive", "negative", "neutral"
- Confidence is a number between 0 and 1
- Price should be a number without currency symbols
OUTPUT SCHEMA:
{
"name": "string - product name",
"brand": "string - manufacturer/brand",
"price": "number | null - price in local currency",
"currency": "string - ISO 4217 currency code",
"sentiment": "positive | negative | neutral",
"confidence": "number between 0 and 1"
}
REVIEW:
"""
${review}
"""
JSON:`;
}
// Parse and validate the response
function parseExtraction(
raw: string
): ProductExtraction | null {
try {
// Strip markdown code fences if present
const cleaned = raw
.replace(/```json\n?/g, "")
.replace(/```\n?/g, "")
.trim();
const parsed = JSON.parse(cleaned);
// Validate required fields
if (typeof parsed.name !== "string") return null;
if (typeof parsed.brand !== "string") return null;
if (
!["positive", "negative", "neutral"].includes(
parsed.sentiment
)
)
return null;
return parsed as ProductExtraction;
} catch {
return null;
}
}Few-Shot-Kalibrierung
Few-Shot-Beispiele kalibrieren das Verhalten des Modells zuverlässiger als Anweisungen allein. Die Beispiele zeigen Grenzfälle auf und setzen Erwartungen an Format und Qualität der Ausgabe.
interface FewShotExample {
  input: string;
  output: string;
  annotation?: string; // Why this example matters
}

function buildClassificationPrompt(
  text: string,
  examples: FewShotExample[]
): string {
  const exampleSection = examples
    .map(
      (ex) =>
        `Input: "${ex.input}"\nCategory: ${ex.output}`
    )
    .join("\n\n");

  return `Classify the support ticket into exactly one category.

Categories: billing, technical, account, shipping, other

${exampleSection}

Input: "${text}"
Category:`;
}

// Curated examples covering edge cases
const classificationExamples: FewShotExample[] = [
  {
    input: "I was charged twice for my subscription",
    output: "billing",
    annotation: "Clear billing issue",
  },
  {
    input: "The app crashes when I try to upload a photo",
    output: "technical",
    annotation: "Technical bug report",
  },
  {
    input:
      "I can't log in and I was also charged wrong",
    output: "account",
    annotation:
      "Multi-issue: primary is account access, " +
      "secondary is billing",
  },
  {
    input: "When will my order arrive?",
    output: "shipping",
    annotation: "Shipping inquiry",
  },
  {
    input:
      "Your company is terrible and I want a refund " +
      "on the broken thing you shipped",
    output: "billing",
    annotation:
      "Emotional message — classify by actionable intent " +
      "(refund = billing), not tone",
  },
];
Das letzte Beispiel ist entscheidend: Es bringt dem Modell bei, emotional aufgeladene Eingaben zu verarbeiten, indem es sich auf die umsetzbare Absicht statt auf den oberflächlichen Tonfall konzentriert. Solche Grenzfall-Beispiele verhindern genau die Fehlklassifizierungen mit der größten Auswirkung.
Chain-of-Thought für komplexe Schlussfolgerungen
Wenn das Modell mehrstufiges Schlussfolgern durchführen muss, verbessert Chain-of-Thought-Prompting die Genauigkeit, indem es die Zwischenschritte explizit macht.
// ❌ Direct answer — model skips reasoning, makes errors
const directPrompt = `
Is this refund request eligible?
Customer purchased 45 days ago, item is opened,
total was $89. Our policy allows refunds within 30 days
for unopened items and 60 days for defective items.
Answer yes or no.`;

// ✅ Chain-of-thought — explicit reasoning steps
function buildRefundEligibilityPrompt(
  request: RefundRequest
): string {
  return `Determine if this refund request is eligible based on our policy.

POLICY:
1. Unopened items: full refund within 30 days of purchase
2. Opened items: exchange only within 14 days
3. Defective items: full refund within 60 days with proof
4. Digital items: no refunds after download
5. Orders over $500: manager approval required regardless

REQUEST DETAILS:
- Purchase date: ${request.purchaseDate}
- Days since purchase: ${request.daysSincePurchase}
- Item condition: ${request.condition}
- Item type: ${request.type}
- Order total: $${request.total}
- Reason: ${request.reason}

Think through each policy rule step by step, then provide your decision.

REASONING:
Step 1 - Check item type:
Step 2 - Check time window for condition:
Step 3 - Check special conditions:
Step 4 - Final decision:

DECISION: [eligible | not_eligible | needs_review]
REASON: [one sentence explanation]`;
}

interface RefundRequest {
  purchaseDate: string;
  daysSincePurchase: number;
  condition: "unopened" | "opened" | "defective";
  type: "physical" | "digital";
  total: number;
  reason: string;
}
Prompt-Versionierung und -Verwaltung
Prompts in Produktivsystemen brauchen Versionierung, A/B-Testing-Fähigkeit und Rollback-Unterstützung – genau wie Anwendungscode.
interface PromptVersion {
  id: string;
  name: string;
  version: string;
  template: string;
  variables: string[];
  model: string;
  temperature: number;
  maxTokens: number;
  createdAt: Date;
  evaluationScore: number | null;
}

class PromptRegistry {
  private versions: Map<string, PromptVersion[]> =
    new Map();
  private active: Map<string, string> = new Map();

  register(prompt: PromptVersion): void {
    const versions =
      this.versions.get(prompt.name) ?? [];
    versions.push(prompt);
    this.versions.set(prompt.name, versions);
  }

  setActive(name: string, version: string): void {
    const versions = this.versions.get(name);
    if (
      !versions?.some((v) => v.version === version)
    ) {
      throw new Error(
        `Version ${version} not found for ${name}`
      );
    }
    this.active.set(name, version);
  }

  getActive(name: string): PromptVersion {
    const version = this.active.get(name);
    if (!version) {
      throw new Error(`No active version for ${name}`);
    }
    const versions = this.versions.get(name) ?? [];
    return versions.find(
      (v) => v.version === version
    )!;
  }

  render(
    name: string,
    variables: Record<string, string>
  ): string {
    const prompt = this.getActive(name);
    let rendered = prompt.template;

    for (const [key, value] of Object.entries(variables)) {
      rendered = rendered.replaceAll(`{{${key}}}`, value);
    }

    return rendered;
  }
}

// Usage
const registry = new PromptRegistry();

registry.register({
  id: "extract-v1",
  name: "product-extraction",
  version: "1.0.0",
  template: buildExtractionPrompt("{{review}}"),
  variables: ["review"],
  model: "gpt-4",
  temperature: 0,
  maxTokens: 500,
  createdAt: new Date("2024-01-15"),
  evaluationScore: 0.92,
});

registry.setActive("product-extraction", "1.0.0");
Automatisierte Evaluierungs-Pipeline
Prompts brauchen Regressionstests. Wenn ein Prompt geändert wird, muss klar sein, ob er sich über das gesamte Evaluierungsset hinweg verbessert oder verschlechtert hat.
interface EvalCase {
  input: string;
  expectedOutput: Record<string, unknown>;
  tags: string[]; // Edge cases, normal, adversarial
}

interface EvalResult {
  promptVersion: string;
  totalCases: number;
  passed: number;
  failed: number;
  accuracy: number;
  latencyP50: number;
  latencyP95: number;
  failures: Array<{
    input: string;
    expected: unknown;
    actual: unknown;
    reason: string;
  }>;
}

async function evaluatePrompt(
  registry: PromptRegistry,
  promptName: string,
  evalSet: EvalCase[],
  llmClient: LLMClient
): Promise<EvalResult> {
  const prompt = registry.getActive(promptName);
  const failures: EvalResult["failures"] = [];
  const latencies: number[] = [];

  for (const evalCase of evalSet) {
    const rendered = registry.render(promptName, {
      review: evalCase.input,
    });

    const start = performance.now();
    const response = await llmClient.complete({
      prompt: rendered,
      model: prompt.model,
      temperature: prompt.temperature,
      maxTokens: prompt.maxTokens,
    });
    latencies.push(performance.now() - start);

    const parsed = parseExtraction(response);

    if (!parsed) {
      failures.push({
        input: evalCase.input,
        expected: evalCase.expectedOutput,
        actual: response,
        reason: "Failed to parse output",
      });
      continue;
    }

    // Field-level comparison
    for (const [key, expected] of Object.entries(
      evalCase.expectedOutput
    )) {
      if (
        parsed[key as keyof ProductExtraction] !== expected
      ) {
        failures.push({
          input: evalCase.input,
          expected: { [key]: expected },
          actual: {
            [key]: parsed[key as keyof ProductExtraction],
          },
          reason: `Field ${key} mismatch`,
        });
      }
    }
  }

  const sorted = [...latencies].sort((a, b) => a - b);

  return {
    promptVersion: prompt.version,
    totalCases: evalSet.length,
    passed: evalSet.length - failures.length,
    failed: failures.length,
    accuracy:
      (evalSet.length - failures.length) / evalSet.length,
    latencyP50: sorted[Math.floor(sorted.length * 0.5)] ?? 0,
    latencyP95: sorted[Math.floor(sorted.length * 0.95)] ?? 0,
    failures,
  };
}
Wichtigste Erkenntnisse
Prompts für strukturierte Ausgaben brauchen explizite Schemadefinitionen, Einschränkungen des Ausgabeformats und eine Validierung nach der Antwort mit Fallback-Parsing für Markdown-Codeblöcke, die Modelle trotz Anweisung manchmal trotzdem einfügen. Few-Shot-Beispiele kalibrieren das Modellverhalten zuverlässiger als Anweisungen allein – dabei sollten Beispiele ausgewählt werden, die Grenzfälle wie Eingaben mit mehreren Absichten und emotional aufgeladene Texte abdecken, nicht nur Idealszenarien. Chain-of-Thought-Prompting mit expliziten Denkschritten verbessert die Genauigkeit bei mehrstufigen Entscheidungen, indem es das Modell zwingt, jede Bedingung zu prüfen, bevor es zu einer Schlussfolgerung kommt. Prompt-Versionierung nach dem Registry-Pattern ermöglicht A/B-Tests, Rollbacks und Audit-Trails – Prompts sollten als versionierte Artefakte mit zugehörigen Modellparametern behandelt werden, nicht als inline eingebettete Zeichenketten. Automatisierte Evaluierungs-Pipelines mit getaggten Testfällen (normal, Grenzfall, adversarial) erkennen Regressionen, wenn sich Prompts ändern, indem sie sowohl Genauigkeit als auch Latenz messen, um die Zuverlässigkeit in Produktivsystemen sicherzustellen.