Patrones de Ingeniería de Prompts para Aplicaciones en Producción
Patrones sistemáticos de prompts para aplicaciones LLM en producción: salida estructurada, cadena de pensamiento, few-shot, versionado y evaluación.
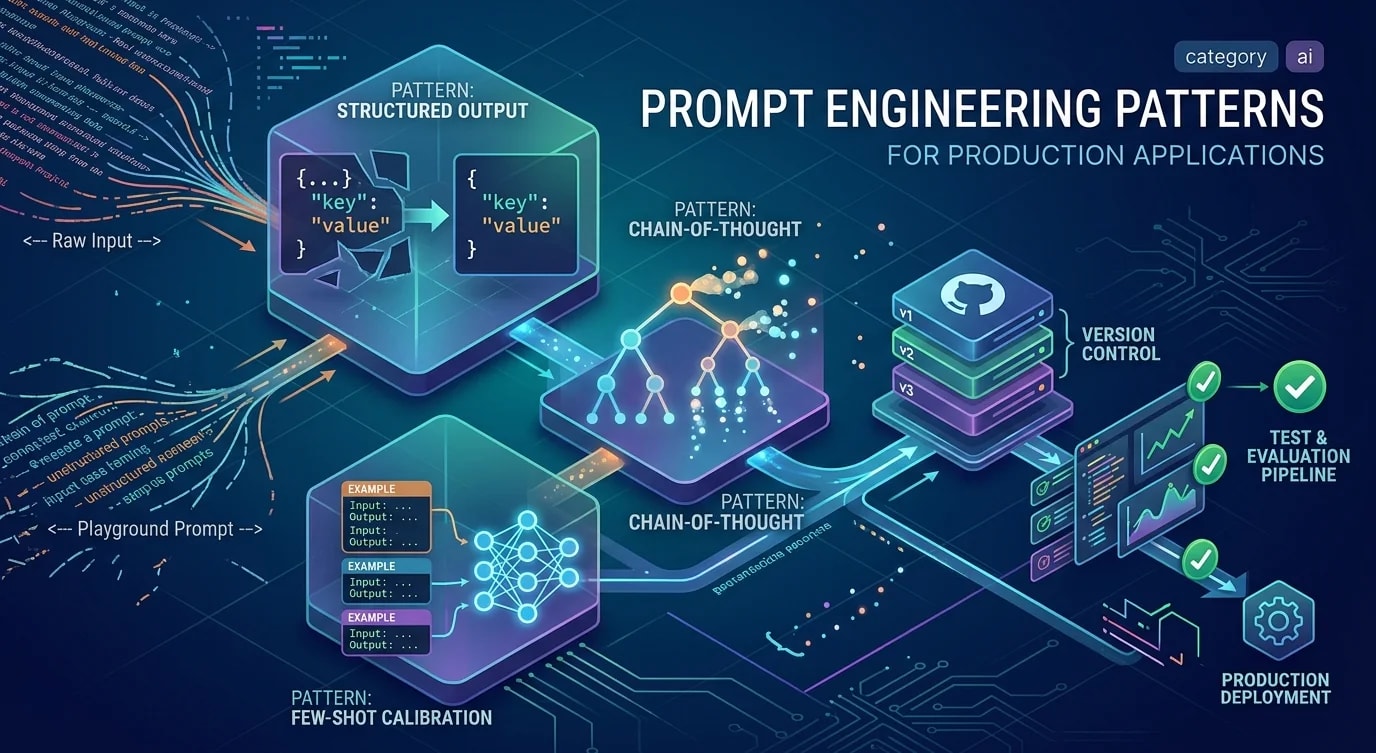
La ingeniería de prompts en producción no tiene nada que ver con simplemente charlar con una IA. Se necesitan formatos de salida deterministas, un comportamiento consistente ante casos límite, control de versiones para los prompts y pipelines de evaluación que detecten regresiones antes de que lo hagan los usuarios. La distancia entre un prompt que funciona en un entorno de pruebas y uno que es fiable a gran escala es la misma que separa un script de un servicio en producción.
Estos patrones tratan los prompts como código: versionados, probados, evaluados y mantenidos con el mismo rigor que cualquier otro componente del sistema.
Extracción de salida estructurada
El patrón más común en producción: se envía una entrada no estructurada y se obtiene una salida estructurada. El prompt debe restringir al modelo para que produzca resultados que se puedan parsear.
// ❌ Hoping the model returns JSON
const prompt = `Extract the product info from this review:
"The new Sony WH-1000XM5 headphones are amazing at $349"

Return as JSON.`;
// Sometimes returns JSON, sometimes markdown, sometimes prose// ✅ Constrained structured output extraction
interface ProductExtraction {
name: string;
brand: string;
price: number | null;
currency: string;
sentiment: "positive" | "negative" | "neutral";
confidence: number;
}
function buildExtractionPrompt(
review: string
): string {
return `Extract product information from the customer review below.
RULES:
- Return ONLY a JSON object, no other text
- Use null for fields that cannot be determined
- Sentiment must be exactly one of: "positive", "negative", "neutral"
- Confidence is a number between 0 and 1
- Price should be a number without currency symbols
OUTPUT SCHEMA:
{
"name": "string - product name",
"brand": "string - manufacturer/brand",
"price": "number | null - price in local currency",
"currency": "string - ISO 4217 currency code",
"sentiment": "positive | negative | neutral",
"confidence": "number between 0 and 1"
}
REVIEW:
"""
${review}
"""
JSON:`;
}
// Parse and validate the response
function parseExtraction(
raw: string
): ProductExtraction | null {
try {
// Strip markdown code fences if present
const cleaned = raw
.replace(/```json\n?/g, "")
.replace(/```\n?/g, "")
.trim();
const parsed = JSON.parse(cleaned);
// Validate required fields
if (typeof parsed.name !== "string") return null;
if (typeof parsed.brand !== "string") return null;
if (
!["positive", "negative", "neutral"].includes(
parsed.sentiment
)
)
return null;
return parsed as ProductExtraction;
} catch {
return null;
}
}Calibración few-shot
Los ejemplos few-shot calibran el comportamiento del modelo de forma más fiable que las instrucciones por sí solas. Los ejemplos muestran casos límite y establecen expectativas sobre el formato y la calidad de la salida.
interface FewShotExample {
  input: string;
  output: string;
  annotation?: string; // Why this example matters
}

function buildClassificationPrompt(
  text: string,
  examples: FewShotExample[]
): string {
  const exampleSection = examples
    .map(
      (ex) =>
        `Input: "${ex.input}"\nCategory: ${ex.output}`
    )
    .join("\n\n");

  return `Classify the support ticket into exactly one category.

Categories: billing, technical, account, shipping, other

${exampleSection}

Input: "${text}"
Category:`;
}

// Curated examples covering edge cases
const classificationExamples: FewShotExample[] = [
  {
    input: "I was charged twice for my subscription",
    output: "billing",
    annotation: "Clear billing issue",
  },
  {
    input: "The app crashes when I try to upload a photo",
    output: "technical",
    annotation: "Technical bug report",
  },
  {
    input:
      "I can't log in and I was also charged wrong",
    output: "account",
    annotation:
      "Multi-issue: primary is account access, " +
      "secondary is billing",
  },
  {
    input: "When will my order arrive?",
    output: "shipping",
    annotation: "Shipping inquiry",
  },
  {
    input:
      "Your company is terrible and I want a refund " +
      "on the broken thing you shipped",
    output: "billing",
    annotation:
      "Emotional message — classify by actionable intent " +
      "(refund = billing), not tone",
  },
];
El último ejemplo es fundamental: le enseña al modelo a manejar entradas cargadas emocionalmente centrándose en la intención accionable en lugar del tono superficial. Este tipo de ejemplos de casos límite evita las clasificaciones erróneas de mayor impacto.
Cadena de pensamiento para razonamiento complejo
Cuando el modelo necesita realizar un razonamiento de varios pasos, el prompting por cadena de pensamiento mejora la precisión al hacer explícitos los pasos intermedios.
// ❌ Direct answer — model skips reasoning, makes errors
const directPrompt = `
Is this refund request eligible?
Customer purchased 45 days ago, item is opened,
total was $89. Our policy allows refunds within 30 days
for unopened items and 60 days for defective items.
Answer yes or no.`;

// ✅ Chain-of-thought — explicit reasoning steps
function buildRefundEligibilityPrompt(
  request: RefundRequest
): string {
  return `Determine if this refund request is eligible based on our policy.

POLICY:
1. Unopened items: full refund within 30 days of purchase
2. Opened items: exchange only within 14 days
3. Defective items: full refund within 60 days with proof
4. Digital items: no refunds after download
5. Orders over $500: manager approval required regardless

REQUEST DETAILS:
- Purchase date: ${request.purchaseDate}
- Days since purchase: ${request.daysSincePurchase}
- Item condition: ${request.condition}
- Item type: ${request.type}
- Order total: $${request.total}
- Reason: ${request.reason}

Think through each policy rule step by step, then provide your decision.

REASONING:
Step 1 - Check item type:
Step 2 - Check time window for condition:
Step 3 - Check special conditions:
Step 4 - Final decision:

DECISION: [eligible | not_eligible | needs_review]
REASON: [one sentence explanation]`;
}

interface RefundRequest {
  purchaseDate: string;
  daysSincePurchase: number;
  condition: "unopened" | "opened" | "defective";
  type: "physical" | "digital";
  total: number;
  reason: string;
}
Versionado y gestión de prompts
Los prompts en producción necesitan versionado, capacidad de pruebas A/B y soporte para revertir cambios, igual que el código de la aplicación.
interface PromptVersion {
  id: string;
  name: string;
  version: string;
  template: string;
  variables: string[];
  model: string;
  temperature: number;
  maxTokens: number;
  createdAt: Date;
  evaluationScore: number | null;
}

class PromptRegistry {
  private versions: Map<string, PromptVersion[]> =
    new Map();
  private active: Map<string, string> = new Map();

  register(prompt: PromptVersion): void {
    const versions =
      this.versions.get(prompt.name) ?? [];
    versions.push(prompt);
    this.versions.set(prompt.name, versions);
  }

  setActive(name: string, version: string): void {
    const versions = this.versions.get(name);
    if (
      !versions?.some((v) => v.version === version)
    ) {
      throw new Error(
        `Version ${version} not found for ${name}`
      );
    }
    this.active.set(name, version);
  }

  getActive(name: string): PromptVersion {
    const version = this.active.get(name);
    if (!version) {
      throw new Error(`No active version for ${name}`);
    }
    const versions = this.versions.get(name) ?? [];
    return versions.find(
      (v) => v.version === version
    )!;
  }

  render(
    name: string,
    variables: Record<string, string>
  ): string {
    const prompt = this.getActive(name);
    let rendered = prompt.template;

    for (const [key, value] of Object.entries(variables)) {
      rendered = rendered.replaceAll(`{{${key}}}`, value);
    }

    return rendered;
  }
}

// Usage
const registry = new PromptRegistry();

registry.register({
  id: "extract-v1",
  name: "product-extraction",
  version: "1.0.0",
  template: buildExtractionPrompt("{{review}}"),
  variables: ["review"],
  model: "gpt-4",
  temperature: 0,
  maxTokens: 500,
  createdAt: new Date("2024-01-15"),
  evaluationScore: 0.92,
});

registry.setActive("product-extraction", "1.0.0");
Pipeline de evaluación automatizada
Los prompts necesitan pruebas de regresión. Cuando se modifica un prompt, hay que saber si mejoró o empeoró en todo el conjunto de evaluación.
interface EvalCase {
  input: string;
  expectedOutput: Record<string, unknown>;
  tags: string[]; // Edge cases, normal, adversarial
}

interface EvalResult {
  promptVersion: string;
  totalCases: number;
  passed: number;
  failed: number;
  accuracy: number;
  latencyP50: number;
  latencyP95: number;
  failures: Array<{
    input: string;
    expected: unknown;
    actual: unknown;
    reason: string;
  }>;
}

async function evaluatePrompt(
  registry: PromptRegistry,
  promptName: string,
  evalSet: EvalCase[],
  llmClient: LLMClient
): Promise<EvalResult> {
  const prompt = registry.getActive(promptName);
  const failures: EvalResult["failures"] = [];
  const latencies: number[] = [];

  for (const evalCase of evalSet) {
    const rendered = registry.render(promptName, {
      review: evalCase.input,
    });

    const start = performance.now();
    const response = await llmClient.complete({
      prompt: rendered,
      model: prompt.model,
      temperature: prompt.temperature,
      maxTokens: prompt.maxTokens,
    });
    latencies.push(performance.now() - start);

    const parsed = parseExtraction(response);

    if (!parsed) {
      failures.push({
        input: evalCase.input,
        expected: evalCase.expectedOutput,
        actual: response,
        reason: "Failed to parse output",
      });
      continue;
    }

    // Field-level comparison
    for (const [key, expected] of Object.entries(
      evalCase.expectedOutput
    )) {
      if (
        parsed[key as keyof ProductExtraction] !== expected
      ) {
        failures.push({
          input: evalCase.input,
          expected: { [key]: expected },
          actual: {
            [key]: parsed[key as keyof ProductExtraction],
          },
          reason: `Field ${key} mismatch`,
        });
      }
    }
  }

  const sorted = [...latencies].sort((a, b) => a - b);

  return {
    promptVersion: prompt.version,
    totalCases: evalSet.length,
    passed: evalSet.length - failures.length,
    failed: failures.length,
    accuracy:
      (evalSet.length - failures.length) / evalSet.length,
    latencyP50: sorted[Math.floor(sorted.length * 0.5)] ?? 0,
    latencyP95: sorted[Math.floor(sorted.length * 0.95)] ?? 0,
    failures,
  };
}
Conclusiones clave
Los prompts de salida estructurada necesitan definiciones explícitas de esquema, restricciones de formato de salida y validación posterior a la respuesta, con un parseo de respaldo para las marcas de código markdown que los modelos a veces añaden pese a las instrucciones. Los ejemplos few-shot calibran el comportamiento del modelo de forma más fiable que las instrucciones por sí solas: hay que seleccionar ejemplos que cubran casos límite, como entradas con múltiples intenciones y textos cargados emocionalmente, no solo escenarios ideales. El prompting por cadena de pensamiento con pasos de razonamiento explícitos mejora la precisión en decisiones de varios pasos al obligar al modelo a evaluar cada condición antes de llegar a una conclusión. El versionado de prompts mediante un patrón de registro permite pruebas A/B, reversión de cambios y trazabilidad de auditoría: hay que tratar los prompts como artefactos versionados con sus parámetros de modelo asociados, no como cadenas de texto incrustadas. Los pipelines de evaluación automatizada con casos de prueba etiquetados (normales, límite, adversariales) detectan regresiones cuando cambian los prompts, midiendo tanto la precisión como la latencia para garantizar la fiabilidad en producción.