Creación de asistentes de revisión de código con IA usando APIs de LLM
Crea un asistente de revisión que se integra en CI, usa APIs de LLM para analizar pull requests en busca de errores y vulnerabilidades, y comenta el PR.
Más allá de los linters: revisión semántica de código
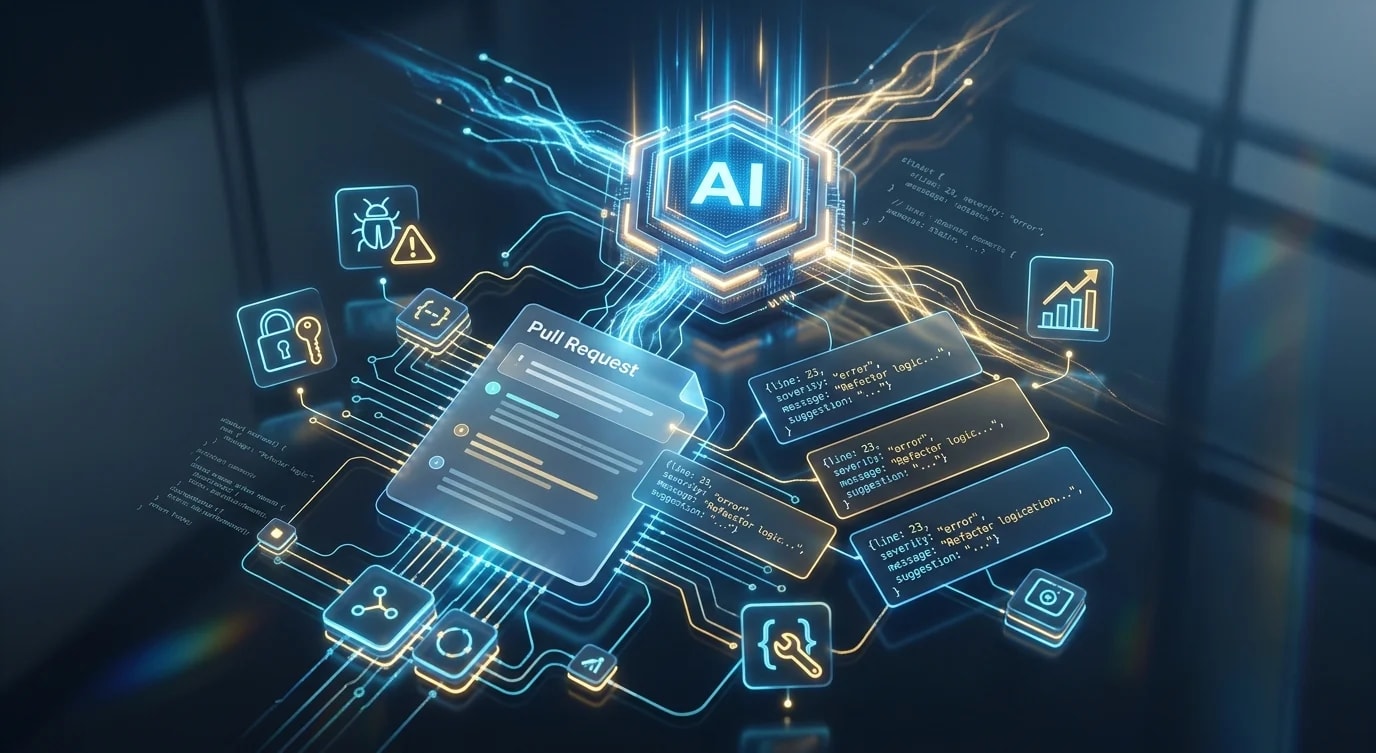
Los linters detectan violaciones de sintaxis y problemas de formato. Pero no pueden decirte que una función traga errores silenciosamente, que una consulta a la base de datos sufrirá un N+1 bajo carga, o que un endpoint de API carece de rate limiting. Los LLM pueden razonar sobre el código de forma semántica, lo que los convierte en asistentes potentes para los patrones de revisión que el análisis estático no detecta.
Extracción de diffs de PR para el análisis
El primer paso es obtener el diff del pull request en un formato que el LLM pueda procesar. Los diffs de Git contienen ruido: cambios de espacios en blanco, renombrados, archivos generados. Filtra todo esto antes de enviar tokens al modelo.
interface PRFile {
  filename: string;
  status: "added" | "modified" | "removed" | "renamed";
  patch: string;
  additions: number;
  deletions: number;
}

async function getFilteredPRFiles(
  owner: string,
  repo: string,
  prNumber: number
): Promise<PRFile[]> {
  const octokit = new Octokit({ auth: process.env.GITHUB_TOKEN });
  const { data: files } = await octokit.pulls.listFiles({
    owner,
    repo,
    pull_number: prNumber,
    per_page: 100,
  });

  const ignoredPatterns = [
    /\.lock$/,
    /package-lock\.json$/,
    /\.min\.(js|css)$/,
    /dist\//,
    /\.generated\./,
    /\.snap$/,
  ];

  return files
    .filter((file) => !ignoredPatterns.some((p) => p.test(file.filename)))
    .filter((file) => file.patch) // Has actual diff content
    .map((file) => ({
      filename: file.filename,
      status: file.status as PRFile["status"],
      patch: file.patch!,
      additions: file.additions,
      deletions: file.deletions,
    }));
}
Estructuración del prompt para el LLM
El diseño del prompt determina la calidad de la revisión. Dale al modelo un rol claro, criterios de revisión específicos y un formato de salida estructurado. Evita pedirle que "revise todo": en su lugar, concéntralo en categorías de problemas.
// ❌ Vague prompt — produces generic, unhelpful reviews
const badPrompt = `Review this code: ${diff}`;

// ✅ Structured prompt with specific criteria and output format
function buildReviewPrompt(file: PRFile, context: string): string {
  return `You are a senior software engineer reviewing a pull request.
Analyze the following code diff and identify specific issues.

## Review Criteria
1. **Bugs**: Logic errors, off-by-one, null/undefined risks, race conditions
2. **Security**: Injection vulnerabilities, missing auth checks, exposed secrets
3. **Performance**: N+1 queries, unnecessary re-renders, missing indexes
4. **Error Handling**: Swallowed errors, missing try/catch, unclear error messages

## File Context
Filename: ${file.filename}
Change type: ${file.status}
${context ? `Related context:\n${context}` : ""}

## Diff
\`\`\`
${file.patch}
\`\`\`

## Output Format
Respond with a JSON array of issues found. If no issues, return an empty array.
Each issue must include:
- line: the line number in the new file
- severity: "error" | "warning" | "suggestion"
- category: one of the review criteria above
- message: specific, actionable feedback (1-2 sentences)
- suggestion: optional code fix

Return ONLY the JSON array, no other text.`;
}
Llamada a la API del LLM con salida estructurada
Convierte la respuesta del LLM en comentarios de revisión tipados. Maneja las respuestas malformadas con cautela: los LLM no siempre siguen el formato de salida a la perfección.
interface ReviewComment {
  line: number;
  severity: "error" | "warning" | "suggestion";
  category: string;
  message: string;
  suggestion?: string;
}

async function analyzeFile(
  file: PRFile,
  context: string
): Promise<ReviewComment[]> {
  const prompt = buildReviewPrompt(file, context);

  const response = await fetch("https://api.openai.com/v1/chat/completions", {
    method: "POST",
    headers: {
      "Content-Type": "application/json",
      Authorization: `Bearer ${process.env.OPENAI_API_KEY}`,
    },
    body: JSON.stringify({
      model: "gpt-4o",
      messages: [{ role: "user", content: prompt }],
      temperature: 0.1, // Low temperature for consistent analysis
      response_format: { type: "json_object" },
    }),
  });

  const data = await response.json();
  const content = data.choices[0]?.message?.content;

  if (!content) return [];

  try {
    const parsed = JSON.parse(content);
    const comments = Array.isArray(parsed) ? parsed : parsed.issues ?? [];
    return comments.filter(isValidComment);
  } catch {
    console.error(`Failed to parse LLM response for ${file.filename}`);
    return [];
  }
}

function isValidComment(comment: unknown): comment is ReviewComment {
  if (typeof comment !== "object" || comment === null) return false;
  const c = comment as Record<string, unknown>;
  return (
    typeof c.line === "number" &&
    typeof c.message === "string" &&
    ["error", "warning", "suggestion"].includes(c.severity as string)
  );
}
Publicación de comentarios en el pull request
Mapea los comentarios de revisión del LLM a líneas específicas del diff del PR. La API de revisiones de GitHub requiere la posición dentro del diff, no el número de línea absoluto, así que necesitas hacer la conversión.
async function postReviewComments(
  owner: string,
  repo: string,
  prNumber: number,
  commitSha: string,
  fileComments: Map<string, ReviewComment[]>
): Promise<void> {
  const octokit = new Octokit({ auth: process.env.GITHUB_TOKEN });

  const comments: Array<{
    path: string;
    position?: number;
    line: number;
    side: "RIGHT";
    body: string;
  }> = [];

  for (const [filename, fileReviewComments] of fileComments) {
    for (const comment of fileReviewComments) {
      const icon =
        comment.severity === "error" ? "🔴" :
        comment.severity === "warning" ? "🟡" : "🔵";

      let body = `${icon} **${comment.category}** (${comment.severity})\n\n${comment.message}`;

      if (comment.suggestion) {
        body += `\n\n\`\`\`suggestion\n${comment.suggestion}\n\`\`\``;
      }

      comments.push({
        path: filename,
        line: comment.line,
        side: "RIGHT",
        body,
      });
    }
  }

  if (comments.length === 0) {
    await octokit.pulls.createReview({
      owner,
      repo,
      pull_number: prNumber,
      commit_id: commitSha,
      body: "✅ AI review found no issues in the changed files.",
      event: "COMMENT",
    });
    return;
  }

  await octokit.pulls.createReview({
    owner,
    repo,
    pull_number: prNumber,
    commit_id: commitSha,
    body: `🤖 AI Code Review — Found ${comments.length} item(s) to review.`,
    event: "COMMENT",
    comments,
  });
}
Integración con CI mediante GitHub Actions
Ejecuta el asistente de revisión automáticamente en cada pull request. Define límites de tokens y controles de costo para evitar facturas descontroladas de la API.
# .github/workflows/ai-review.yml
name: AI Code Review
on:
  pull_request:
    types: [opened, synchronize]

jobs:
  review:
    runs-on: ubuntu-latest
    permissions:
      pull-requests: write
      contents: read
    steps:
      - uses: actions/checkout@v4
        with:
          fetch-depth: 0

      - uses: actions/setup-node@v4
        with:
          node-version: "20"

      - name: Install dependencies
        run: npm ci

      - name: Run AI Review
        env:
          GITHUB_TOKEN: ${{ secrets.GITHUB_TOKEN }}
          OPENAI_API_KEY: ${{ secrets.OPENAI_API_KEY }}
        run: |
          node scripts/ai-review.mjs \
            --owner=${{ github.repository_owner }} \
            --repo=${{ github.event.repository.name }} \
            --pr=${{ github.event.pull_request.number }} \
            --sha=${{ github.event.pull_request.head.sha }} \
            --max-files=20 \
            --max-tokens=50000
Conclusiones clave
Los asistentes de revisión de código impulsados por LLM complementan a los humanos: detectan problemas semánticos que los linters pasan por alto mientras las personas se concentran en la arquitectura y las decisiones de diseño. Filtra los diffs para excluir archivos generados y lock files antes de enviarlos a la API. Estructura los prompts con criterios de revisión específicos y un formato de salida estricto para obtener comentarios accionables y fáciles de procesar.
Valida las respuestas del LLM de forma defensiva: los modelos no siempre producen JSON válido ni siguen las instrucciones a la perfección. Publica los comentarios directamente en las líneas del PR usando la API de revisiones para que el feedback aparezca en contexto. Establece controles de costo mediante límites de archivos y presupuestos de tokens. Ejecuta el asistente en CI para mayor consistencia, y mantén baja la temperatura del modelo para obtener análisis reproducibles. El asistente debe sacar a la luz problemas para el juicio humano, nunca aprobar ni fusionar de forma autónoma.