Backend
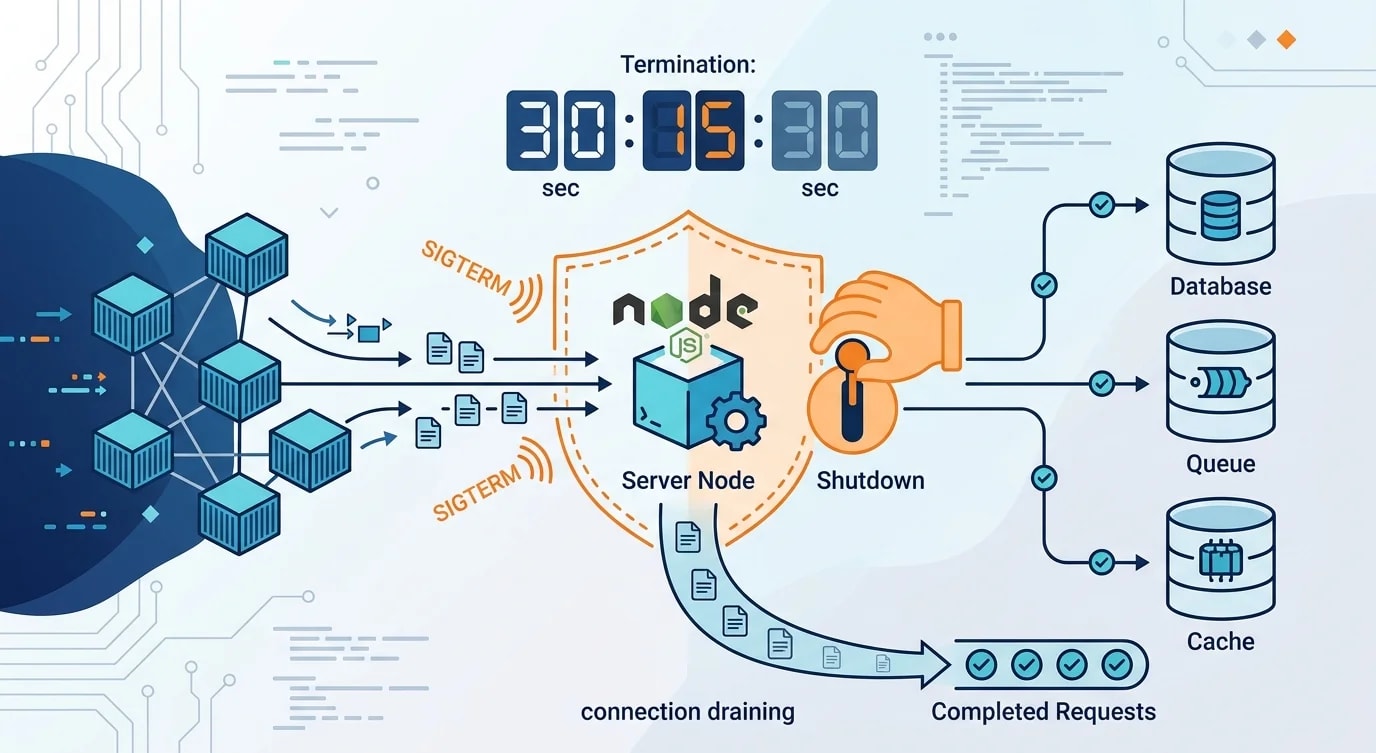
Apagado controlado en servicios Node.js en producción
La mayoría de servicios Node.js descartan peticiones en curso en cada despliegue: cómo manejar SIGTERM, drenar conexiones y salir limpio en Kubernetes.
·6 min de lectura
Etiquetas
13 artículos · Página 1 de 2
La mayoría de servicios Node.js descartan peticiones en curso en cada despliegue: cómo manejar SIGTERM, drenar conexiones y salir limpio en Kubernetes.

Un marco probado para diagnosticar y resolver incidentes en producción rápido, desde la primera alerta hasta la causa raíz y la prevención.

Implementa structured logging en Node.js: entradas analizables y buscables, con IDs de correlación, severidades coherentes y propagación de contexto.
Practica la ingeniería del caos inyectando fallos controlados en producción para hallar debilidades: particiones de red, agotamiento y fallos de dependencias.
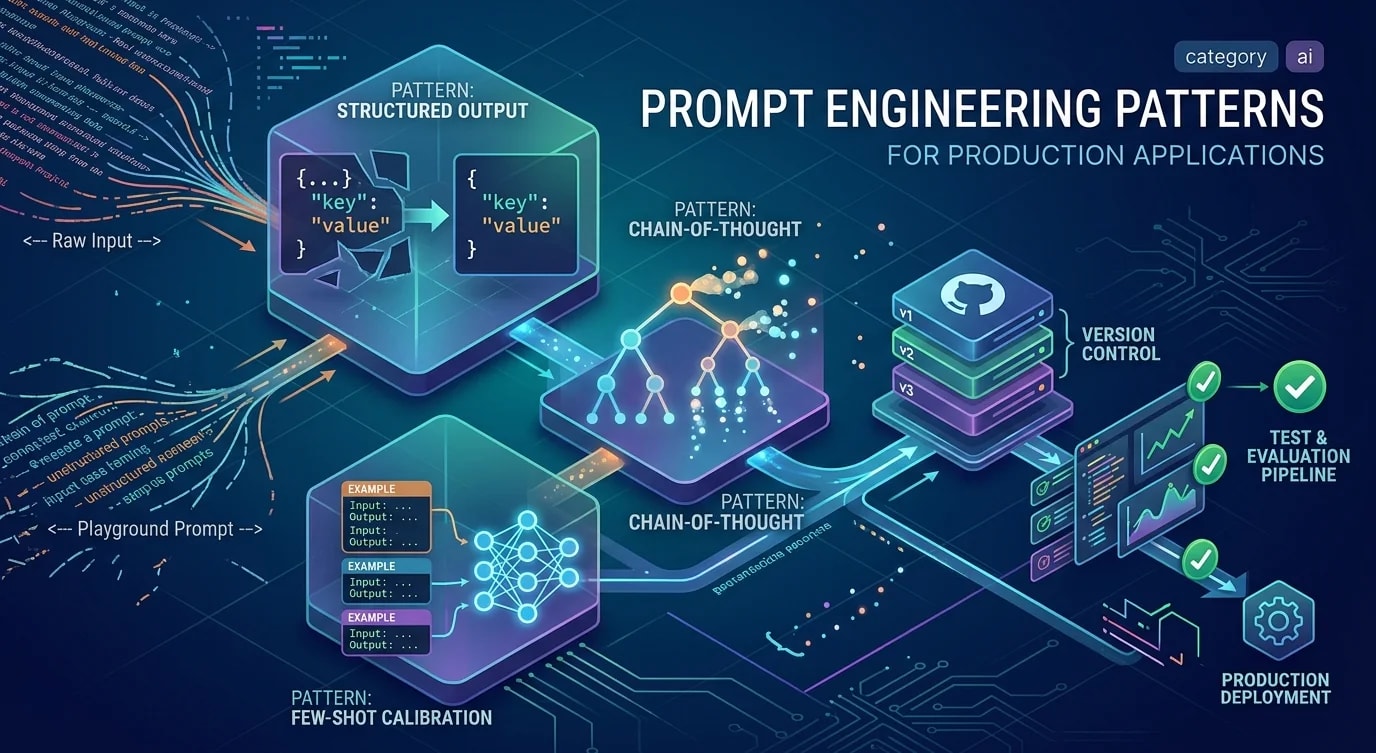
Patrones sistemáticos de prompts para aplicaciones LLM en producción: salida estructurada, cadena de pensamiento, few-shot, versionado y evaluación.

Técnicas prácticas para endurecer contenedores Docker: análisis de imágenes, mínimo privilegio, gestión de secretos, redes y monitoreo en ejecución.

Cómo crear pipelines de NLP listos para producción: preprocesamiento, tokenización, embeddings, clasificación y extracción de entidades.

Cómo implementar logging estructurado para depurar producción rápido: formatos JSON, propagación de contexto, niveles, enmascarado y agregación.

Cómo configurar y monitorizar pools de conexiones: dimensionado, detección de fugas, failover y los errores de configuración más habituales.

Técnicas para diagnosticar fugas de memoria, asignación excesiva y muertes por OOM en producción: heap snapshots, profiling y patrones de fuga.

La ingeniería del caos inyecta fallos deliberados en sistemas de producción para descubrir debilidades antes de que causen interrupciones reales.
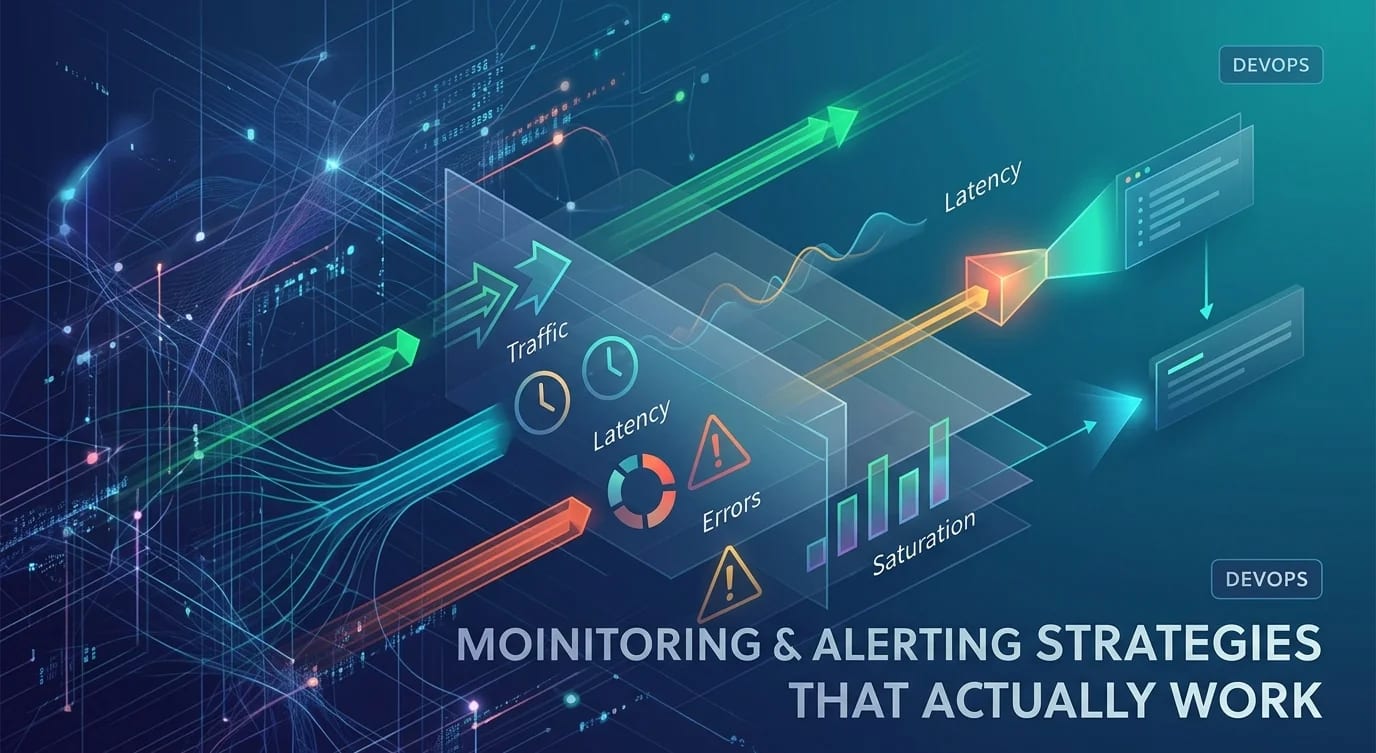
La fatiga por alertas arruina la respuesta a incidentes: construye tu monitoreo sobre SLIs, umbrales significativos y alertas accionables.