Künstliche Intelligenz
LLMs integrieren: Muster, die in Produktion bestehen
Praktische Muster für zuverlässige, kosteneffiziente LLM-Funktionen: Prompt-Engineering, Streaming, strukturierte Ausgaben, Fallbacks und Kosten.
·3 Min. Lesezeit
Tags
19 Artikel · Seite 1 von 2
Praktische Muster für zuverlässige, kosteneffiziente LLM-Funktionen: Prompt-Engineering, Streaming, strukturierte Ausgaben, Fallbacks und Kosten.
Entwickle einen Code-Review-Assistenten, der sich in CI einklinkt, Pull Requests per LLM-API auf Bugs und Sicherheitslücken prüft und im PR kommentiert.

Praktischer Leitfaden für produktive RAG-Systeme mit fundierten Antworten: Embeddings, Vektordatenbank, Chunking, Reranking und Evaluierung.
Feintuning von Sprachmodellen mit LoRA und QLoRA: Datensatzvorbereitung, Trainingsstrategien und Evaluierung — Spezialisten ohne riesiges Compute-Budget.

Baue effektive RAG-Pipelines mit TypeScript: Chunking, Embeddings, Feintuning der Vektorsuche, Prompt-Konstruktion und Evaluation der Retrieval-Qualität.
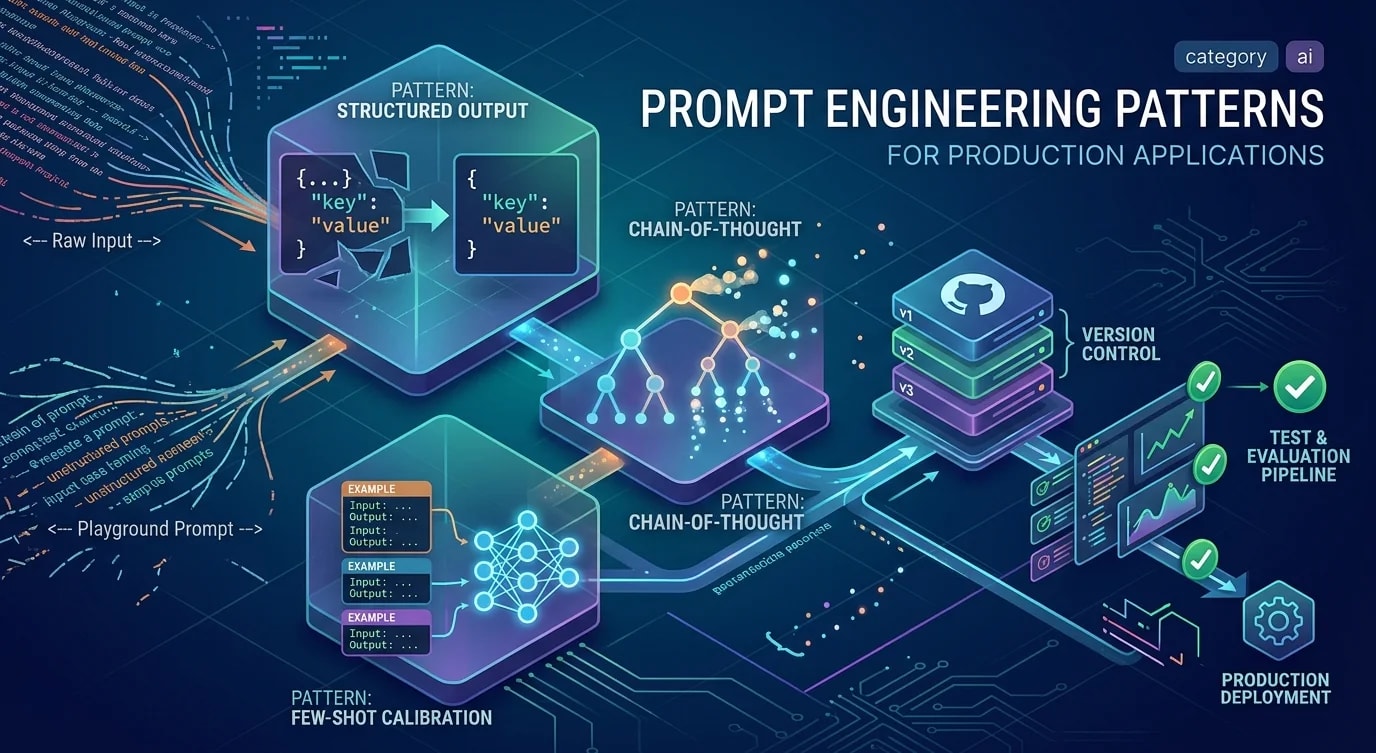
Systematische Prompt-Patterns für produktive LLM-Anwendungen: strukturierte Ausgaben, Chain-of-Thought, Few-Shot-Kalibrierung, Versionierung, Evals.
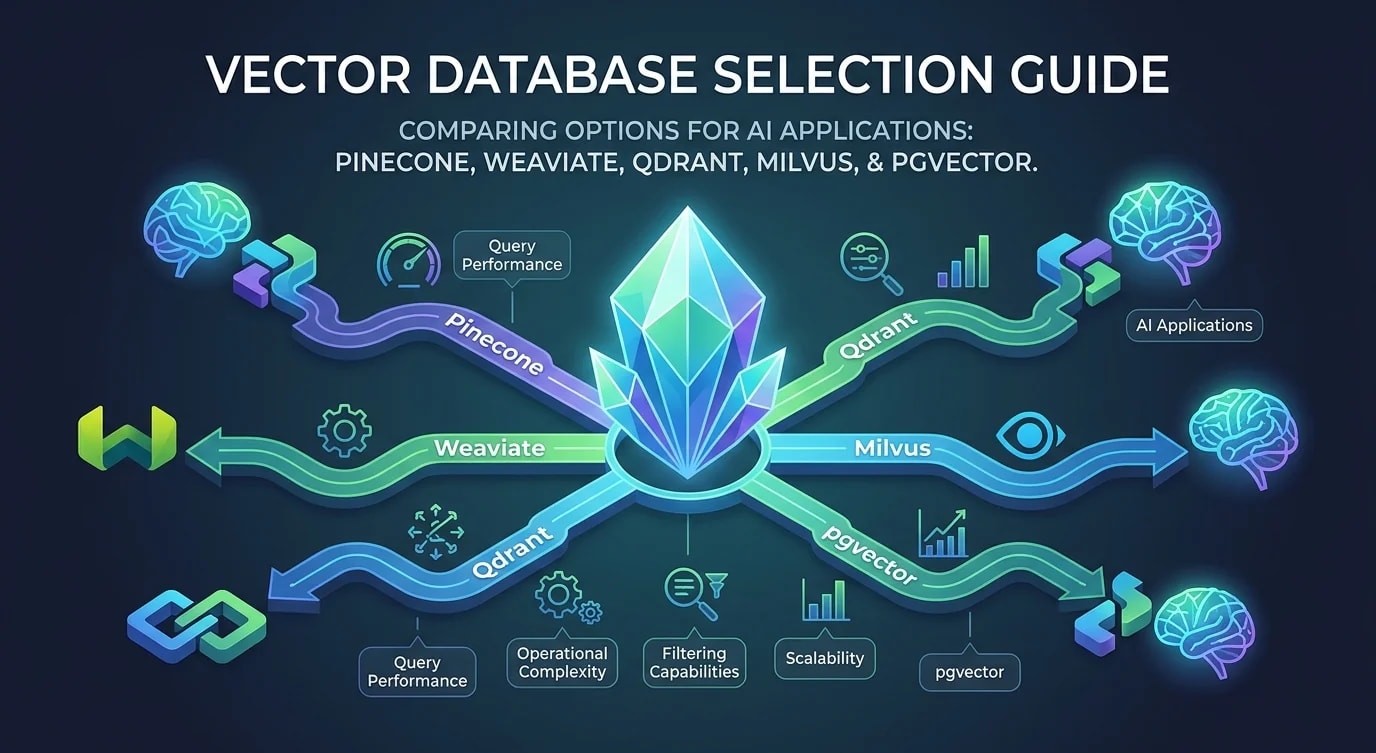
Vergleich von Pinecone, Weaviate, Qdrant, Milvus und pgvector für KI-Anwendungen: Indexierung, Abfrageleistung, Filterung, Betriebskomplexität.
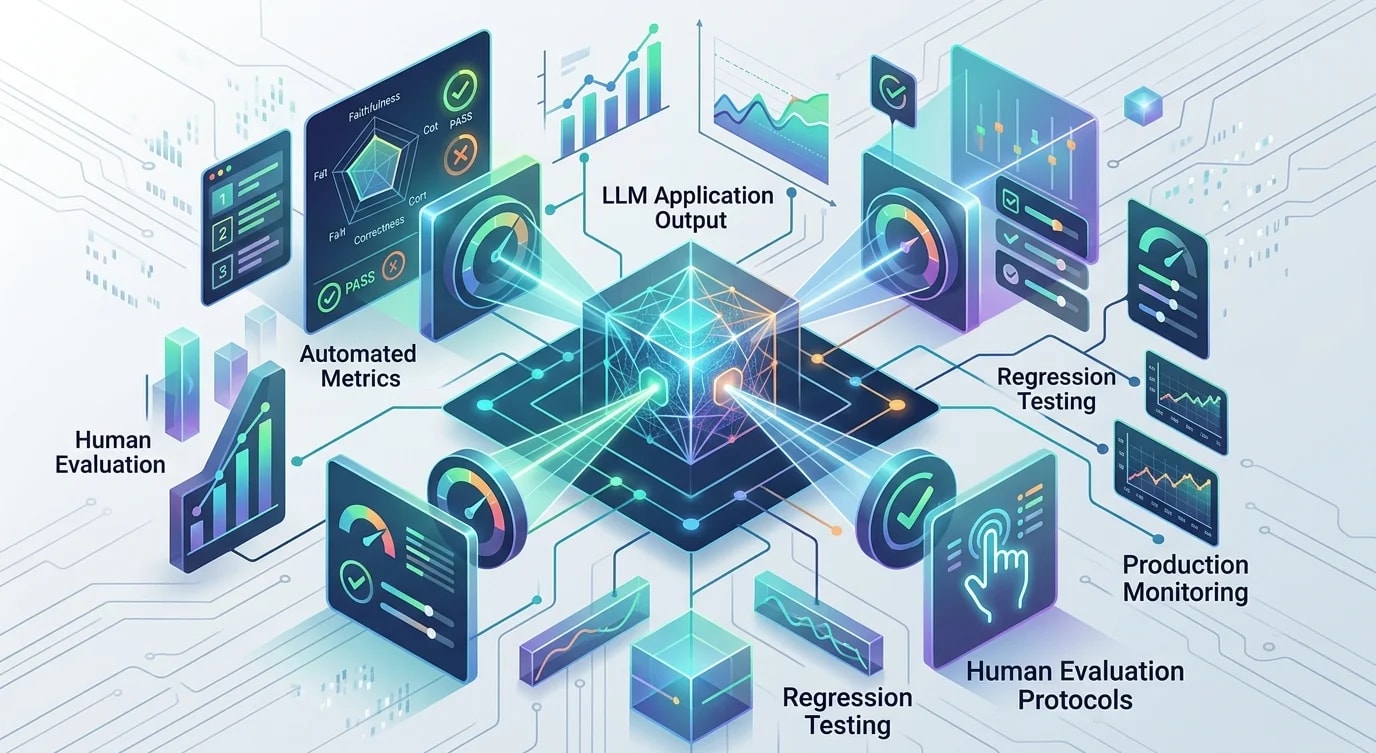
Systematische Evaluierungs-Pipelines für LLM-Anwendungen: automatisierte Metriken, menschliche Bewertung, Regressionstests, Prompt-Versionierung.
Wie man LLMs in Code-Reviews einbindet: Review-Bots, Prompt-Muster zum Bug-Finden, Sicherheitsanalysen und die Balance mit menschlichem Urteil.

Praktischer Leitfaden zu Vektordatenbanken für Ähnlichkeitssuche: Embeddings, Indexierungsstrategien, Distanzmetriken und die Wahl des Systems.

Wie man produktionsreife NLP-Pipelines baut: Textvorverarbeitung, Tokenisierung, Embeddings, Klassifikation und Entitätsextraktion.

Eine praktische Einführung in Empfehlungssysteme: Collaborative Filtering, Content-based Filtering und hybride Ansätze, in TypeScript umgesetzt.