RAG-Systeme bauen, die wirklich funktionieren
Praktischer Leitfaden für produktive RAG-Systeme mit fundierten Antworten: Embeddings, Vektordatenbank, Chunking, Reranking und Evaluierung.

Warum RAG in den meisten Fällen besser ist als Fine-Tuning
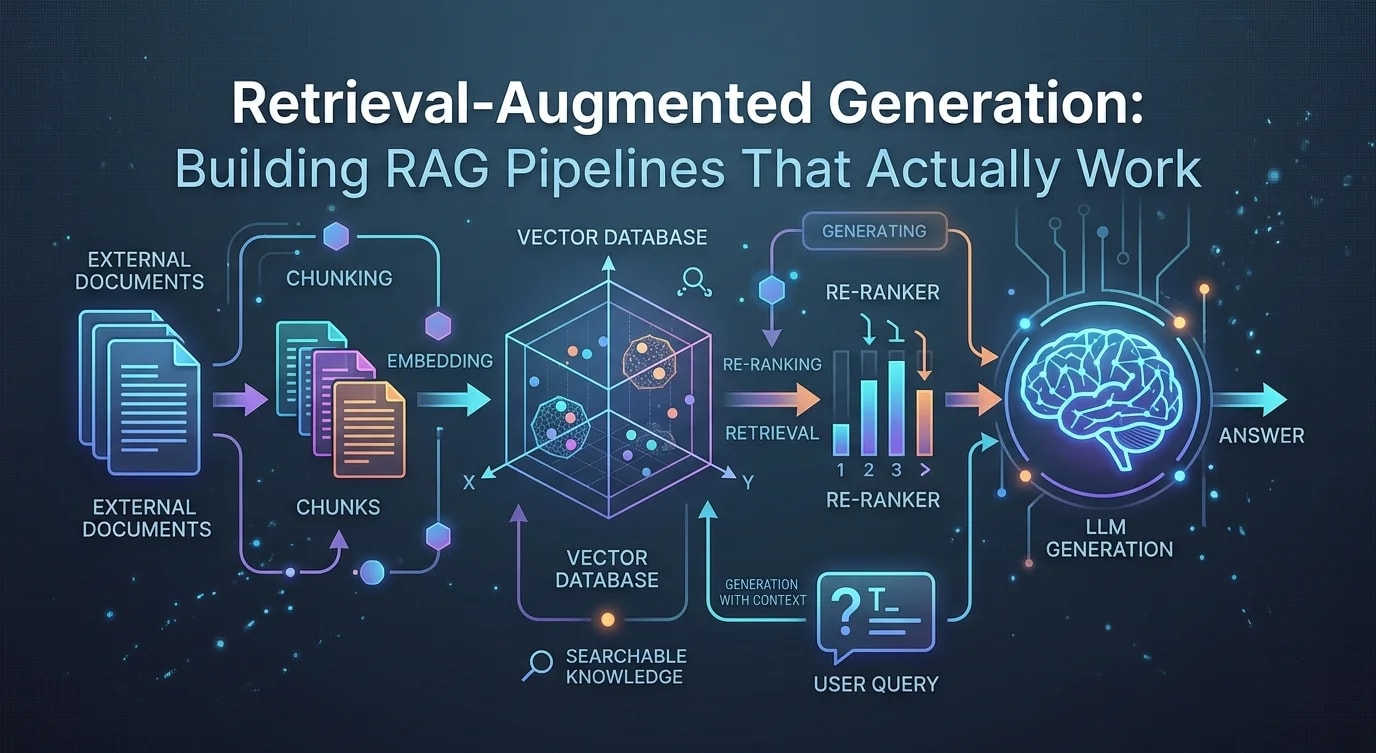
Ein LLM mit eigenen Daten zu fine-tunen, brennt Wissen in die Modellgewichte. Das ist teuer, langsam zu aktualisieren und nicht nachprüfbar. RAG hält das Wissen extern in einem durchsuchbaren Index und füttert dem LLM zur Abfragezeit relevanten Kontext. Du kannst die Wissensbasis ohne Retraining aktualisieren, jede Antwort bis zu den Quelldokumenten zurückverfolgen und kontrollieren, auf welche Informationen das Modell zugreifen kann.
Aber naives RAG – Dokumente embedden, Top-K abrufen, in den Prompt stopfen – scheitert in der Produktion. Ein System zu bauen, das funktioniert, erfordert sorgfältige Aufmerksamkeit in jeder Phase der Pipeline.
Chunking-Strategien für Dokumente
Wie du Dokumente aufteilst, entscheidet darüber, ob der Retrieval-Schritt relevanten Kontext findet oder Fragmente zurückgibt, die das LLM verwirren.
interface Chunk {
  id: string;
  content: string;
  metadata: {
    source: string;
    section: string;
    pageNumber?: number;
    chunkIndex: number;
    tokenCount: number;
  };
}

// ❌ Fixed-size chunking — splits mid-sentence, loses context
function naiveChunk(text: string, maxChars: number): string[] {
  const chunks: string[] = [];
  for (let i = 0; i < text.length; i += maxChars) {
    chunks.push(text.slice(i, i + maxChars));
  }
  return chunks;
}

// ✅ Semantic chunking — respects document structure
function semanticChunk(
  text: string,
  options: {
    maxTokens: number;
    overlapTokens: number;
    separators: string[];
  }
): Chunk[] {
  const { maxTokens, overlapTokens, separators } = options;
  const chunks: Chunk[] = [];

  // Split by strongest separator first
  let sections = [text];
  for (const separator of separators) {
    sections = sections.flatMap((section) =>
      section.split(separator).filter((s) => s.trim())
    );
  }

  let currentChunk = "";
  let chunkIndex = 0;

  for (const section of sections) {
    const sectionTokens = estimateTokens(section);

    if (estimateTokens(currentChunk) + sectionTokens > maxTokens) {
      if (currentChunk.trim()) {
        chunks.push({
          id: `chunk-${chunkIndex}`,
          content: currentChunk.trim(),
          metadata: {
            source: "",
            section: extractHeading(currentChunk),
            chunkIndex,
            tokenCount: estimateTokens(currentChunk),
          },
        });
        chunkIndex++;

        // Keep overlap for context continuity
        const words = currentChunk.split(/\s+/);
        const overlapWords = words.slice(-overlapTokens);
        currentChunk = overlapWords.join(" ") + "\n" + section;
      }
    } else {
      currentChunk += "\n" + section;
    }
  }

  if (currentChunk.trim()) {
    chunks.push({
      id: `chunk-${chunkIndex}`,
      content: currentChunk.trim(),
      metadata: {
        source: "",
        section: extractHeading(currentChunk),
        chunkIndex,
        tokenCount: estimateTokens(currentChunk),
      },
    });
  }

  return chunks;
}
Die Hierarchie der Separatoren ist entscheidend: erst nach Überschriften teilen, dann nach Absätzen, dann nach Sätzen. Overlap zwischen Chunks stellt sicher, dass Kontext, der eine Grenze überspannt, nicht verloren geht. Bei Code-Dokumentation behandle Funktionsdefinitionen und Klassengrenzen als primäre Separatoren.
Embedding und Indexierung
Die Qualität der Embeddings bestimmt die Qualität des Retrievals. Die Wahl des Embedding-Modells ist weniger wichtig als die Art, wie du den Text vor dem Embedding vorbereitest.
interface EmbeddingConfig {
  model: string;
  dimensions: number;
  maxInputTokens: number;
  batchSize: number;
}

class DocumentIndexer {
  constructor(
    private readonly embedder: EmbeddingService,
    private readonly vectorStore: VectorStore,
    private readonly config: EmbeddingConfig
  ) {}

  async indexDocuments(documents: Document[]): Promise<IndexResult> {
    let totalChunks = 0;
    let totalTokens = 0;

    for (const doc of documents) {
      const chunks = semanticChunk(doc.content, {
        maxTokens: this.config.maxInputTokens,
        overlapTokens: 50,
        separators: ["\n## ", "\n### ", "\n\n", ". "],
      });

      // Enrich chunks with document-level metadata
      const enrichedChunks = chunks.map((chunk) => ({
        ...chunk,
        content: this.enrichContent(chunk, doc),
        metadata: {
          ...chunk.metadata,
          source: doc.source,
          documentTitle: doc.title,
          lastUpdated: doc.updatedAt,
        },
      }));

      // Batch embed for efficiency
      for (let i = 0; i < enrichedChunks.length; i += this.config.batchSize) {
        const batch = enrichedChunks.slice(i, i + this.config.batchSize);
        const embeddings = await this.embedder.embed(
          batch.map((c) => c.content)
        );

        await this.vectorStore.upsert(
          batch.map((chunk, idx) => ({
            id: chunk.id,
            vector: embeddings[idx],
            metadata: chunk.metadata,
            content: chunk.content,
          }))
        );
      }

      totalChunks += enrichedChunks.length;
      totalTokens += enrichedChunks.reduce(
        (sum, c) => sum + c.metadata.tokenCount,
        0
      );
    }

    return { totalChunks, totalTokens };
  }

  private enrichContent(chunk: Chunk, doc: Document): string {
    // Prepend document context for better embeddings
    return `Document: ${doc.title}\nSection: ${chunk.metadata.section}\n\n${chunk.content}`;
  }
}
Retrieval und Reranking
Die Vektorähnlichkeitssuche liefert die K ähnlichsten Chunks, aber Ähnlichkeit ist nicht Relevanz. Ein Reranking-Schritt bewertet die abgerufenen Chunks gegen die tatsächliche Anfrage mit einem Cross-Encoder, der genauer ist als die Embedding-Ähnlichkeit allein.
interface RetrievalResult {
  chunks: ScoredChunk[];
  query: string;
  retrievalTimeMs: number;
}

interface ScoredChunk {
  chunk: Chunk;
  similarityScore: number;
  rerankScore?: number;
  finalScore: number;
}

class RAGRetriever {
  constructor(
    private readonly vectorStore: VectorStore,
    private readonly reranker: Reranker,
    private readonly config: {
      initialK: number;    // Retrieve more candidates
      finalK: number;      // Return fewer, better results
      similarityThreshold: number;
    }
  ) {}

  async retrieve(query: string): Promise<RetrievalResult> {
    const start = Date.now();

    // Stage 1: Broad retrieval via vector similarity
    const candidates = await this.vectorStore.search(
      query,
      this.config.initialK
    );

    // Filter by minimum similarity
    const filtered = candidates.filter(
      (c) => c.score >= this.config.similarityThreshold
    );

    // Stage 2: Rerank with cross-encoder
    const reranked = await this.reranker.rank(
      query,
      filtered.map((c) => c.content)
    );

    // Combine scores and take top-K
    const scored: ScoredChunk[] = filtered
      .map((candidate, idx) => ({
        chunk: candidate.chunk,
        similarityScore: candidate.score,
        rerankScore: reranked[idx].score,
        finalScore: 0.3 * candidate.score + 0.7 * reranked[idx].score,
      }))
      .sort((a, b) => b.finalScore - a.finalScore)
      .slice(0, this.config.finalK);

    return {
      chunks: scored,
      query,
      retrievalTimeMs: Date.now() - start,
    };
  }
}
Prompt-Konstruktion und Generierung
Der finale Prompt muss den abgerufenen Kontext klar von der Frage des Nutzers trennen. Das LLM braucht Anweisungen zum Umgang mit widersprüchlichen Quellen, fehlenden Informationen und den Grenzen dessen, was es beantworten soll.
function buildRAGPrompt(
  query: string,
  retrievedChunks: ScoredChunk[],
  conversationHistory: Message[]
): string {
  const context = retrievedChunks
    .map(
      (chunk, idx) =>
        `[Source ${idx + 1}: ${chunk.chunk.metadata.source}]\n${chunk.chunk.content}`
    )
    .join("\n\n---\n\n");

  return `You are a helpful assistant. Answer the user's question based ONLY on the provided context. If the context does not contain enough information to answer, say so explicitly. Do not make up information.

If multiple sources contradict each other, note the discrepancy and present both perspectives.

## Context
${context}

## Conversation History
${conversationHistory.map((m) => `${m.role}: ${m.content}`).join("\n")}

## Current Question
${query}

## Instructions
- Cite sources using [Source N] notation
- If the answer requires information not in the context, state what is missing
- Be concise and direct`;
}
Evaluation und Qualitätsmetriken
Man kann nicht verbessern, was man nicht misst. RAG-Systeme müssen entlang zweier Achsen evaluiert werden: Retrieval-Qualität (hat das System die richtigen Chunks gefunden?) und Generierungsqualität (hat das LLM eine korrekte, fundierte Antwort erzeugt?).
interface RAGEvaluation {
  retrievalMetrics: {
    precision: number;    // Relevant chunks / retrieved chunks
    recall: number;       // Retrieved relevant / total relevant
    mrr: number;          // Mean Reciprocal Rank
  };
  generationMetrics: {
    faithfulness: number; // Is every claim supported by context?
    relevance: number;    // Does the answer address the question?
    completeness: number; // Are all relevant aspects covered?
  };
}

async function evaluateRAG(
  testCases: Array<{
    query: string;
    expectedChunkIds: string[];
    expectedAnswer: string;
  }>,
  retriever: RAGRetriever,
  generator: RAGGenerator
): Promise<RAGEvaluation> {
  let totalPrecision = 0;
  let totalRecall = 0;
  let totalMRR = 0;

  for (const testCase of testCases) {
    const result = await retriever.retrieve(testCase.query);
    const retrievedIds = result.chunks.map((c) => c.chunk.id);

    const relevant = retrievedIds.filter((id) =>
      testCase.expectedChunkIds.includes(id)
    );

    totalPrecision += relevant.length / retrievedIds.length;
    totalRecall += relevant.length / testCase.expectedChunkIds.length;

    // MRR: position of first relevant result
    const firstRelevantIdx = retrievedIds.findIndex((id) =>
      testCase.expectedChunkIds.includes(id)
    );
    totalMRR += firstRelevantIdx >= 0 ? 1 / (firstRelevantIdx + 1) : 0;
  }

  const n = testCases.length;

  return {
    retrievalMetrics: {
      precision: totalPrecision / n,
      recall: totalRecall / n,
      mrr: totalMRR / n,
    },
    generationMetrics: {
      faithfulness: 0, // Requires LLM-as-judge evaluation
      relevance: 0,
      completeness: 0,
    },
  };
}
Die wichtigsten Erkenntnisse
Produktive RAG-Systeme scheitern, wenn auch nur eine einzige Phase schwach ist. Das Chunking bestimmt, ob relevanter Kontext überhaupt abrufbar ist. Die Embedding-Qualität hängt mehr von der Eingabevorbereitung ab als von der Modellwahl. Reranking ist die einzelne Maßnahme mit der größten Wirkung – es verwandelt grobe Ähnlichkeit in präzise Relevanz.
Baue das Evaluation-Framework, bevor du irgendetwas anderes optimierst. Ohne Ground-Truth-Testfälle, die Retrieval-Precision, Recall und die Treue der Generierung messen, ist jede Änderung bloßes Raten. Beginne mit einem kleinen, hochwertigen Testset und erweitere es, sobald sich Fehlermuster zeigen.
Der Prompt ist der Vertrag zwischen Retrieval und Generierung. Er muss Kontext klar von Anweisungen abgrenzen, dem Modell sagen, wann es eine Antwort verweigern soll, und Quellenangaben verlangen. Ein gut strukturierter Prompt mit mittelmäßigem Retrieval schlägt jedes Mal einen schlechten Prompt mit exzellentem Retrieval.