Observability-getriebene Entwicklung
Verschiebe Observability nach links: strukturierte Logs, verteilte Traces und aussagekräftige Metriken von Anfang an — schnelleres Debugging.

Observability ist nicht Monitoring
Monitoring sagt dir, wann etwas nicht stimmt. Observability sagt dir, warum. Monitoring prüft bekannte Fehlermodi anhand vordefinierter Schwellenwerte. Observability erlaubt es dir, beliebige Fragen zum Systemverhalten zu stellen, ohne neuen Code auszurollen.
Der Unterschied ist wichtig, weil moderne verteilte Systeme auf neuartige Weise ausfallen. Man kann nicht jeden Fehlermodus im Voraus vorhersehen, aber man kann sein System so instrumentieren, dass man bei einem unerwarteten Vorfall die Ursache in Minuten statt in Stunden findet.
Strukturiertes Logging, das skaliert
Unstrukturierte Logs sind Textdateien, die man mit grep durchsuchen kann. Strukturierte Logs sind abfragbare Events mit typisierten Feldern, Correlation-IDs und Kontextmetadaten, die das Debugging über mehrere Services hinweg erst möglich machen.
// ❌ Unstructured logging — nearly useless at scale
console.log(`User ${userId} failed to checkout: ${error.message}`);

// ✅ Structured logging — queryable, correlatable, actionable
import { Logger } from "./logger";

interface LogContext {
  traceId: string;
  spanId: string;
  service: string;
  environment: string;
}

class StructuredLogger {
  constructor(private readonly context: LogContext) {}

  info(message: string, fields: Record<string, unknown> = {}): void {
    this.emit("info", message, fields);
  }

  error(
    message: string,
    error: Error,
    fields: Record<string, unknown> = {}
  ): void {
    this.emit("error", message, {
      ...fields,
      error: {
        name: error.name,
        message: error.message,
        stack: error.stack,
      },
    });
  }

  private emit(
    level: string,
    message: string,
    fields: Record<string, unknown>
  ): void {
    const entry = {
      timestamp: new Date().toISOString(),
      level,
      message,
      ...this.context,
      ...fields,
    };
    process.stdout.write(JSON.stringify(entry) + "\n");
  }
}

// Usage with request context
function createRequestLogger(req: Request, baseContext: LogContext): StructuredLogger {
  return new StructuredLogger({
    ...baseContext,
    traceId: req.headers["x-trace-id"] as string || generateTraceId(),
    spanId: generateSpanId(),
  });
}
Jeder Log-Eintrag trägt eine Trace-ID, die ihn mit jedem anderen Log und Span desselben Request-Flows verbindet. Wenn ein Nutzer meldet, dass "mein Checkout fehlgeschlagen ist", fragst du nach der Trace-ID und siehst alle Logs aus allen Services, die an dieser konkreten Anfrage beteiligt waren.
Verteiltes Tracing mit OpenTelemetry
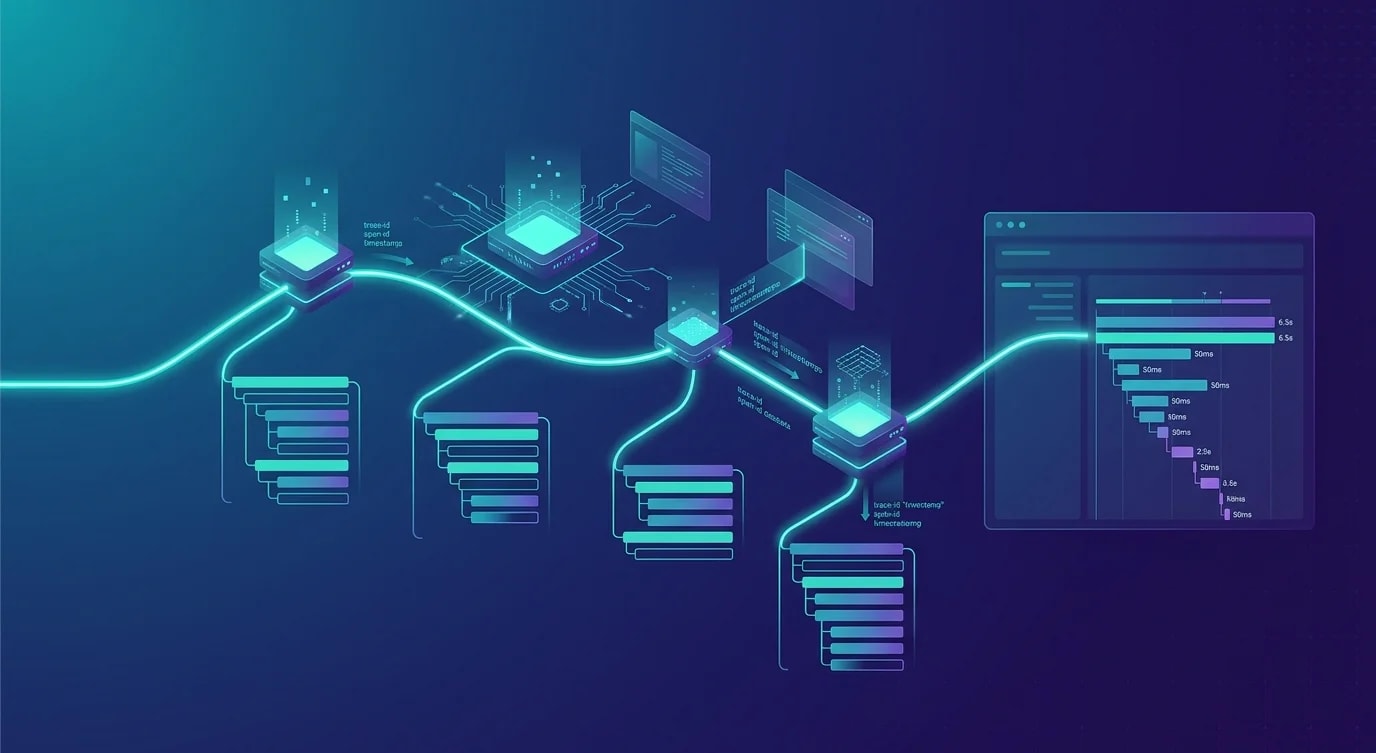
Traces zeigen den vollständigen Weg einer Anfrage durch dein System: welche Services aufgerufen wurden, wie lange jeder davon gebraucht hat, wo der Engpass liegt und welcher Service einen Fehler geworfen hat.
import { trace, SpanStatusCode, context, propagation } from "@opentelemetry/api";

const tracer = trace.getTracer("checkout-service");

async function processCheckout(
  order: Order
): Promise<CheckoutResult> {
  return tracer.startActiveSpan(
    "checkout.process",
    { attributes: { "order.id": order.id, "order.items": order.items.length } },
    async (span) => {
      try {
        // Each step creates a child span
        const inventory = await tracer.startActiveSpan(
          "checkout.verify-inventory",
          async (inventorySpan) => {
            const result = await inventoryService.verify(order.items);
            inventorySpan.setAttribute(
              "inventory.available",
              result.allAvailable
            );
            inventorySpan.end();
            return result;
          }
        );

        if (!inventory.allAvailable) {
          span.setStatus({
            code: SpanStatusCode.ERROR,
            message: "Items out of stock",
          });
          span.end();
          return { success: false, reason: "out-of-stock" };
        }

        const payment = await tracer.startActiveSpan(
          "checkout.process-payment",
          async (paymentSpan) => {
            paymentSpan.setAttribute("payment.method", order.paymentMethod);
            const result = await paymentService.charge(order);
            paymentSpan.setAttribute("payment.status", result.status);
            paymentSpan.end();
            return result;
          }
        );

        span.setStatus({ code: SpanStatusCode.OK });
        span.end();

        return { success: true, transactionId: payment.transactionId };
      } catch (error) {
        span.recordException(error as Error);
        span.setStatus({
          code: SpanStatusCode.ERROR,
          message: (error as Error).message,
        });
        span.end();
        throw error;
      }
    }
  );
}
Metriken, die Entscheidungen leiten
Nicht jede Metrik ist es wert, erfasst zu werden. Die RED-Methode (Rate, Errors, Duration) für Services und die USE-Methode (Utilization, Saturation, Errors) für Ressourcen decken das Wesentliche ab, ohne dich in Dashboards zu ertränken, die niemand ansieht.
import { metrics } from "@opentelemetry/api";

const meter = metrics.getMeter("checkout-service");

// RED metrics for the checkout endpoint
const checkoutCounter = meter.createCounter("checkout.requests.total", {
  description: "Total checkout requests",
});

const checkoutErrors = meter.createCounter("checkout.errors.total", {
  description: "Total checkout errors",
});

const checkoutDuration = meter.createHistogram("checkout.duration.ms", {
  description: "Checkout request duration in milliseconds",
  unit: "ms",
});

// USE metrics for the connection pool
const poolUtilization = meter.createObservableGauge(
  "db.pool.utilization",
  { description: "Database pool utilization ratio" }
);

poolUtilization.addCallback((result) => {
  const pool = getConnectionPool();
  result.observe(pool.activeConnections / pool.maxConnections, {
    pool: "primary",
  });
});

// Middleware to instrument every request
function instrumentRequest(
  handler: RequestHandler
): RequestHandler {
  return async (req, res) => {
    const start = Date.now();
    const attributes = {
      "http.method": req.method,
      "http.route": req.route?.path || "unknown",
    };

    try {
      const result = await handler(req, res);
      checkoutCounter.add(1, { ...attributes, "http.status": res.statusCode });
      return result;
    } catch (error) {
      checkoutErrors.add(1, {
        ...attributes,
        "error.type": (error as Error).name,
      });
      throw error;
    } finally {
      checkoutDuration.record(Date.now() - start, attributes);
    }
  };
}
Korrelation: die drei Säulen verbinden
Die Stärke von Observability liegt in der Korrelation: vom auffälligen Metrikwert zu den konkreten Traces springen, die ihn verursacht haben, und von dort zu den konkreten Logs innerhalb dieser Traces. Das erfordert einen gemeinsamen Bezeichner: die Trace-ID.
interface ObservabilityContext {
  traceId: string;
  spanId: string;
  serviceName: string;
  environment: string;
}

// Inject context into every outgoing request
async function instrumentedFetch(
  url: string,
  options: RequestInit,
  ctx: ObservabilityContext
): Promise<Response> {
  const headers = new Headers(options.headers);
  headers.set("x-trace-id", ctx.traceId);
  headers.set("x-span-id", ctx.spanId);
  headers.set("x-service-name", ctx.serviceName);

  const start = Date.now();
  const response = await fetch(url, { ...options, headers });
  const duration = Date.now() - start;

  // Log with full context
  const logger = new StructuredLogger(ctx);
  logger.info("outgoing_request", {
    url,
    method: options.method || "GET",
    statusCode: response.status,
    durationMs: duration,
  });

  return response;
}

// Query workflow: metric spike → traces → logs
// 1. Alert: checkout.errors.total spike at 14:32
// 2. Query traces: find all traces with error status between 14:30-14:35
// 3. Identify pattern: all errors come from payment-service
// 4. Query logs: filter by traceId of failed requests
// 5. Root cause: payment gateway returning 503 due to certificate expiry
SLOs als Observability-Verträge
Service Level Objectives (SLOs) verwandeln Observability-Daten in handlungsleitende Verträge. Statt auf jeden einzelnen Fehler zu reagieren, legst du akzeptable Fehlerbudgets fest und priorisierst die Entwicklungsarbeit anhand der Burn Rate des Budgets.
interface SLO {
  name: string;
  target: number;           // e.g., 0.999 for 99.9%
  window: "7d" | "28d";
  indicator: SLI;
}

interface SLI {
  good: string;    // Query for successful events
  total: string;   // Query for all events
}

const checkoutSLO: SLO = {
  name: "Checkout Success Rate",
  target: 0.999,
  window: "28d",
  indicator: {
    good: "sum(checkout_requests_total{status='success'})",
    total: "sum(checkout_requests_total)",
  },
};

function calculateErrorBudget(
  slo: SLO,
  currentGoodEvents: number,
  currentTotalEvents: number
): {
  budgetTotal: number;
  budgetConsumed: number;
  budgetRemaining: number;
  burnRate: number;
} {
  const allowedFailureRate = 1 - slo.target;
  const budgetTotal = currentTotalEvents * allowedFailureRate;
  const actualFailures = currentTotalEvents - currentGoodEvents;
  const budgetConsumed = actualFailures;

  return {
    budgetTotal: Math.floor(budgetTotal),
    budgetConsumed,
    budgetRemaining: Math.floor(budgetTotal - budgetConsumed),
    burnRate: budgetConsumed / budgetTotal,
  };
}
Die wichtigsten Erkenntnisse
Observability ist nichts, was man nach dem Launch nachrüstet – es ist eine Design-Disziplin, die vor der ersten Zeile Anwendungscode beginnt. Strukturiere deine Logs von Tag eins an mit typisierten Feldern und Correlation-IDs. Instrumentiere verteilte Traces an den Service-Grenzen, damit du jede Anfrage durch das gesamte System verfolgen kannst. Erfasse RED-Metriken für Services und USE-Metriken für Ressourcen.
Die Korrelationsschicht ist das, was aus drei getrennten Datenströmen einen einzigen Debugging-Workflow macht: Eine Anomalie in einer Metrik führt zu bestimmten Traces, die zu bestimmten Logs führen, die die Grundursache aufdecken. Ohne Korrelation hast du drei Werkzeuge, von denen jedes nur einen Teil der Geschichte erzählt. Mit ihr hast du ein System, das die ganze Geschichte erzählt.
Definiere SLOs frühzeitig. Sie verwandeln Observability-Daten in Priorisierungsentscheidungen: Wenn das Fehlerbudget gesund ist, lieferst du neue Features aus; wenn es schnell aufgebraucht wird, kümmerst du dich um die Zuverlässigkeit. Dieses einfache Framework verhindert, dass Teams zwischen "alle Fehler ignorieren" und "bei jedem Alert alles stehen und liegen lassen" hin- und herpendeln.