Pool de conexiones: por qué todo backend lo necesita
Abrir una conexión nueva por cada petición es un asesino silencioso del rendimiento: los pools lo resuelven con conexiones reutilizables y gestionadas.
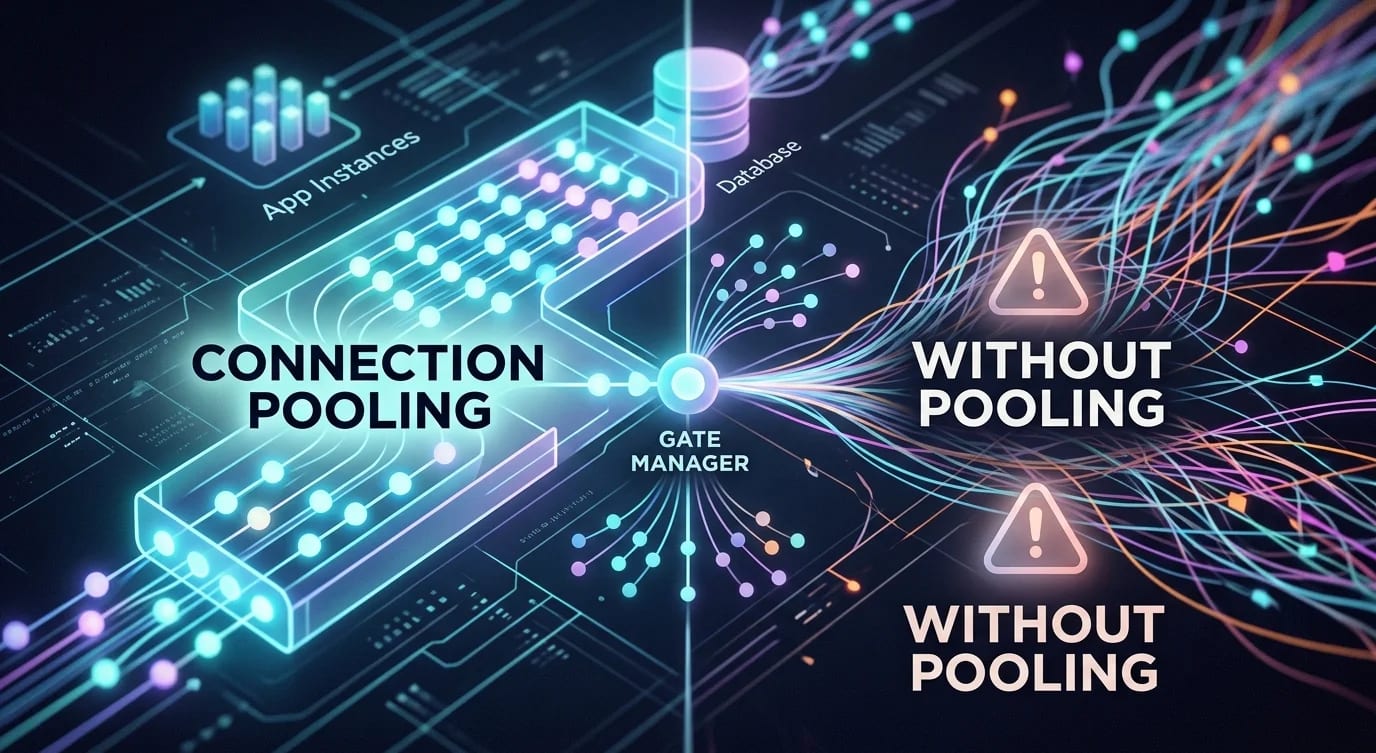
Cada consulta a la base de datos comienza con una conexión. Abrir una conexión TCP, realizar el handshake TLS y autenticarse con la base de datos toma entre 20 y 100 ms. Si haces eso en cada petición, habrás añadido una latencia que eclipsa el tiempo real de la consulta. El pooling de conexiones elimina esta sobrecarga manteniendo un conjunto de conexiones listas para usar.
El coste de una conexión por petición
Sin pooling, cada petición abre una conexión nueva, ejecuta la consulta y cierra la conexión. Bajo carga, este patrón colapsa.
// ❌ New connection per request — 50ms overhead before any query runs
app.get("/api/users/:id", async (req, res) => {
  const client = new Client({ connectionString: process.env.DATABASE_URL });
  await client.connect(); // TCP + TLS + auth = 20-100ms

  const result = await client.query("SELECT * FROM users WHERE id = $1", [
    req.params.id,
  ]);

  await client.end();
  res.json(result.rows[0]);
});

// At 100 concurrent requests:
// - 100 simultaneous TCP connections being established
// - Database may hit max_connections limit (default: 100 in PostgreSQL)
// - Connection establishment becomes the bottleneck// ✅ Connection pool — connections are reused across requests
import { Pool } from "pg";
const pool = new Pool({
connectionString: process.env.DATABASE_URL,
max: 20, // Maximum connections in pool
idleTimeoutMillis: 30000,
connectionTimeoutMillis: 5000,
});
app.get("/api/users/:id", async (req, res) => {
const result = await pool.query("SELECT * FROM users WHERE id = $1", [
req.params.id,
]);
res.json(result.rows[0]);
// Connection automatically returned to pool
});El pool mantiene 20 conexiones calientes. Cuando una petición necesita una conexión a la base de datos, toma una prestada del pool (en menos de un milisegundo). Al terminar, la conexión vuelve al pool para la siguiente petición.
Dimensionamiento del pool
El tamaño óptimo del pool no es "cuantos más, mejor". Demasiadas conexiones desperdician recursos de la base de datos y, de hecho, pueden reducir el rendimiento.
// Pool sizing formula (Brian Hillis' connection pool sizing)
// connections = (core_count * 2) + effective_spindle_count
// For SSDs: connections = (core_count * 2) + 1

// Example: 4-core database server with SSD
// Optimal: (4 * 2) + 1 = 9 connections

// But application-side pools are per-instance!
// 3 app instances × 20 connections each = 60 total to the database
// PostgreSQL default max_connections = 100| Parámetro del pool | Recomendación | Por qué |
|---|---|---|
max | 10-20 por instancia de la aplicación | Más conexiones ≠ más rendimiento |
min | 2-5 | Mantiene conexiones calientes listas |
idleTimeoutMillis | 30,000 | Cierra las conexiones sin usar tras 30 s |
connectionTimeoutMillis | 5,000 | Falla rápido si el pool está agotado |
Agotamiento de conexiones
Cuando todas las conexiones del pool están en uso y llega una nueva petición, esta espera a que una conexión quede disponible. Si el timeout expira, la petición falla.
// Detecting connection exhaustion
pool.on("error", (err) => {
  console.error("Unexpected pool error:", err.message);
});

// Monitor pool statistics
setInterval(() => {
  console.log({
    total: pool.totalCount,
    idle: pool.idleCount,
    waiting: pool.waitingCount, // Requests waiting for a connection
  });

  if (pool.waitingCount > 0) {
    console.warn("Connection pool exhaustion — requests are waiting");
  }
}, 10000);// ❌ Common cause: forgetting to release connections
app.get("/api/data", async (req, res) => {
const client = await pool.connect();
const result = await client.query("SELECT * FROM data");
res.json(result.rows);
// BUG: client.release() never called — connection leaked!
});
// ✅ Always release, even on error
app.get("/api/data", async (req, res) => {
const client = await pool.connect();
try {
const result = await client.query("SELECT * FROM data");
res.json(result.rows);
} finally {
client.release(); // Always release back to pool
}
});
// ✅ Even better: use pool.query() which handles release automatically
app.get("/api/data", async (req, res) => {
const result = await pool.query("SELECT * FROM data");
res.json(result.rows);
});Poolers de conexiones externos
Para aplicaciones con muchas instancias (serverless, Kubernetes), un pooler de conexiones separado como PgBouncer se sitúa entre la aplicación y la base de datos.
App Instance 1 (20 connections) ─┐
App Instance 2 (20 connections) ─┼─→ PgBouncer (100 client connections → 20 server connections) → PostgreSQL
App Instance 3 (20 connections) ─┘
# pgbouncer.ini
[databases]
myapp = host=db.internal port=5432 dbname=myapp

[pgbouncer]
pool_mode = transaction    # Connection returned after each transaction
max_client_conn = 1000     # Client-side connections
default_pool_size = 20     # Server-side connections per database
El pooling a nivel de transacción (pool_mode = transaction) maximiza la reutilización de conexiones: una conexión de servidor solo se retiene durante la transacción, no durante toda la sesión del cliente.
Consideraciones para serverless
Las funciones serverless (Lambda, Vercel Functions) crean un proceso nuevo por invocación, o reutilizan un contenedor caliente. Cada contenedor caliente mantiene su propio pool de conexiones.
// ❌ Creating a pool inside the handler — new pool per invocation
export async function handler(event: APIGatewayEvent) {
  const pool = new Pool({ max: 5 }); // Created every time!
  const result = await pool.query("SELECT 1");
  return { statusCode: 200, body: JSON.stringify(result.rows) };
}

// ✅ Pool outside the handler — reused across warm invocations
const pool = new Pool({
  connectionString: process.env.DATABASE_URL,
  max: 1, // Serverless: keep pool small per instance
});

export async function handler(event: APIGatewayEvent) {
  const result = await pool.query("SELECT 1");
  return { statusCode: 200, body: JSON.stringify(result.rows) };
}
Con serverless, usa un pooler externo (PgBouncer, el pooler de conexiones de Neon, el pgbouncer de Supabase). Cientos de instancias de Lambda creando sus propias conexiones saturarán la base de datos.
Puntos clave
- Usa siempre pools de conexiones — las conexiones por petición añaden entre 20 y 100 ms de sobrecarga y agotan los límites de la base de datos
- El tamaño del pool no es "cuanto más grande, mejor" — entre 10 y 20 por instancia suele ser lo óptimo
- Monitoriza
waitingCount— si hay peticiones esperando conexiones, tienes un cuello de botella - Libera siempre las conexiones — las conexiones fugadas agotan el pool y provocan fallos en cascada
- Usa poolers externos (PgBouncer) cuando ejecutes varias instancias de la aplicación o funciones serverless


