Connection Pooling: Warum jedes Backend es braucht
Für jede Anfrage eine neue Datenbankverbindung zu öffnen ist ein stiller Performance-Killer — Connection Pools lösen das mit wiederverwendbaren Verbindungen.
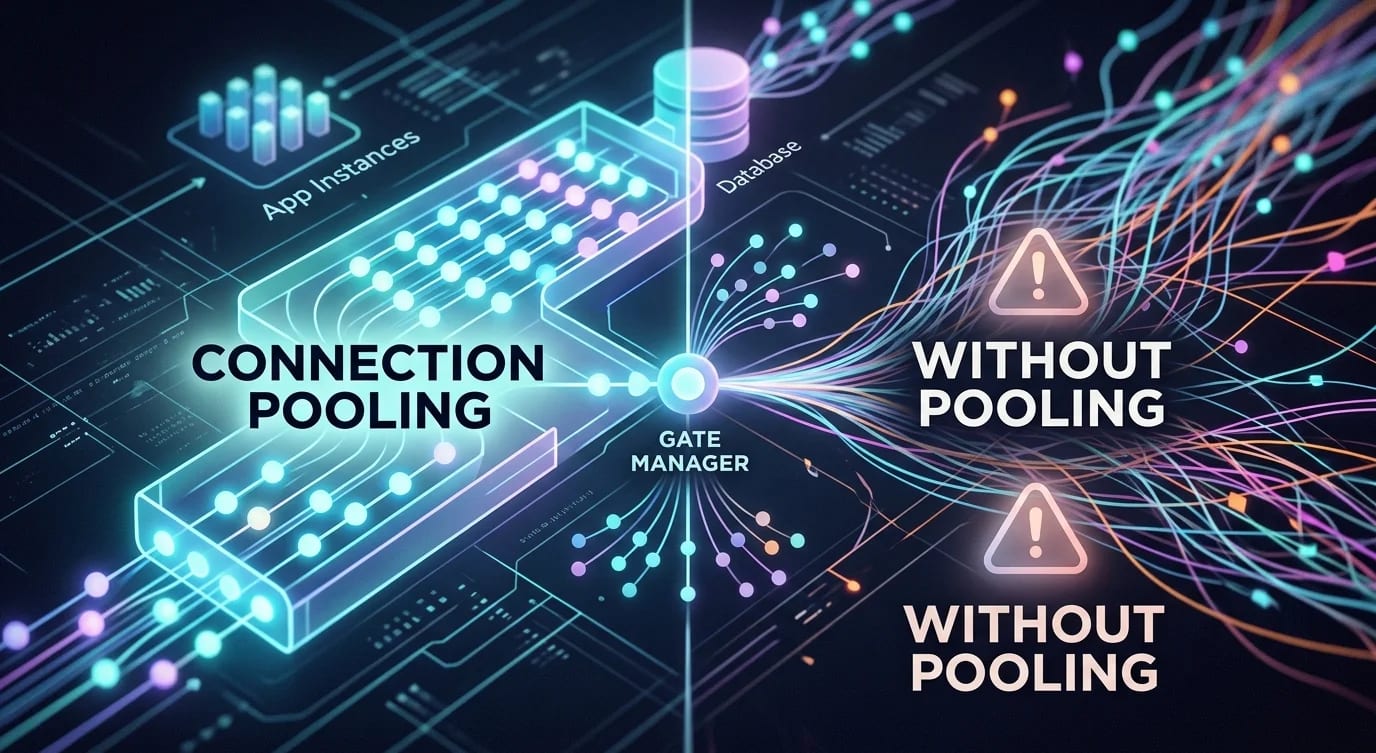
Jede Datenbankabfrage beginnt mit einer Verbindung. Eine TCP-Verbindung aufzubauen, den TLS-Handshake durchzuführen und sich bei der Datenbank zu authentifizieren dauert 20–100 ms. Wenn du das bei jeder Anfrage machst, entsteht eine Latenz, die die eigentliche Abfragezeit bei Weitem übersteigt. Connection Pooling beseitigt diesen Overhead, indem es einen Satz einsatzbereiter Verbindungen vorhält.
Die Kosten von Connection-per-Request
Ohne Pooling öffnet jede Anfrage eine neue Verbindung, führt die Abfrage aus und schließt die Verbindung wieder. Unter Last bricht dieses Muster zusammen.
// ❌ New connection per request — 50ms overhead before any query runs
app.get("/api/users/:id", async (req, res) => {
  const client = new Client({ connectionString: process.env.DATABASE_URL });
  await client.connect(); // TCP + TLS + auth = 20-100ms

  const result = await client.query("SELECT * FROM users WHERE id = $1", [
    req.params.id,
  ]);

  await client.end();
  res.json(result.rows[0]);
});

// At 100 concurrent requests:
// - 100 simultaneous TCP connections being established
// - Database may hit max_connections limit (default: 100 in PostgreSQL)
// - Connection establishment becomes the bottleneck// ✅ Connection pool — connections are reused across requests
import { Pool } from "pg";
const pool = new Pool({
connectionString: process.env.DATABASE_URL,
max: 20, // Maximum connections in pool
idleTimeoutMillis: 30000,
connectionTimeoutMillis: 5000,
});
app.get("/api/users/:id", async (req, res) => {
const result = await pool.query("SELECT * FROM users WHERE id = $1", [
req.params.id,
]);
res.json(result.rows[0]);
// Connection automatically returned to pool
});Der Pool hält 20 warme Verbindungen bereit. Wenn eine Anfrage eine Datenbankverbindung braucht, leiht sie sich eine aus dem Pool (unter einer Millisekunde). Danach geht die Verbindung für die nächste Anfrage zurück in den Pool.
Pool-Dimensionierung
Die optimale Pool-Größe ist nicht "so viele wie möglich". Zu viele Verbindungen verschwenden Datenbankressourcen und können den Durchsatz tatsächlich senken.
// Pool sizing formula (Brian Hillis' connection pool sizing)
// connections = (core_count * 2) + effective_spindle_count
// For SSDs: connections = (core_count * 2) + 1

// Example: 4-core database server with SSD
// Optimal: (4 * 2) + 1 = 9 connections

// But application-side pools are per-instance!
// 3 app instances × 20 connections each = 60 total to the database
// PostgreSQL default max_connections = 100| Pool-Parameter | Empfehlung | Warum |
|---|---|---|
max | 10-20 pro App-Instanz | Mehr Verbindungen ≠ mehr Durchsatz |
min | 2-5 | Hält warme Verbindungen bereit |
idleTimeoutMillis | 30,000 | Ungenutzte Verbindungen nach 30 s schließen |
connectionTimeoutMillis | 5,000 | Schnell fehlschlagen, wenn der Pool erschöpft ist |
Verbindungserschöpfung
Wenn alle Pool-Verbindungen belegt sind und eine neue Anfrage eintrifft, wartet sie, bis eine Verbindung frei wird. Läuft der Timeout ab, schlägt die Anfrage fehl.
// Detecting connection exhaustion
pool.on("error", (err) => {
  console.error("Unexpected pool error:", err.message);
});

// Monitor pool statistics
setInterval(() => {
  console.log({
    total: pool.totalCount,
    idle: pool.idleCount,
    waiting: pool.waitingCount, // Requests waiting for a connection
  });

  if (pool.waitingCount > 0) {
    console.warn("Connection pool exhaustion — requests are waiting");
  }
}, 10000);// ❌ Common cause: forgetting to release connections
app.get("/api/data", async (req, res) => {
const client = await pool.connect();
const result = await client.query("SELECT * FROM data");
res.json(result.rows);
// BUG: client.release() never called — connection leaked!
});
// ✅ Always release, even on error
app.get("/api/data", async (req, res) => {
const client = await pool.connect();
try {
const result = await client.query("SELECT * FROM data");
res.json(result.rows);
} finally {
client.release(); // Always release back to pool
}
});
// ✅ Even better: use pool.query() which handles release automatically
app.get("/api/data", async (req, res) => {
const result = await pool.query("SELECT * FROM data");
res.json(result.rows);
});Externe Connection Pooler
Bei Anwendungen mit vielen Instanzen (Serverless, Kubernetes) sitzt ein separater Connection Pooler wie PgBouncer zwischen Anwendung und Datenbank.
App Instance 1 (20 connections) ─┐
App Instance 2 (20 connections) ─┼─→ PgBouncer (100 client connections → 20 server connections) → PostgreSQL
App Instance 3 (20 connections) ─┘
# pgbouncer.ini
[databases]
myapp = host=db.internal port=5432 dbname=myapp

[pgbouncer]
pool_mode = transaction    # Connection returned after each transaction
max_client_conn = 1000     # Client-side connections
default_pool_size = 20     # Server-side connections per database
Transaktionsbasiertes Pooling (pool_mode = transaction) maximiert die Wiederverwendung von Verbindungen: Eine Serververbindung wird nur für die Dauer einer Transaktion gehalten, nicht für die gesamte Client-Sitzung.
Überlegungen zu Serverless
Serverless-Funktionen (Lambda, Vercel Functions) erzeugen pro Aufruf einen neuen Prozess — oder nutzen einen warmen Container wieder. Jeder warme Container unterhält seinen eigenen Connection Pool.
// ❌ Creating a pool inside the handler — new pool per invocation
export async function handler(event: APIGatewayEvent) {
  const pool = new Pool({ max: 5 }); // Created every time!
  const result = await pool.query("SELECT 1");
  return { statusCode: 200, body: JSON.stringify(result.rows) };
}

// ✅ Pool outside the handler — reused across warm invocations
const pool = new Pool({
  connectionString: process.env.DATABASE_URL,
  max: 1, // Serverless: keep pool small per instance
});

export async function handler(event: APIGatewayEvent) {
  const result = await pool.query("SELECT 1");
  return { statusCode: 200, body: JSON.stringify(result.rows) };
}
Nutze bei Serverless einen externen Pooler (PgBouncer, Neons Connection Pooler, Supabase' PgBouncer). Hunderte Lambda-Instanzen, die jeweils eigene Verbindungen aufbauen, überlasten die Datenbank.
Die wichtigsten Erkenntnisse
- Nutze immer Connection Pools — Verbindungen pro Anfrage verursachen 20–100 ms Overhead und erschöpfen die Limits der Datenbank
- Pool-Größe heißt nicht "größer ist besser" — 10–20 pro Instanz ist meist optimal
- Überwache
waitingCount— wenn Anfragen auf Verbindungen warten, hast du einen Engpass - Gib Verbindungen immer frei — geleakte Verbindungen erschöpfen den Pool und verursachen kaskadierende Fehler
- Nutze externe Pooler (PgBouncer), wenn du mehrere App-Instanzen oder Serverless-Funktionen betreibst


