Por qué SQLite merece un lugar en tu stack de backend
Con modo WAL y la estrategia de réplica correcta, SQLite corre cargas de producción con menos overhead operativo que Postgres.
Cada revisión de arquitectura de backend en la que he participado durante la última década empieza con la misma suposición: necesitas una base de datos cliente-servidor. Postgres o MySQL, un connection pool, una instancia administrada, quizás una réplica de lectura más adelante. SQLite se menciona una vez, normalmente para descartarlo con un "está bien para una app móvil, no para producción". Esa suposición está desactualizada. Para una buena parte de las aplicaciones reales —APIs con mucha lectura, herramientas internas, SaaS de un solo tenant, servicios desplegados en el edge— un único archivo SQLite con la configuración correcta supera a una instancia administrada de Postgres en latencia, costo y simplicidad operativa.
Esto no es un alegato de que SQLite reemplaza a Postgres en todos lados. Es un alegato de que la mayoría de los equipos recurren a una base de datos en red por defecto, sin preguntarse si la carga de trabajo realmente la necesita.
El modelo de concurrencia que la gente malinterpreta
La objeción estándar es "SQLite no soporta escrituras concurrentes". Eso es cierto en el modo por defecto, el rollback journal, donde un escritor bloquea el archivo completo de la base de datos. Es prácticamente falso una vez que activas Write-Ahead Logging, descrito en detalle en la documentación de SQLite sobre WAL. En modo WAL, los lectores no bloquean a los escritores ni viceversa — solo queda la contención escritor contra escritor, que para la mayoría de las aplicaciones es tan infrecuente que un busy timeout corto la resuelve sin problemas.
-- ❌ default mode: readers and writers block each other
-- (no pragma set, SQLite uses rollback journal)

-- ✅ production configuration for a single-writer web service
PRAGMA journal_mode = WAL;
PRAGMA synchronous = NORMAL;
PRAGMA busy_timeout = 5000;
PRAGMA foreign_keys = ON;
PRAGMA cache_size = -64000; -- 64MB page cache
synchronous = NORMAL es el detalle que la gente se salta y luego lamenta en el sentido contrario — FULL es más seguro ante un corte de energía, pero agrega un fsync en cada commit de transacción, que es el mayor costo de latencia en SQLite. NORMAL combinado con WAL sigue garantizando durabilidad ante caídas de la aplicación; lo único que sacrifica es el escenario (raro, y normalmente irrelevante en un despliegue sobre VM) de que el sistema operativo se caiga justo en el peor momento.
Manejo de conexiones: un escritor, no un pool
El cambio de modelo mental que suele confundir a quienes vienen de Postgres es el connection pooling. Aquí no hay un round trip de red que amortizar, así que usar un pool de una docena de conexiones hacia el mismo archivo no aporta nada — en la práctica solo agrega contención de locks.
// ❌ treating SQLite like a networked database
import Database from "better-sqlite3";

const pool = Array.from({ length: 10 }, () => new Database("app.db"));
function getConnection() {
  return pool[Math.floor(Math.random() * pool.length)];
}

// ✅ one long-lived connection per process, WAL enabled
import Database from "better-sqlite3";

const db = new Database("app.db");
db.pragma("journal_mode = WAL");
db.pragma("busy_timeout = 5000");

export function getOrder(id: string) {
  const stmt = db.prepare("SELECT * FROM orders WHERE id = ?");
  return stmt.get(id);
}

export function createOrder(order: { id: string; total: number }) {
  const stmt = db.prepare(
    "INSERT INTO orders (id, total) VALUES (@id, @total)"
  );
  stmt.run(order);
}
better-sqlite3 es síncrono por diseño, lo cual suena alarmante hasta que te das cuenta de que las lecturas de SQLite y las escrituras en disco local son más rápidas que el overhead del event loop de un driver asíncrono para la mayoría de las consultas — no hay espera de I/O sobre la cual ceder el control. Los prepared statements se cachean automáticamente, y al haber una sola conexión, no existe el modo de falla por agotamiento del pool que haya que monitorear.
Durabilidad sin un segundo servidor
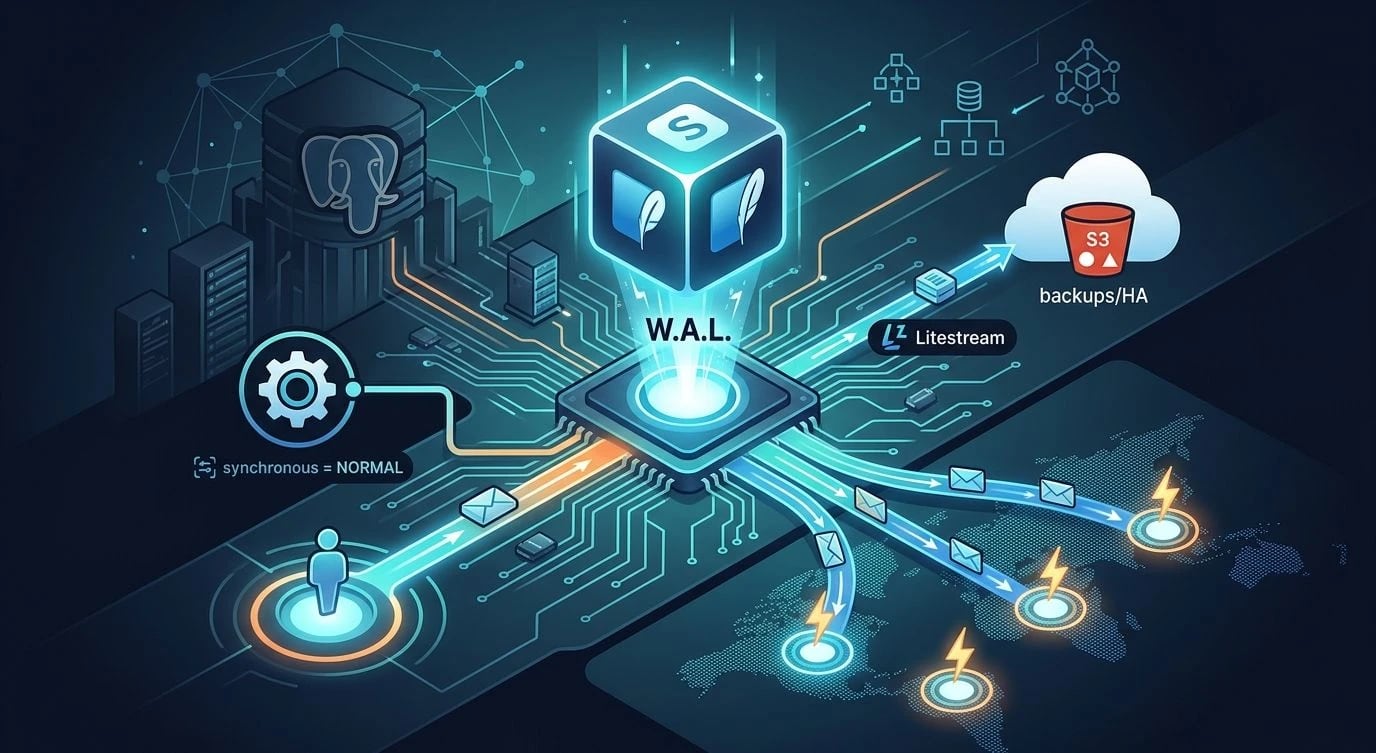
El argumento operativo en contra de SQLite siempre ha sido el de backups y alta disponibilidad — un solo archivo es un único punto de falla. Litestream resuelve esto transmitiendo el archivo WAL de forma continua a almacenamiento de objetos compatible con S3, dándote recuperación a un punto en el tiempo sin tener que correr una base de datos réplica.
# litestream.yml
dbs:
  - path: /data/app.db
    replicas:
      - type: s3
        bucket: app-backups
        path: db
        region: us-east-1
        sync-interval: 1s
        retention: 72h
Restaurar es un solo comando en una instancia nueva, lo que convierte "se murió el disco" en un no-evento en lugar de un incidente:
litestream restore -o /data/app.db s3://app-backups/dbEste patrón —un solo escritor, streaming continuo del WAL, almacenamiento de objetos barato para la retención— te da la mayor parte de lo que ofrece una instancia administrada de Postgres con backups automáticos, a una fracción del costo y con tiempos de recuperación medidos en segundos para bases de datos de pocos gigabytes.
Dónde realmente se cae
Ser honesto sobre el techo importa más que vender el patrón. SQLite es la opción equivocada cuando:
| Requisito | Por qué SQLite sufre |
|---|---|
| Múltiples servidores de app escribiendo de forma concurrente | El lock de escritor único serializa todas las escrituras globalmente |
| El dataset excede por mucho el disco/RAM disponible | No tiene sharding ni particionado nativo |
| Consultas analíticas pesadas junto con OLTP | No hay ejecución paralela de consultas |
Necesidad de locking a nivel de fila con SELECT ... FOR UPDATE | SQLite bloquea a nivel de base de datos/tabla, no de fila |
Si tu requisito de throughput de escritura es "cada instancia del servidor de app escribe de forma independiente", SQLite no es la herramienta correcta — enruta las escrituras a través de un único proceso (un consumidor de cola, un servicio de escritura dedicado) o usa una base de datos en red en su lugar.
Esa restricción de escritor único es el verdadero techo, no el tamaño del archivo. La propia documentación de SQLite sobre usos apropiados para SQLite es inusualmente franca al respecto — está escrita por los mantenedores del proyecto, no por un vendor que te quiere vender algo, lo que la hace recomendable leer antes de comprometerte con el patrón.
El despliegue en el edge cambia aún más la ecuación
El patrón que hace a SQLite genuinamente atractivo para arquitecturas de la era 2026 es la replicación en el edge. Servicios como Turso (construido sobre libsql, un fork de SQLite) y Cloudflare D1 replican una base de datos SQLite a decenas de regiones, dándote lecturas de un solo dígito de milisegundos desde donde sea que se origine la solicitud — algo que una instancia centralizada de Postgres simplemente no puede lograr sin una capa de caché dedicada delante.
// edge read replica, local to the region handling the request
import { createClient } from "@libsql/client";

const client = createClient({
  url: "libsql://app-prod-myorg.turso.io",
  authToken: process.env.TURSO_AUTH_TOKEN,
});

async function getProductCatalog(region: string) {
  const result = await client.execute({
    sql: "SELECT * FROM products WHERE region = ?",
    args: [region],
  });
  return result.rows;
}
Las escrituras siguen canalizándose hacia un nodo primario, pero las lecturas —que dominan la mayoría de catálogos de productos, APIs de contenido y servicios de configuración— ocurren localmente. Es el mismo patrón de réplica de lectura que los equipos construyen manualmente con Postgres, solo que aquí la replicación y el enrutamiento los maneja la plataforma en lugar de tu equipo de infraestructura.
Puntos clave
- Activa el modo WAL y configura
synchronous = NORMALantes de juzgar el rendimiento de escritura de SQLite — los valores por defecto priorizan seguridad sobre throughput. - Usa una única conexión de larga duración por proceso en lugar de un connection pool; agrupar conexiones hacia un archivo local solo agrega contención sin beneficio.
- Litestream (o un backup equivalente por streaming de WAL) te da durabilidad y recuperación a un punto en el tiempo sin correr un segundo servidor de base de datos.
- El verdadero techo son las escrituras concurrentes multi-proceso, no el tamaño del dataset — enruta las escrituras por un solo proceso si necesitas escalado horizontal de escritura.
- Las plataformas de SQLite en el edge (Turso, Cloudflare D1) resuelven la latencia de lectura a nivel de red de una forma que Postgres centralizado no puede igualar sin infraestructura de caché adicional.
- Recurre a una base de datos en red cuando necesites locking a nivel de fila, analítica pesada o concurrencia real multi-escritor — pero no lo hagas por costumbre cuando un solo archivo bastaría.