Warum SQLite einen Platz im Backend-Stack verdient
SQLite ist nicht nur für Mobile-Apps: Mit WAL-Modus und passender Replikationsstrategie läuft es produktiv mit weniger Aufwand als Postgres.
Jede Backend-Architektur-Review, bei der ich in den letzten zehn Jahren saß, startete mit derselben Annahme: Man braucht eine Client-Server-Datenbank. Postgres oder MySQL, einen Connection-Pool, eine Managed Instance, später vielleicht eine Read-Replica. SQLite wird höchstens einmal erwähnt, meist um es gleich abzutun: "Für eine Mobile-App okay, aber nichts für Produktion." Diese Annahme ist veraltet. Für einen großen Teil realer Anwendungen — Read-lastige APIs, interne Tools, Single-Tenant-SaaS, Edge-deployte Services — schlägt eine einzige SQLite-Datei mit der richtigen Konfiguration eine Managed-Postgres-Instanz in Sachen Latenz, Kosten und operativer Einfachheit.
Das ist keine Behauptung, SQLite ersetze Postgres überall. Es ist die Behauptung, dass die meisten Teams standardmäßig zu einer vernetzten Datenbank greifen, ohne zu fragen, ob der Workload das überhaupt braucht.
Das Concurrency-Modell, das oft missverstanden wird
Der Standardeinwand lautet: "SQLite kann keine nebenläufigen Writes." Das stimmt im Standard-Rollback-Journal-Modus, in dem ein Writer die gesamte Datenbankdatei sperrt. Sobald Write-Ahead Logging aktiviert ist — ausführlich beschrieben in der SQLite-WAL-Dokumentation — stimmt es größtenteils nicht mehr. Im WAL-Modus blockieren Reader keine Writer und Writer keine Reader — es bleibt nur Writer-gegen-Writer-Konkurrenz, die für die meisten Anwendungen selten genug ist, dass ein kurzer Busy-Timeout sie sauber abfängt.
-- ❌ default mode: readers and writers block each other
-- (no pragma set, SQLite uses rollback journal)

-- ✅ production configuration for a single-writer web service
PRAGMA journal_mode = WAL;
PRAGMA synchronous = NORMAL;
PRAGMA busy_timeout = 5000;
PRAGMA foreign_keys = ON;
PRAGMA cache_size = -64000; -- 64MB page cache
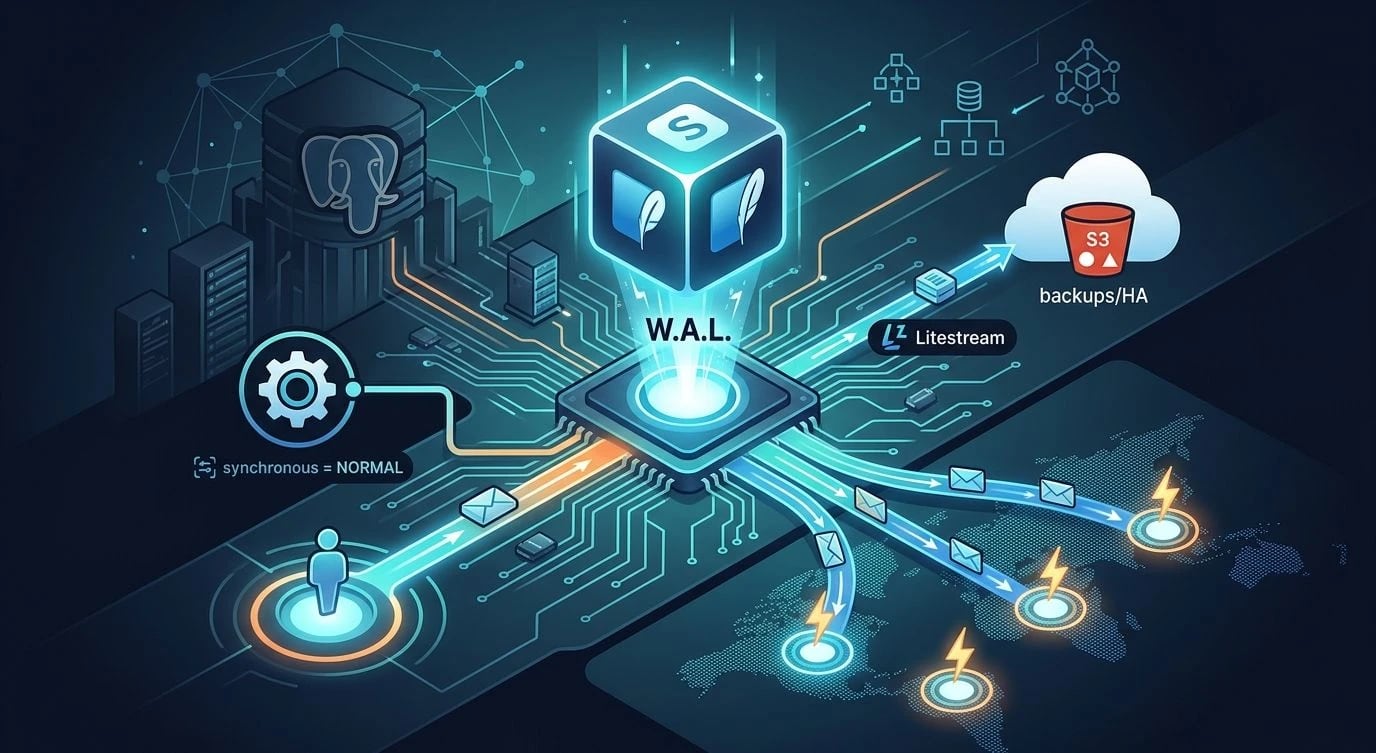
synchronous = NORMAL ist das Detail, das gern übersprungen wird — und dann rächt es sich in die andere Richtung: FULL ist sicherer bei Stromausfall, erzwingt aber bei jedem Transaction-Commit ein fsync, was die größte Latenzkostenquelle in SQLite ist. NORMAL in Kombination mit WAL garantiert weiterhin Durability bei Application-Crashes; es gibt nur den (seltenen, für ein VM-basiertes Deployment meist irrelevanten) Fall eines OS-Crashs genau im falschen Moment auf.
Connection-Handling: ein Writer, kein Pool
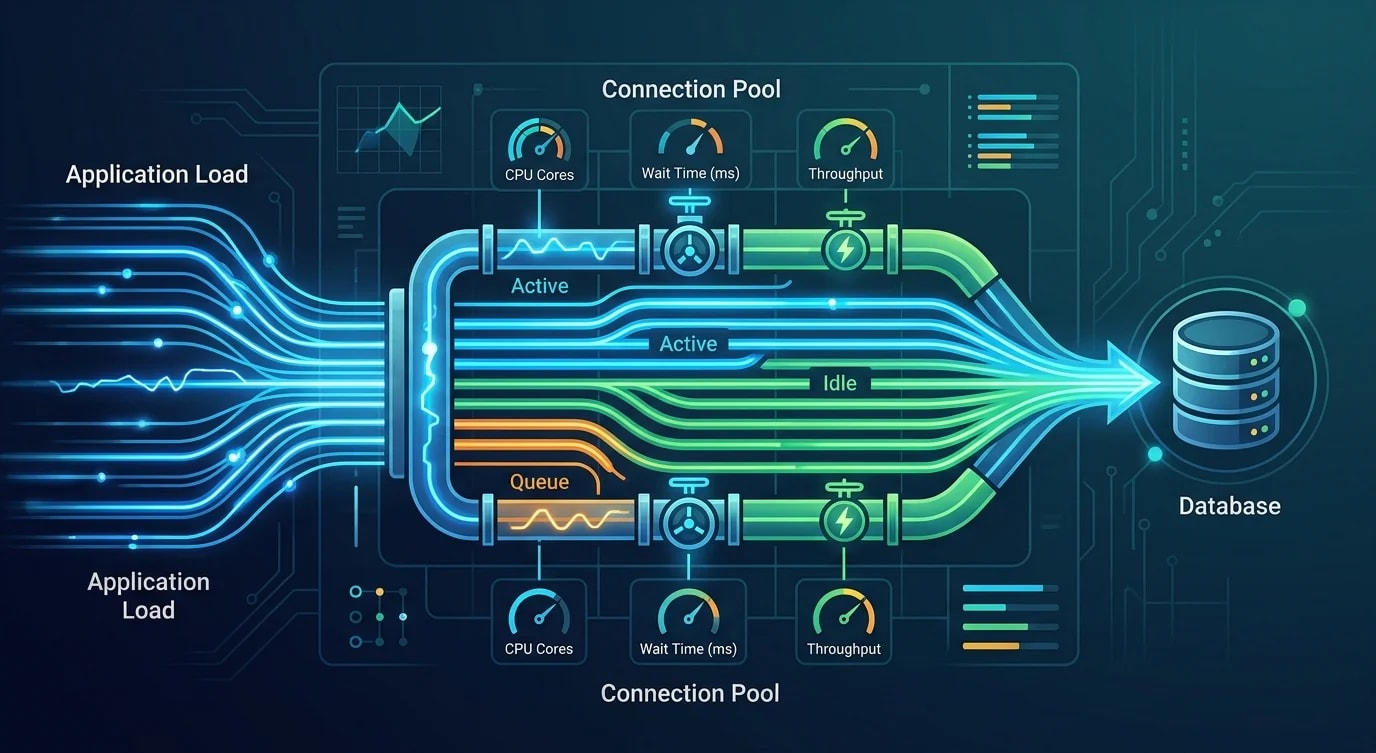
Der mentale Shift, der Engineers aus der Postgres-Welt stolpern lässt, ist Connection-Pooling. Es gibt keinen Netzwerk-Roundtrip, den man amortisieren müsste — ein Dutzend Connections auf dieselbe Datei zu poolen bringt nichts, sondern erzeugt vor allem Lock-Contention.
// ❌ treating SQLite like a networked database
import Database from "better-sqlite3";

const pool = Array.from({ length: 10 }, () => new Database("app.db"));
function getConnection() {
  return pool[Math.floor(Math.random() * pool.length)];
}

// ✅ one long-lived connection per process, WAL enabled
import Database from "better-sqlite3";

const db = new Database("app.db");
db.pragma("journal_mode = WAL");
db.pragma("busy_timeout = 5000");

export function getOrder(id: string) {
  const stmt = db.prepare("SELECT * FROM orders WHERE id = ?");
  return stmt.get(id);
}

export function createOrder(order: { id: string; total: number }) {
  const stmt = db.prepare(
    "INSERT INTO orders (id, total) VALUES (@id, @total)"
  );
  stmt.run(order);
}
better-sqlite3 ist bewusst synchron designt, was erstmal beunruhigend klingt — bis man begreift, dass SQLite-Reads und lokale Disk-Writes für die meisten Queries schneller sind als der Event-Loop-Overhead eines asynchronen Drivers. Es gibt schlicht keinen I/O-Wait, auf den man "yielden" müsste. Prepared Statements werden automatisch gecacht, und weil es nur eine Connection gibt, gibt es auch keinen Pool-Exhaustion-Failure-Mode, den man überwachen müsste.
Durability ohne zweiten Server
Das operative Gegenargument zu SQLite waren immer Backups und High Availability — eine einzelne Datei ist ein Single Point of Failure. Litestream löst das, indem es die WAL-Datei kontinuierlich in S3-kompatiblen Object Storage streamt und so Point-in-Time-Recovery ermöglicht, ohne eine Replica-Datenbank zu betreiben.
# litestream.yml
dbs:
  - path: /data/app.db
    replicas:
      - type: s3
        bucket: app-backups
        path: db
        region: us-east-1
        sync-interval: 1s
        retention: 72h
Restore ist ein einziger Befehl auf einer frischen Instanz — das macht "die Platte ist hin" zum Nicht-Ereignis statt zum Incident:
litestream restore -o /data/app.db s3://app-backups/dbDieses Muster — ein Writer, kontinuierliches WAL-Streaming, günstiger Object Storage für die Retention — liefert das meiste von dem, was eine Managed-Postgres-Instanz mit automatisierten Backups bietet, für einen Bruchteil der Kosten und mit Recovery-Zeiten im Sekundenbereich für Datenbanken unter wenigen Gigabyte.
Wo es ehrlich an seine Grenzen stößt
Ehrlich über die Obergrenze zu sein ist wichtiger, als das Muster schönzureden. SQLite ist die falsche Wahl, wenn:
| Anforderung | Warum SQLite hier schwächelt |
|---|---|
| Mehrere App-Server schreiben gleichzeitig | Single-Writer-Lock serialisiert alle Writes global |
| Datensatz übersteigt verfügbares Disk/RAM deutlich | Kein natives Sharding oder Partitioning |
| Schwere analytische Queries neben OLTP | Keine parallele Query-Ausführung |
Bedarf an SELECT ... FOR UPDATE Row-Locking | SQLite sperrt auf Datenbank-/Tabellenebene, nicht pro Zeile |
Wenn eure Write-Throughput-Anforderung lautet "jede App-Server-Instanz schreibt unabhängig", ist SQLite das falsche Werkzeug — leitet Writes durch einen einzigen Prozess (einen Queue-Consumer, einen dedizierten Write-Service) oder nutzt stattdessen eine vernetzte Datenbank.
Diese Single-Writer-Beschränkung ist die eigentliche Obergrenze, nicht die Dateigröße. SQLites eigene Dokumentation zu geeigneten Einsatzzwecken für SQLite ist in dieser Hinsicht ungewöhnlich offen — geschrieben von den Projekt-Maintainern selbst, nicht von einem Vendor, der euch etwas verkaufen will. Lesenswert, bevor man sich auf das Muster festlegt.
Edge-Deployment verschiebt die Rechnung weiter
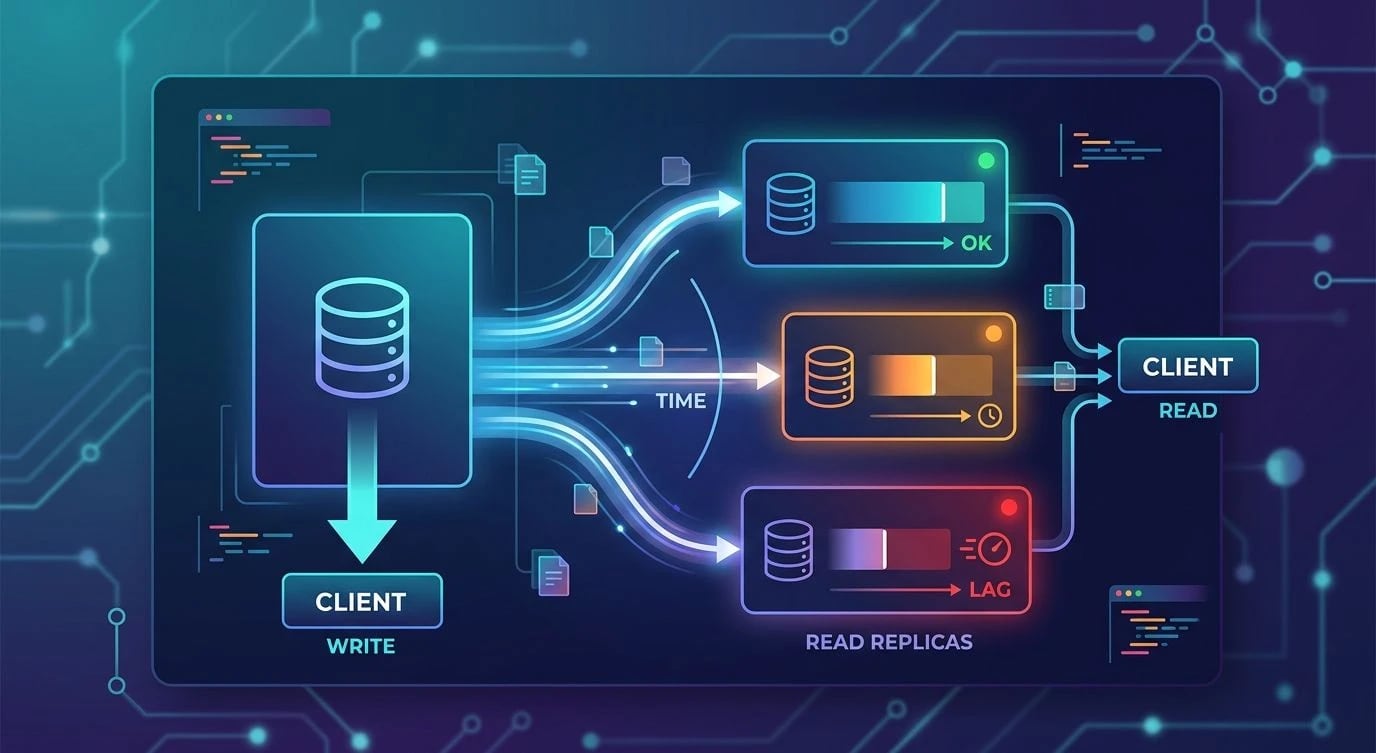
Das Muster, das SQLite für Architekturen im Jahr 2026 wirklich attraktiv macht, ist Edge-Replikation. Dienste wie Turso (basierend auf libsql, einem Fork von SQLite) und Cloudflare D1 replizieren eine SQLite-Datenbank in Dutzende Regionen und liefern Reads im niedrigen einstelligen Millisekundenbereich, egal von wo der Request kommt — etwas, das eine zentrale Postgres-Instanz ohne dedizierte Caching-Schicht davor schlicht nicht kann.
// edge read replica, local to the region handling the request
import { createClient } from "@libsql/client";

const client = createClient({
  url: "libsql://app-prod-myorg.turso.io",
  authToken: process.env.TURSO_AUTH_TOKEN,
});

async function getProductCatalog(region: string) {
  const result = await client.execute({
    sql: "SELECT * FROM products WHERE region = ?",
    args: [region],
  });
  return result.rows;
}
Writes laufen weiterhin über eine Primary-Instanz, aber Reads — die bei den meisten Produktkatalogen, Content-APIs und Configuration-Services dominieren — passieren lokal. Das ist dasselbe Read-Replica-Muster, das Teams bei Postgres manuell bauen, nur dass Replikation und Routing hier von der Plattform übernommen werden statt vom eigenen Infrastruktur-Team.
Key Takeaways
- Aktiviert WAL-Modus und setzt
synchronous = NORMAL, bevor ihr SQLites Write-Performance beurteilt — die Defaults sind auf Sicherheit statt Durchsatz getrimmt. - Nutzt pro Prozess eine einzige langlebige Connection statt eines Connection-Pools; Pooling einer lokalen Dateidatenbank erzeugt nur Contention ohne Nutzen.
- Litestream (oder ein äquivalentes WAL-Streaming-Backup) liefert Durability und Point-in-Time-Recovery, ohne einen zweiten Datenbankserver zu betreiben.
- Die eigentliche Obergrenze sind nebenläufige Multi-Prozess-Writes, nicht die Datensatzgröße — leitet Writes durch einen Prozess, wenn ihr horizontale Write-Skalierung braucht.
- Edge-SQLite-Plattformen (Turso, Cloudflare D1) lösen Read-Latenz auf Netzwerkebene auf eine Weise, die zentrales Postgres ohne zusätzliche Caching-Infrastruktur nicht erreicht.
- Greift standardmäßig zu einer vernetzten Datenbank, wenn ihr Row-Level-Locking, schwere Analytics oder echte Multi-Writer-Nebenläufigkeit braucht — aber nicht aus reiner Gewohnheit, wenn eine einzelne Datei reichen würde.