
Inteligencia Artificial
Evaluar la salida de un LLM: métricas y frameworks de prueba
Guía práctica de pipelines de evaluación para funciones con LLM: similitud semántica, pruebas de comportamiento, regresiones y quality gates.
·5 min de lectura
Etiquetas
17 artículos · Página 1 de 2
Guía práctica de pipelines de evaluación para funciones con LLM: similitud semántica, pruebas de comportamiento, regresiones y quality gates.
Ajusta modelos de lenguaje a tu dominio con LoRA y QLoRA: preparación de datasets, estrategias de entrenamiento y evaluación sin grandes presupuestos.

Construye pipelines RAG eficaces en TypeScript: chunking de documentos, embeddings, ajuste de búsqueda vectorial, prompts y evaluación de la recuperación.
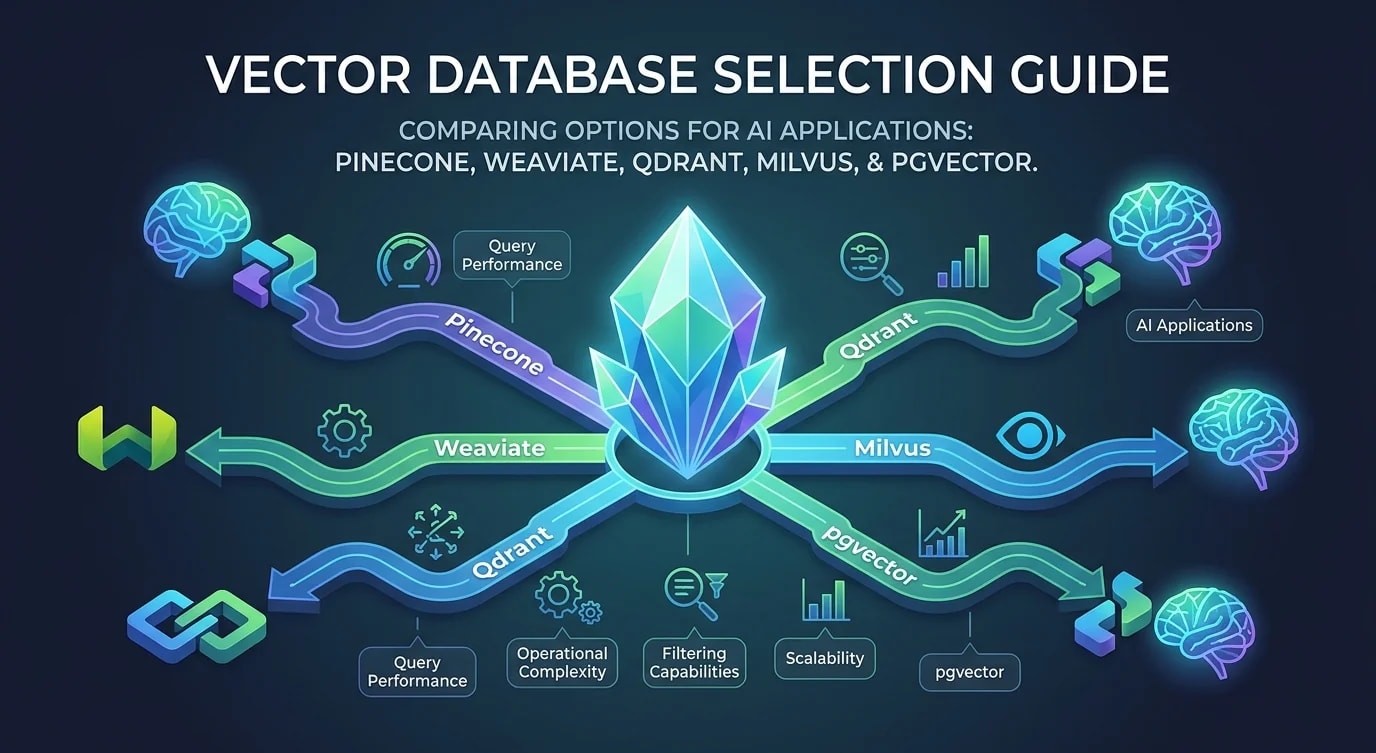
Compara Pinecone, Weaviate, Qdrant, Milvus y pgvector para IA: estrategias de indexación, rendimiento, filtrado y complejidad operativa.
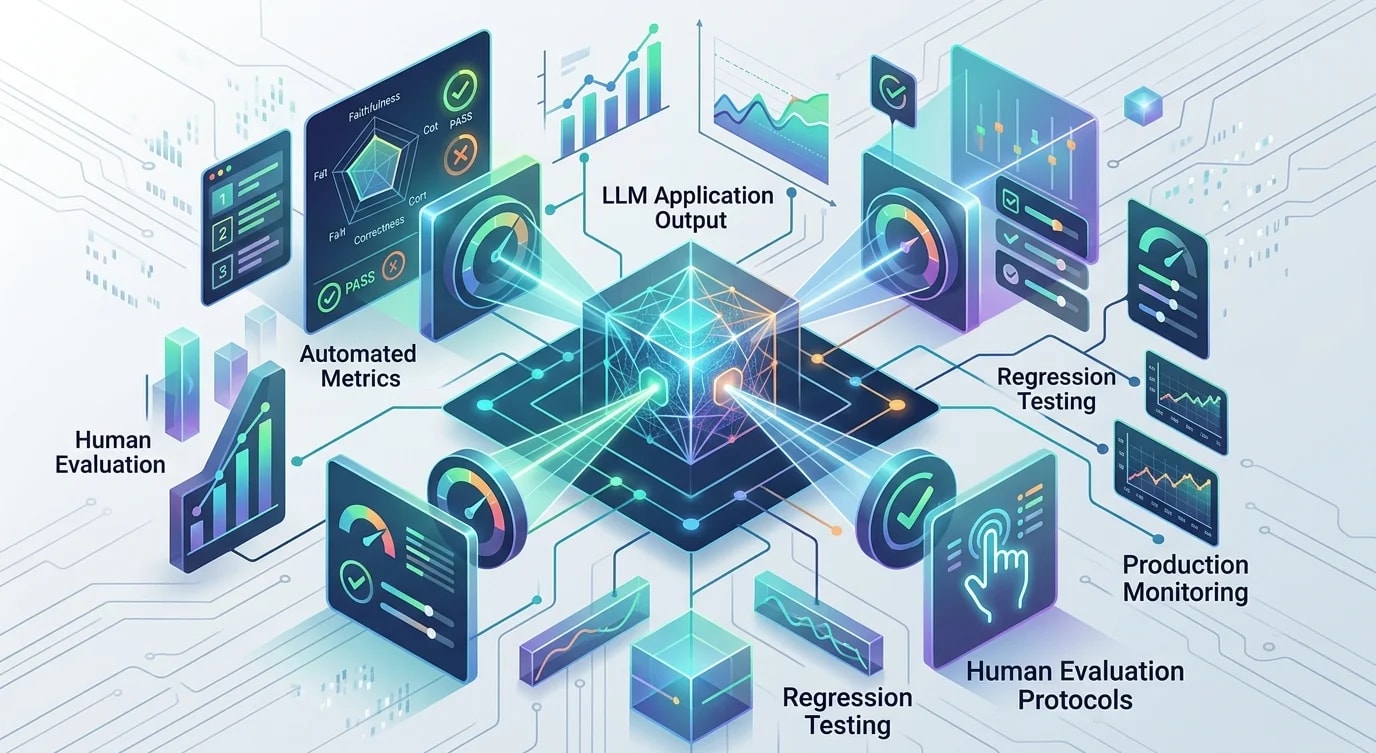
Diseña pipelines de evaluación para aplicaciones con LLM: métricas automáticas, evaluación humana, regresión, versionado de prompts y monitorización.
Guía práctica del ajuste fino de modelos de lenguaje con datos de dominio: datasets, estrategias de entrenamiento, evaluación y despliegue.

Técnicas prácticas para detectar y mitigar el sesgo en pipelines de machine learning, desde los datos hasta el despliegue y el monitoreo del modelo.

Conceptos de federated learning, patrones de implementación y retos prácticos de entrenar modelos en dispositivos distribuidos preservando la privacidad.

Detección de anomalías en métricas de aplicaciones: métodos estadísticos, z-scores, medias móviles, descomposición estacional y alertas sin fatiga.

Guía práctica de bases de datos vectoriales para búsqueda por similitud: embeddings, indexación, métricas de distancia y cuándo elegir cada opción.

Cómo crear pipelines de NLP listos para producción: preprocesamiento, tokenización, embeddings, clasificación y extracción de entidades.

Introducción práctica a los sistemas de recomendación: filtrado colaborativo, basado en contenido e híbrido, con implementaciones en TypeScript.