
Künstliche Intelligenz
LLM-Ausgabequalität bewerten: Metriken und Testframeworks
Praktischer Leitfaden für Evaluations-Pipelines von LLM-Features: semantische Ähnlichkeit, Verhaltenstests, Regressionserkennung, Quality Gates.
·4 Min. Lesezeit
Tags
17 Artikel · Seite 1 von 2
Praktischer Leitfaden für Evaluations-Pipelines von LLM-Features: semantische Ähnlichkeit, Verhaltenstests, Regressionserkennung, Quality Gates.
Feintuning von Sprachmodellen mit LoRA und QLoRA: Datensatzvorbereitung, Trainingsstrategien und Evaluierung — Spezialisten ohne riesiges Compute-Budget.

Baue effektive RAG-Pipelines mit TypeScript: Chunking, Embeddings, Feintuning der Vektorsuche, Prompt-Konstruktion und Evaluation der Retrieval-Qualität.
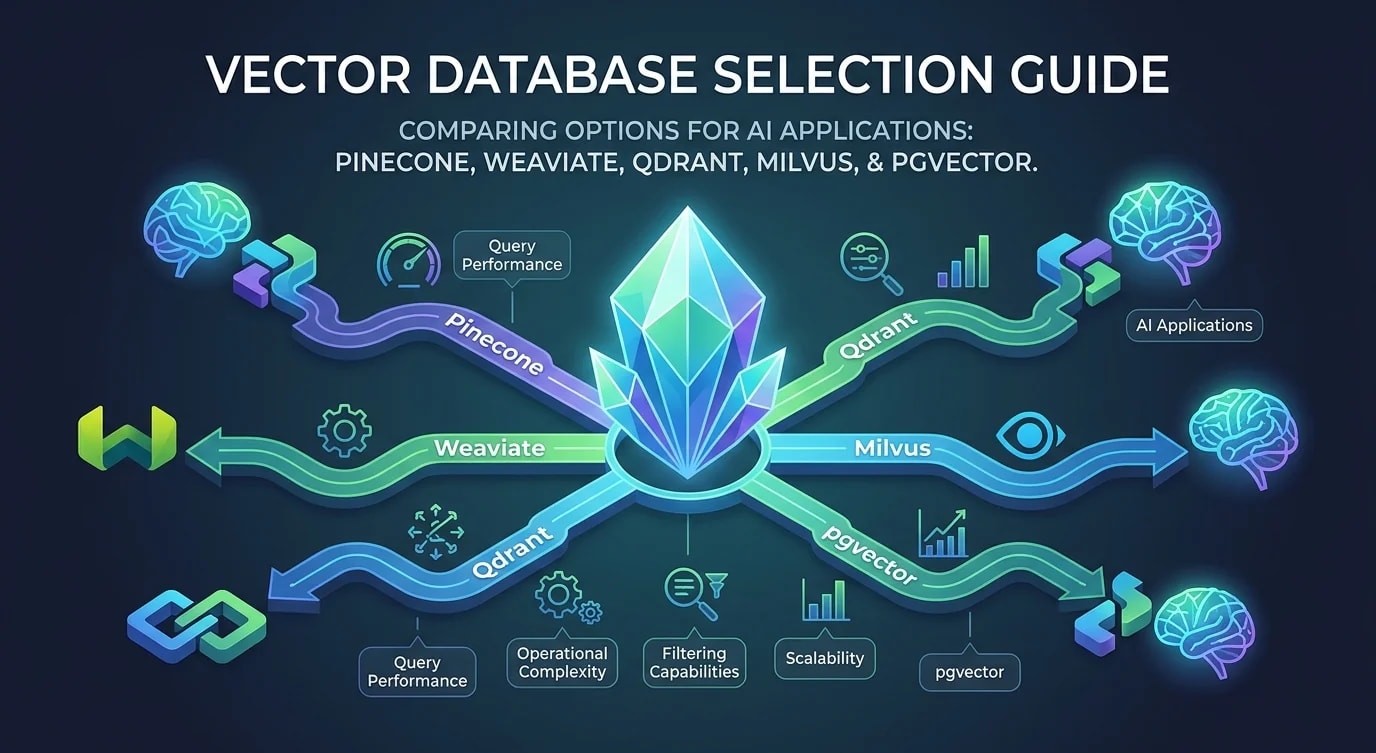
Vergleich von Pinecone, Weaviate, Qdrant, Milvus und pgvector für KI-Anwendungen: Indexierung, Abfrageleistung, Filterung, Betriebskomplexität.
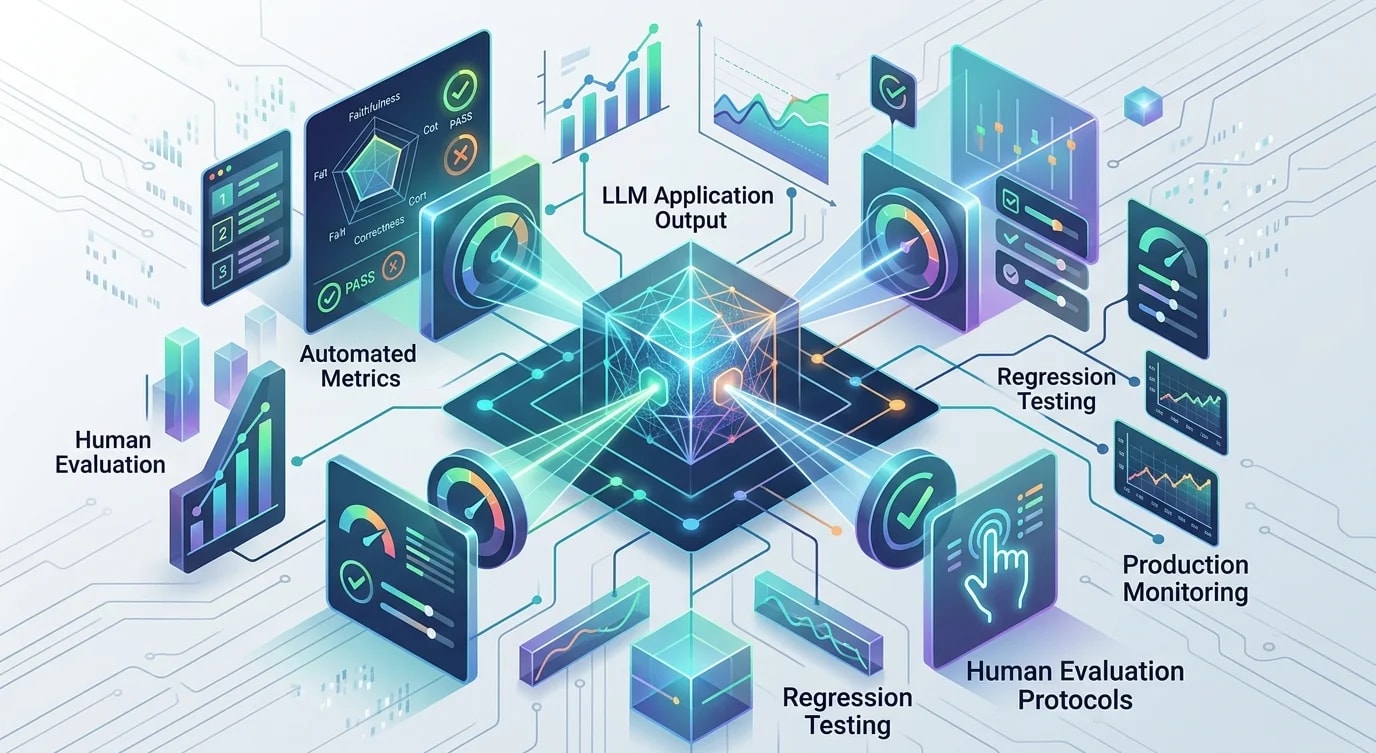
Systematische Evaluierungs-Pipelines für LLM-Anwendungen: automatisierte Metriken, menschliche Bewertung, Regressionstests, Prompt-Versionierung.
Praktischer Leitfaden zum Fine-Tuning von Sprachmodellen auf Domänendaten: Datensätze, Trainingsstrategien, Evaluation und Bereitstellung.

Praktische Techniken zur Erkennung und Minderung von Bias in ML-Pipelines — von der Datenerhebung über das Deployment bis zum Monitoring.

Grundlagen des Federated Learning, Implementierungsmuster und praktische Herausforderungen beim Training auf verteilten Geräten unter Datenschutz.

Anomalieerkennung für Anwendungsmetriken: statistische Methoden, Z-Scores, gleitende Durchschnitte, saisonale Zerlegung und Alarme ohne Alert Fatigue.

Praktischer Leitfaden zu Vektordatenbanken für Ähnlichkeitssuche: Embeddings, Indexierungsstrategien, Distanzmetriken und die Wahl des Systems.

Wie man produktionsreife NLP-Pipelines baut: Textvorverarbeitung, Tokenisierung, Embeddings, Klassifikation und Entitätsextraktion.

Eine praktische Einführung in Empfehlungssysteme: Collaborative Filtering, Content-based Filtering und hybride Ansätze, in TypeScript umgesetzt.