
Engineering
Feature Flags im großen Maßstab: Progressive Delivery
Baue ein Feature-Flag-System mit prozentualen Rollouts, Nutzersegmentierung, A/B-Tests und Kill Switches, das Deployment und Release entkoppelt.
·4 Min. Lesezeit
Kategorien
Software-Handwerk & Praktiken · 55 Artikel · Seite 2 von 5
Baue ein Feature-Flag-System mit prozentualen Rollouts, Nutzersegmentierung, A/B-Tests und Kill Switches, das Deployment und Release entkoppelt.

Praktische Teststrategien für verteilte Architekturen: Contract Testing, Chaos Engineering, Integrationstests und Vertrauen ohne vollständige E2E.

Ein Rahmen für fundierte technische Entscheidungen bei unvollständigen Anforderungen: Reversibilitätsanalyse, Entscheidungsprotokolle, Mehrdeutigkeit.

Verschiebe Observability nach links: strukturierte Logs, verteilte Traces und aussagekräftige Metriken von Anfang an — schnelleres Debugging.
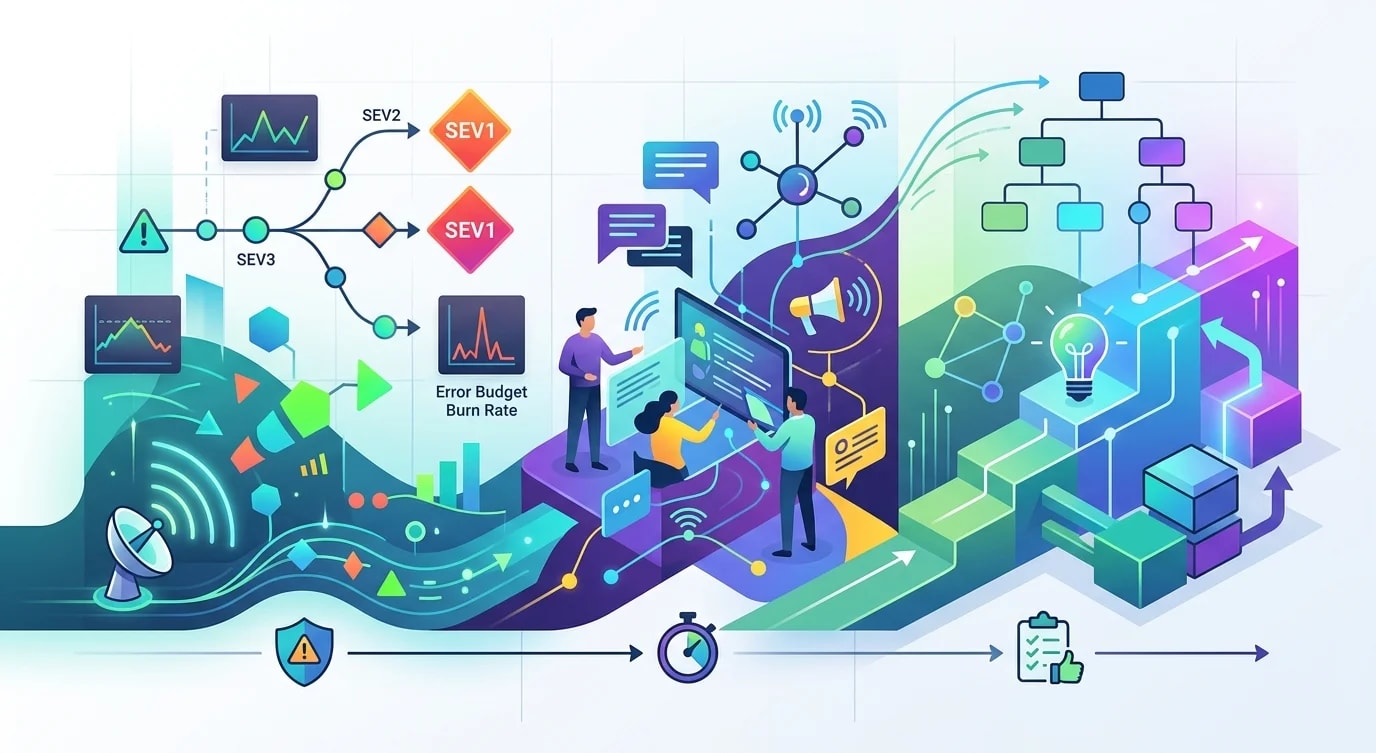
Ein systematischer Ansatz für Incident Management: Alert-Design, Schweregrade, On-Call-Workflows, Kommunikation und schuldfreie Post-Mortems.
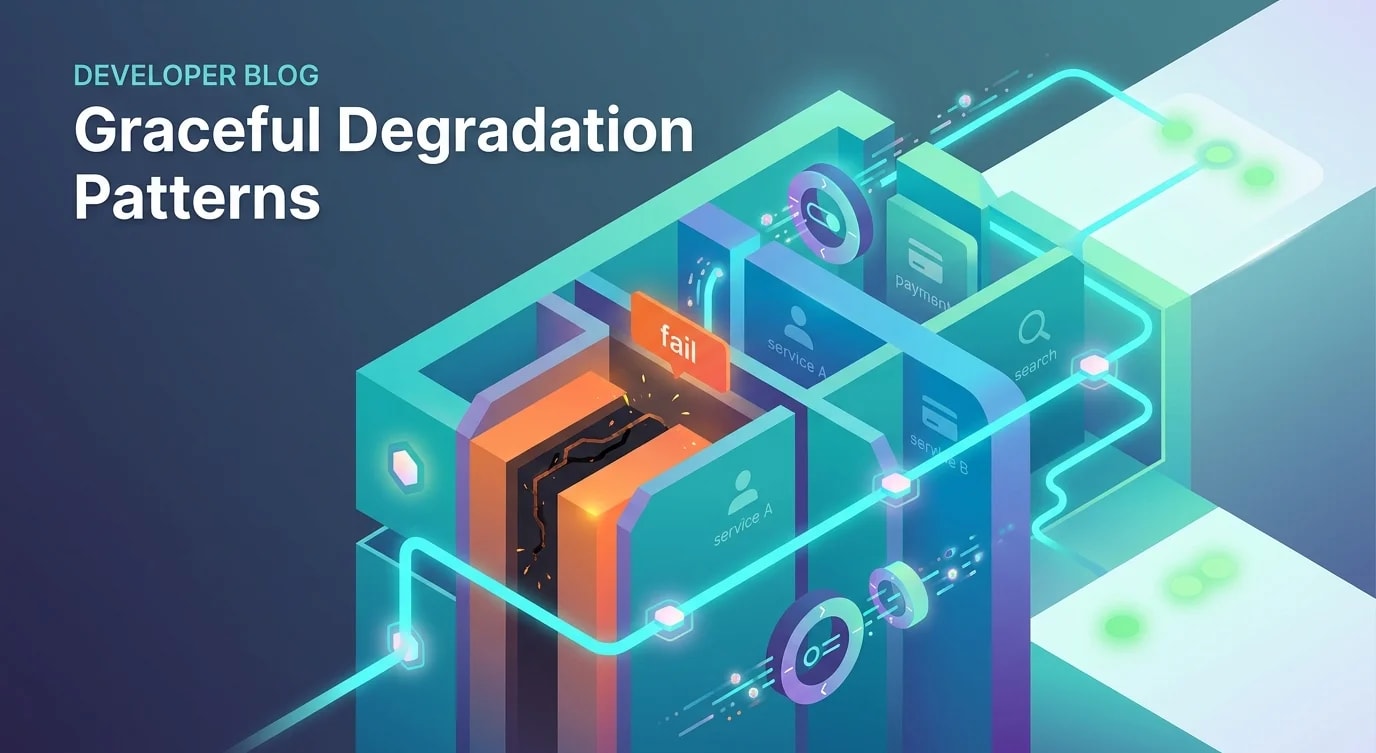
Fehlertoleranz in der Praxis: Circuit Breaker, Bulkheads, Fallback-Ketten und Degradationsstrategien, die Systeme bei Teilausfällen nutzbar halten.

Ein praxisnaher Rahmen, um technische Schulden in Zahlen zu fassen, die bei Stakeholdern ankommen: Code-Metriken, Velocity und Vorfallskorrelation.
Chaos Engineering in der Praxis: kontrollierte Fehler in Produktionssystemen aufdecken Schwachstellen — Netzwerkpartitionen, Ressourcen, Abhängigkeiten.

Baue ein Feature-Flag-System mit Rollouts, Nutzer-Targeting, A/B-Tests und Kill Switches — plus Lifecycle-Muster gegen Flag-Schulden.
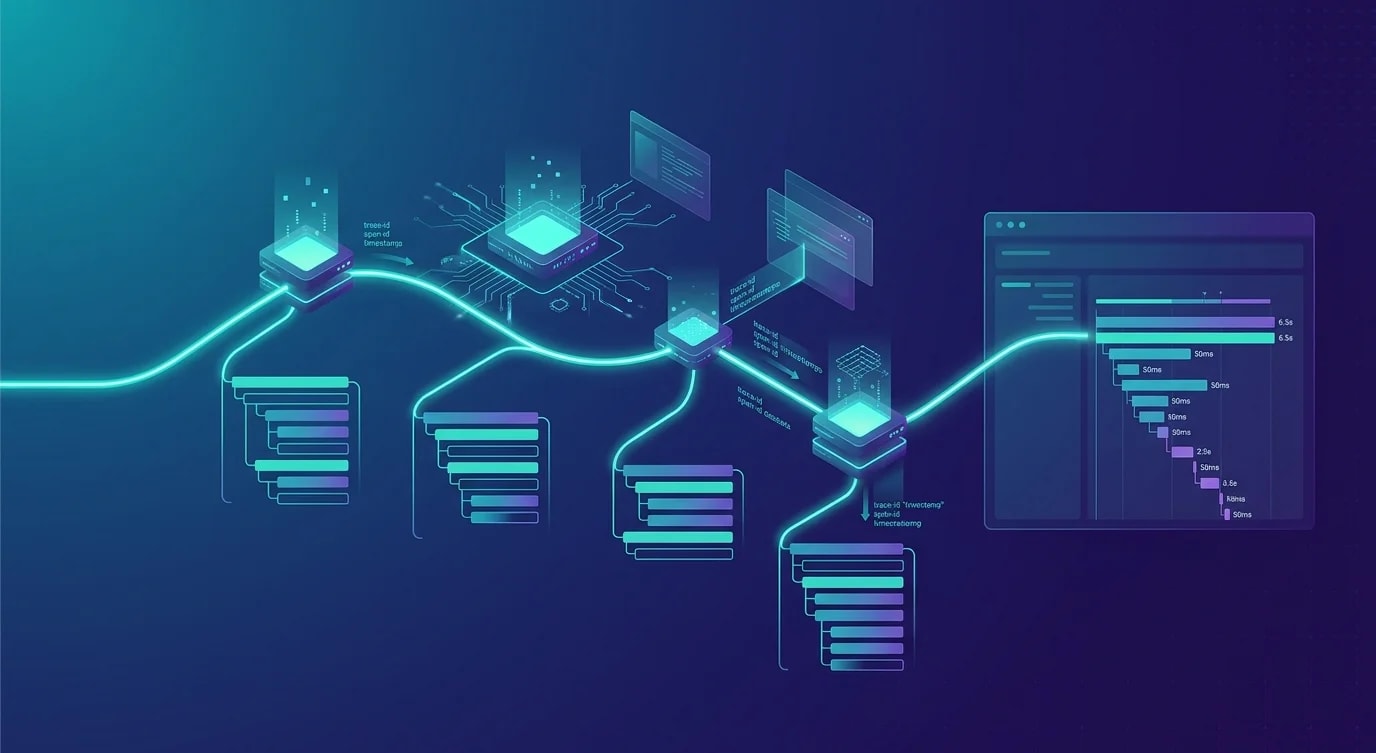
Distributed Tracing in Microservices mit OpenTelemetry: Kontextpropagation, Spans, Sampling und die Analyse, die Systeme debuggbar macht.
Entwirf und führe Lasttests mit k6 durch: Ramping-Strategien, realistische Nutzersimulation, Schwellenwerte und Ergebnisinterpretation.

Produktionsreifes Distributed Tracing mit OpenTelemetry: Kontextpropagation, Sampling, Storage-Backends, Log-Korrelation und Kardinalität.