Ingeniería de prompts para generación de código
Guía práctica para escribir prompts que generan código fiable y listo para producción: prompts estructurados, few-shot, chain-of-thought y evaluación.

Por qué fallan la mayoría de los prompts de generación de código
Escribes «escribe una función que valide direcciones de correo electrónico» en un LLM y obtienes código que funciona a medias. Maneja user@domain.com, pero falla con user+tag@sub.domain.co.uk. La expresión regular parece sacada de 2015. No hay tests. Los mensajes de error son genéricos.
El problema no es el modelo, es el prompt. Los prompts vagos producen código vago. El modelo rellena cada detalle que dejas sin especificar con su mejor suposición, y esa suposición es un promedio de todo lo que ha visto durante el entrenamiento. El código promedio no es código de producción.
La generación de código eficaz requiere tratar los prompts como especificaciones. Cuanto más precisamente definas las entradas, las salidas, las restricciones y los casos límite, más confiable será el código generado.
Prompts estructurados: el enfoque de especificación
Un prompt estructurado se lee como una especificación técnica. Define la firma de la función, las restricciones de entrada, el comportamiento esperado, los casos límite y los requisitos de calidad.
// ❌ Bad prompt: "Write a function to parse CSV files"
// Result: A basic split-by-comma implementation that breaks on quoted fields

// ✅ Good prompt structure:
const structuredPrompt = `
Write a TypeScript function with the following specification:

**Function signature:**
function parseCSV(input: string, options?: CSVOptions): ParsedRow[]

**Types:**
interface CSVOptions {
  delimiter?: string;    // Default: ','
  quote?: string;        // Default: '"'
  header?: boolean;      // Default: true (first row as keys)
  skipEmpty?: boolean;   // Default: true
}

type ParsedRow = Record<string, string> | string[];

**Requirements:**
- Handle quoted fields containing delimiters, newlines, and escaped quotes
- Support custom delimiters (tab, semicolon, pipe)
- When header=true, return Record<string, string>[]
- When header=false, return string[][]
- Throw a descriptive error for malformed CSV (unmatched quotes)
- Handle CRLF, LF, and CR line endings
- Empty lines should be skipped when skipEmpty is true

**Edge cases to handle:**
- Empty input string → return empty array
- Single column CSV
- Trailing delimiter on each line
- UTF-8 characters in values
- Fields that are only whitespace

**Do not use:**
- External libraries (implement from scratch)
- eval() or Function constructor
- Regular expressions for the core parsing (use a state machine)

**Include:** Unit tests using Vitest covering all edge cases listed above.
`;
Este prompt elimina la ambigüedad. El modelo no puede hacer suposiciones incorrectas sobre el manejo del delimitador, el tipo de retorno condicional o la normalización de saltos de línea, porque cada detalle está especificado.
Few-shot prompting: enseñar con ejemplos
Cuando necesitas que el LLM siga un estilo de código, un patrón o una convención específicos, muéstrale ejemplos. Los prompts few-shot funcionan mejor que describir el patrón con palabras.
// Few-shot prompt for consistent error handling pattern
const fewShotPrompt = `
I need functions that follow this exact error handling pattern:

**Example 1:**
\`\`\`typescript
type Result<T, E = Error> = { ok: true; value: T } | { ok: false; error: E };

async function fetchUser(id: string): Promise<Result<User>> {
  try {
    const response = await db.users.findUnique({ where: { id } });
    if (!response) {
      return { ok: false, error: new Error(\`User \${id} not found\`) };
    }
    return { ok: true, value: response };
  } catch (err) {
    return {
      ok: false,
      error: err instanceof Error ? err : new Error(String(err)),
    };
  }
}
\`\`\`

**Example 2:**
\`\`\`typescript
async function updateEmail(
  userId: string,
  email: string
): Promise<Result<User>> {
  try {
    const validation = validateEmail(email);
    if (!validation.ok) {
      return { ok: false, error: validation.error };
    }
    const updated = await db.users.update({
      where: { id: userId },
      data: { email },
    });
    return { ok: true, value: updated };
  } catch (err) {
    return {
      ok: false,
      error: err instanceof Error ? err : new Error(String(err)),
    };
  }
}
\`\`\`

Now write these functions following the exact same pattern:
1. createProject(name: string, ownerId: string) — creates a project, validates name is 3-50 chars
2. addMember(projectId: string, userId: string, role: "admin" | "member") — adds a member, checks project exists first
3. transferOwnership(projectId: string, currentOwnerId: string, newOwnerId: string) — validates current owner, updates ownership
`;
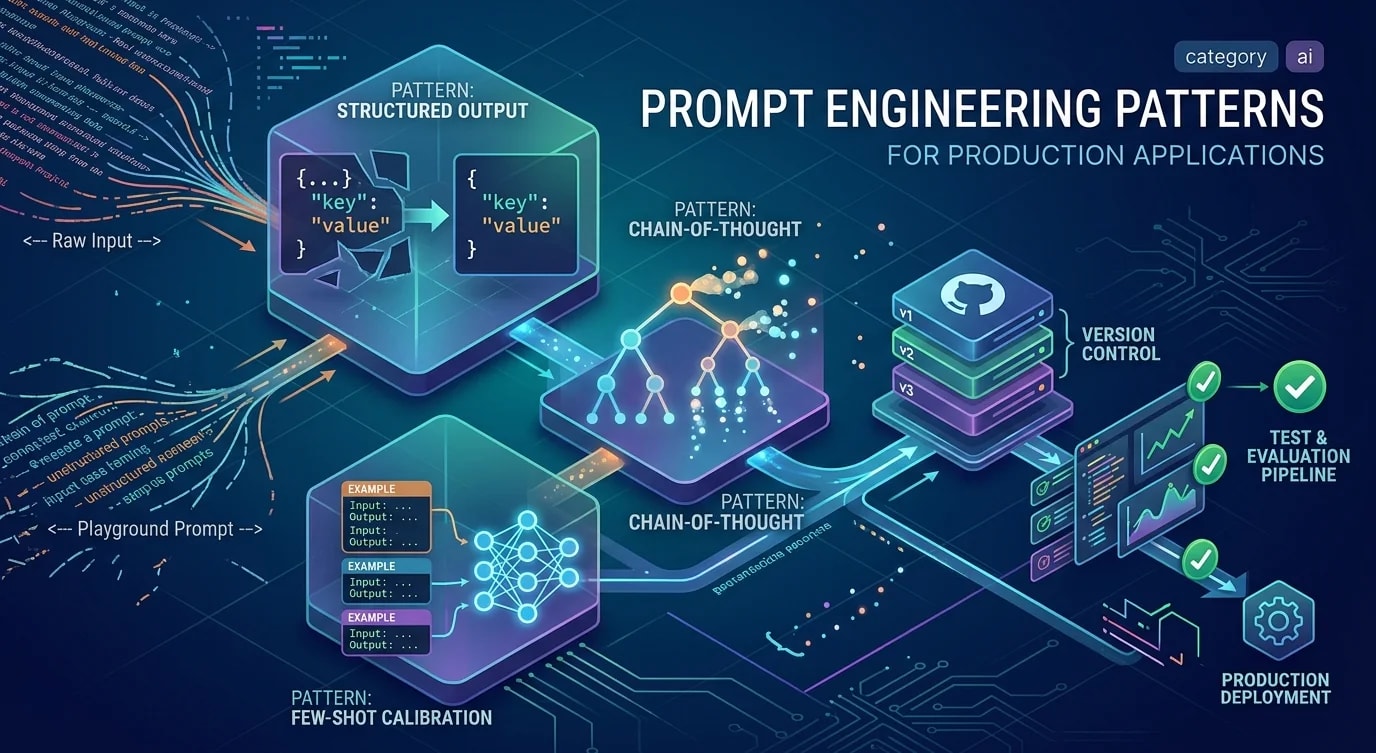
Los dos ejemplos establecen la convención del tipo Result, el patrón de envoltura try-catch, el flujo de validación primero y el patrón de conversión de errores. El modelo reproducirá este estilo de forma consistente en las tres funciones solicitadas.
Chain-of-thought para lógica compleja
En el caso de algoritmos o lógica de negocio compleja, pedirle al modelo que piense el enfoque antes de escribir el código produce resultados notablemente mejores.
const cotPrompt = `
I need a function that implements a meeting room scheduler.

Before writing code, think through:
1. What data structure best represents room availability?
2. How do you efficiently find the next available slot?
3. How do you handle overlapping booking requests?
4. What's the time complexity of each operation?

Then implement:

\`\`\`typescript
interface MeetingRoom {
  id: string;
  name: string;
  capacity: number;
}

interface BookingRequest {
  roomId: string;
  start: Date;
  end: Date;
  title: string;
  attendees: number;
}

interface Booking extends BookingRequest {
  id: string;
  createdAt: Date;
}

// Implement a MeetingScheduler class with:
// - bookRoom(request: BookingRequest): Booking | null
// - cancelBooking(bookingId: string): boolean
// - findAvailableSlots(date: Date, duration: number, capacity: number): TimeSlot[]
// - getBookingsForRoom(roomId: string, date: Date): Booking[]
\`\`\`

Requirements:
- No double-booking (overlapping times on same room)
- findAvailableSlots should return slots between 8:00-18:00
- Duration is in minutes
- Capacity filter: only show rooms that fit the attendee count
`;
La sección de «pensar antes de programar» obliga al modelo a planificar antes de implementar. Sin ella, los modelos suelen empezar a programar de inmediato, se dan cuenta a mitad de camino de que su elección de estructura de datos era errónea, y terminan produciendo código inconsistente.
Refinamiento iterativo: el bucle de conversación
La generación de código en una sola pasada rara vez produce resultados listos para producción. El flujo de trabajo más eficaz trata la generación de código como una conversación con refinamiento progresivo.
// Round 1: Generate the core implementation
const round1 = "Implement the MeetingScheduler class per the spec above.";

// Round 2: Add error handling
const round2 = `
The implementation works for happy paths. Now add:
- Input validation (start must be before end, duration must be positive)
- Proper error types instead of returning null
- Logging for booking conflicts (which existing booking caused the conflict)
`;

// Round 3: Optimize and test
const round3 = `
Two issues with the current implementation:
1. findAvailableSlots iterates all bookings — this is O(n) per room.
   Refactor to use an interval tree or sorted array with binary search.
2. Add Vitest tests that cover:
   - Booking a room successfully
   - Rejecting overlapping bookings
   - Finding slots across multiple rooms
   - Edge case: booking that starts exactly when another ends
`;

// Round 4: Production hardening
const round4 = `
Final refinements:
- Make the scheduler thread-safe (assume concurrent booking requests)
- Add a cleanup method that removes expired bookings
- Export types for consumers of this module
`;
Cada ronda aborda una preocupación específica. Esto es más eficaz que meter todo en un solo prompt, porque el modelo puede concentrar su atención en un problema más acotado en cada paso.
Antipatrones: prompts que producen mal código
// ❌ Anti-pattern 1: "Make it work" without constraints
const badPrompt1 = "Write a user authentication system";
// Result: A 200-line monolith with hardcoded passwords

// ❌ Anti-pattern 2: Over-constraining implementation details
const badPrompt2 = `
Write a sort function.
Use a for loop from i=0 to arr.length-1.
Inside that, use another for loop from j=0 to arr.length-i-1.
If arr[j] > arr[j+1], swap them.
`;
// This is just dictating bubble sort — you didn't need an LLM

// ❌ Anti-pattern 3: Asking for everything at once
const badPrompt3 = `
Build a complete REST API with:
- User authentication with JWT, OAuth, and magic links
- CRUD for projects, tasks, comments, and files
- Real-time notifications via WebSocket
- Rate limiting, caching, logging, and monitoring
- Database migrations and seed data
- Docker setup and CI/CD pipeline
- Full test suite with 90% coverage
`;
// Too broad — output will be shallow across everything

// ✅ Better: Focused, one concern at a time
const goodPrompt = `
Write the authentication middleware for a Next.js API.
It should:
- Extract JWT from the Authorization header (Bearer token)
- Verify the token using the HS256 algorithm
- Attach the decoded user to the request context
- Return 401 for missing/invalid tokens with a JSON error body
- Use jose library for JWT verification

Do not implement the login endpoint or token generation — only the middleware.
`;
Los mejores prompts son acotados en alcance pero ricos en detalle. Le indican al modelo exactamente qué construir, exactamente qué no construir y exactamente cómo debe verse el resultado.
Evaluar el código generado
Nunca despliegues código generado sin revisarlo. Crea una lista mental de verificación para evaluar la salida del LLM.
interface CodeReviewChecklist {
  category: string;
  checks: string[];
}

const llmCodeReview: CodeReviewChecklist[] = [
  {
    category: "Correctness",
    checks: [
      "Does it handle the specified edge cases?",
      "Are there off-by-one errors in loops or slicing?",
      "Does it handle null/undefined inputs?",
      "Are async operations properly awaited?",
    ],
  },
  {
    category: "Security",
    checks: [
      "Any hardcoded secrets or credentials?",
      "Is user input sanitized before use?",
      "Are SQL queries parameterized?",
      "Does it use eval(), innerHTML, or Function()?",
    ],
  },
  {
    category: "Hallucination",
    checks: [
      "Do the imported modules actually exist?",
      "Are the API signatures correct for the library version?",
      "Do referenced config options exist in the framework?",
      "Is the described behavior accurate for the platform?",
    ],
  },
  {
    category: "Production readiness",
    checks: [
      "Error handling for all failure modes?",
      "Appropriate logging without sensitive data?",
      "Resource cleanup (connections, file handles)?",
      "Performance reasonable for expected scale?",
    ],
  },
];
La categoría de alucinaciones es específica de los LLM. Los modelos usan con total confianza firmas de API que no existen, hacen referencia a opciones de configuración de otras versiones del framework e inventan funciones de biblioteca. Verifica siempre las importaciones y las llamadas a la API contra la documentación.
Conclusiones clave
La generación de código con LLM es una colaboración, no una orden. La calidad del resultado está limitada por la precisión de la entrada. Trata los prompts como especificaciones técnicas: define la interfaz, enumera los casos límite, especifica las restricciones y muestra los patrones que quieres que se sigan.
Usa ejemplos few-shot para mantener la consistencia de estilo, chain-of-thought para la lógica compleja y refinamiento iterativo para obtener resultados listos para producción. Nunca despliegues código generado sin revisar si hay APIs alucinadas, vulnerabilidades de seguridad y casos límite faltantes.
Los ingenieros que más provecho sacan de la generación de código con IA no son los que escriben los prompts más cortos. Son los que invierten más pensamiento en lo que piden, porque entienden que un prompt bien especificado ya es la mitad de la implementación.