Prompt Engineering für die Codegenerierung
Praktischer Leitfaden für Prompts, die zuverlässigen, produktionsreifen Code liefern: strukturiertes Prompting, Few-Shot, Chain-of-Thought, Evaluierung.

Warum die meisten Prompts für Codegenerierung scheitern
Du tippst „schreibe eine Funktion, die E-Mail-Adressen validiert" in ein LLM und bekommst Code zurück, der halbwegs funktioniert. Er verarbeitet user@domain.com, scheitert aber bei user+tag@sub.domain.co.uk. Der reguläre Ausdruck wirkt, als stamme er aus 2015. Es gibt keine Tests. Die Fehlermeldungen sind generisch.
Das Problem ist nicht das Modell, sondern der Prompt. Vage Prompts erzeugen vagen Code. Das Modell füllt jedes Detail, das du offenlässt, mit seiner besten Vermutung – und diese Vermutung ist ein Durchschnitt aus allem, was es in den Trainingsdaten gesehen hat. Durchschnittlicher Code ist kein produktionsreifer Code.
Effektive Codegenerierung setzt voraus, Prompts wie Spezifikationen zu behandeln. Je präziser du Eingaben, Ausgaben, Einschränkungen und Grenzfälle definierst, desto zuverlässiger wird der generierte Code.
Strukturierte Prompts: der Spezifikationsansatz
Ein strukturierter Prompt liest sich wie eine technische Spezifikation. Er definiert die Funktionssignatur, die Eingabebeschränkungen, das erwartete Verhalten, die Grenzfälle und die Qualitätsanforderungen.
// ❌ Bad prompt: "Write a function to parse CSV files"
// Result: A basic split-by-comma implementation that breaks on quoted fields

// ✅ Good prompt structure:
const structuredPrompt = `
Write a TypeScript function with the following specification:

**Function signature:**
function parseCSV(input: string, options?: CSVOptions): ParsedRow[]

**Types:**
interface CSVOptions {
  delimiter?: string;    // Default: ','
  quote?: string;        // Default: '"'
  header?: boolean;      // Default: true (first row as keys)
  skipEmpty?: boolean;   // Default: true
}

type ParsedRow = Record<string, string> | string[];

**Requirements:**
- Handle quoted fields containing delimiters, newlines, and escaped quotes
- Support custom delimiters (tab, semicolon, pipe)
- When header=true, return Record<string, string>[]
- When header=false, return string[][]
- Throw a descriptive error for malformed CSV (unmatched quotes)
- Handle CRLF, LF, and CR line endings
- Empty lines should be skipped when skipEmpty is true

**Edge cases to handle:**
- Empty input string → return empty array
- Single column CSV
- Trailing delimiter on each line
- UTF-8 characters in values
- Fields that are only whitespace

**Do not use:**
- External libraries (implement from scratch)
- eval() or Function constructor
- Regular expressions for the core parsing (use a state machine)

**Include:** Unit tests using Vitest covering all edge cases listed above.
`;
Dieser Prompt beseitigt jede Mehrdeutigkeit. Das Modell kann keine falschen Annahmen über die Behandlung des Trennzeichens, den bedingten Rückgabetyp oder die Normalisierung der Zeilenumbrüche treffen, weil jedes Detail spezifiziert ist.
Few-Shot-Prompting: Lernen am Beispiel
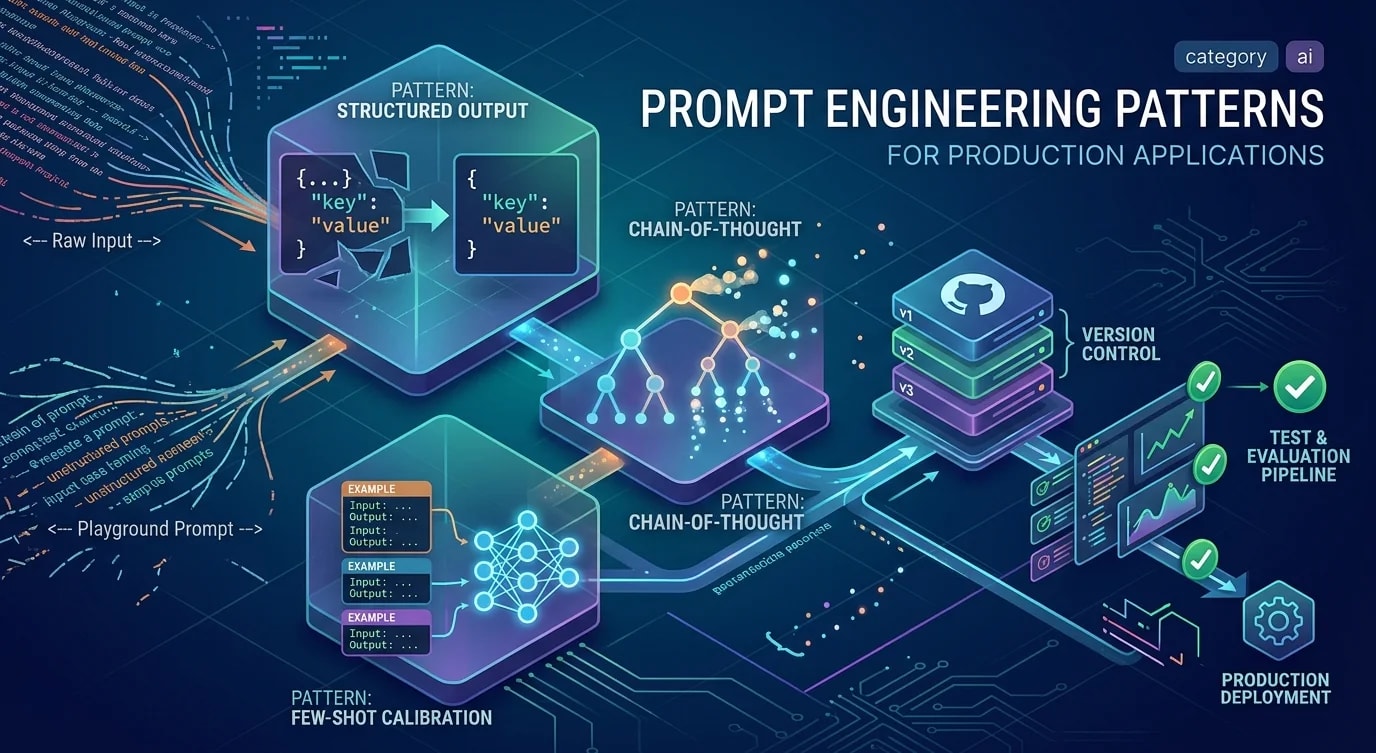
Wenn das LLM einem bestimmten Codestil, Muster oder einer Konvention folgen soll, zeig ihm Beispiele. Few-Shot-Prompts funktionieren besser, als das Muster in Worten zu beschreiben.
// Few-shot prompt for consistent error handling pattern
const fewShotPrompt = `
I need functions that follow this exact error handling pattern:

**Example 1:**
\`\`\`typescript
type Result<T, E = Error> = { ok: true; value: T } | { ok: false; error: E };

async function fetchUser(id: string): Promise<Result<User>> {
  try {
    const response = await db.users.findUnique({ where: { id } });
    if (!response) {
      return { ok: false, error: new Error(\`User \${id} not found\`) };
    }
    return { ok: true, value: response };
  } catch (err) {
    return {
      ok: false,
      error: err instanceof Error ? err : new Error(String(err)),
    };
  }
}
\`\`\`

**Example 2:**
\`\`\`typescript
async function updateEmail(
  userId: string,
  email: string
): Promise<Result<User>> {
  try {
    const validation = validateEmail(email);
    if (!validation.ok) {
      return { ok: false, error: validation.error };
    }
    const updated = await db.users.update({
      where: { id: userId },
      data: { email },
    });
    return { ok: true, value: updated };
  } catch (err) {
    return {
      ok: false,
      error: err instanceof Error ? err : new Error(String(err)),
    };
  }
}
\`\`\`

Now write these functions following the exact same pattern:
1. createProject(name: string, ownerId: string) — creates a project, validates name is 3-50 chars
2. addMember(projectId: string, userId: string, role: "admin" | "member") — adds a member, checks project exists first
3. transferOwnership(projectId: string, currentOwnerId: string, newOwnerId: string) — validates current owner, updates ownership
`;
Die beiden Beispiele legen die Result-Typ-Konvention, das try-catch-Wrapping-Muster, den Ablauf „erst validieren" und das Muster zur Fehlerumwandlung fest. Das Modell wird diesen Stil bei allen drei angeforderten Funktionen konsistent reproduzieren.
Chain-of-Thought für komplexe Logik
Bei Algorithmen oder komplexer Geschäftslogik liefert es deutlich bessere Ergebnisse, das Modell zu bitten, den Lösungsansatz zu durchdenken, bevor es zu programmieren beginnt.
const cotPrompt = `
I need a function that implements a meeting room scheduler.

Before writing code, think through:
1. What data structure best represents room availability?
2. How do you efficiently find the next available slot?
3. How do you handle overlapping booking requests?
4. What's the time complexity of each operation?

Then implement:

\`\`\`typescript
interface MeetingRoom {
  id: string;
  name: string;
  capacity: number;
}

interface BookingRequest {
  roomId: string;
  start: Date;
  end: Date;
  title: string;
  attendees: number;
}

interface Booking extends BookingRequest {
  id: string;
  createdAt: Date;
}

// Implement a MeetingScheduler class with:
// - bookRoom(request: BookingRequest): Booking | null
// - cancelBooking(bookingId: string): boolean
// - findAvailableSlots(date: Date, duration: number, capacity: number): TimeSlot[]
// - getBookingsForRoom(roomId: string, date: Date): Booking[]
\`\`\`

Requirements:
- No double-booking (overlapping times on same room)
- findAvailableSlots should return slots between 8:00-18:00
- Duration is in minutes
- Capacity filter: only show rooms that fit the attendee count
`;
Der Abschnitt zum „Durchdenken" zwingt das Modell, erst zu planen und dann zu implementieren. Ohne ihn fangen Modelle oft sofort an zu programmieren, merken auf halbem Weg, dass ihre Wahl der Datenstruktur falsch war, und liefern am Ende inkonsistenten Code.
Iteratives Verfeinern: die Konversationsschleife
Codegenerierung in einem einzigen Durchgang liefert selten produktionsreife Ergebnisse. Der wirksamste Arbeitsablauf behandelt Codegenerierung als Konversation mit schrittweiser Verfeinerung.
// Round 1: Generate the core implementation
const round1 = "Implement the MeetingScheduler class per the spec above.";

// Round 2: Add error handling
const round2 = `
The implementation works for happy paths. Now add:
- Input validation (start must be before end, duration must be positive)
- Proper error types instead of returning null
- Logging for booking conflicts (which existing booking caused the conflict)
`;

// Round 3: Optimize and test
const round3 = `
Two issues with the current implementation:
1. findAvailableSlots iterates all bookings — this is O(n) per room.
   Refactor to use an interval tree or sorted array with binary search.
2. Add Vitest tests that cover:
   - Booking a room successfully
   - Rejecting overlapping bookings
   - Finding slots across multiple rooms
   - Edge case: booking that starts exactly when another ends
`;

// Round 4: Production hardening
const round4 = `
Final refinements:
- Make the scheduler thread-safe (assume concurrent booking requests)
- Add a cleanup method that removes expired bookings
- Export types for consumers of this module
`;
Jede Runde adressiert ein einzelnes Anliegen. Das ist wirksamer, als alles in einen einzigen Prompt zu packen, weil das Modell seine Aufmerksamkeit bei jedem Schritt auf ein enger gefasstes Problem richten kann.
Anti-Patterns: Prompts, die schlechten Code erzeugen
// ❌ Anti-pattern 1: "Make it work" without constraints
const badPrompt1 = "Write a user authentication system";
// Result: A 200-line monolith with hardcoded passwords

// ❌ Anti-pattern 2: Over-constraining implementation details
const badPrompt2 = `
Write a sort function.
Use a for loop from i=0 to arr.length-1.
Inside that, use another for loop from j=0 to arr.length-i-1.
If arr[j] > arr[j+1], swap them.
`;
// This is just dictating bubble sort — you didn't need an LLM

// ❌ Anti-pattern 3: Asking for everything at once
const badPrompt3 = `
Build a complete REST API with:
- User authentication with JWT, OAuth, and magic links
- CRUD for projects, tasks, comments, and files
- Real-time notifications via WebSocket
- Rate limiting, caching, logging, and monitoring
- Database migrations and seed data
- Docker setup and CI/CD pipeline
- Full test suite with 90% coverage
`;
// Too broad — output will be shallow across everything

// ✅ Better: Focused, one concern at a time
const goodPrompt = `
Write the authentication middleware for a Next.js API.
It should:
- Extract JWT from the Authorization header (Bearer token)
- Verify the token using the HS256 algorithm
- Attach the decoded user to the request context
- Return 401 for missing/invalid tokens with a JSON error body
- Use jose library for JWT verification

Do not implement the login endpoint or token generation — only the middleware.
`;
Die besten Prompts sind eng im Umfang, aber reich an Details. Sie sagen dem Modell genau, was es bauen soll, genau, was es nicht bauen soll, und genau, wie das Ergebnis aussehen soll.
Generierten Code bewerten
Setze generierten Code niemals ohne Review ein. Erstelle dir eine gedankliche Checkliste zur Bewertung der LLM-Ausgabe.
interface CodeReviewChecklist {
  category: string;
  checks: string[];
}

const llmCodeReview: CodeReviewChecklist[] = [
  {
    category: "Correctness",
    checks: [
      "Does it handle the specified edge cases?",
      "Are there off-by-one errors in loops or slicing?",
      "Does it handle null/undefined inputs?",
      "Are async operations properly awaited?",
    ],
  },
  {
    category: "Security",
    checks: [
      "Any hardcoded secrets or credentials?",
      "Is user input sanitized before use?",
      "Are SQL queries parameterized?",
      "Does it use eval(), innerHTML, or Function()?",
    ],
  },
  {
    category: "Hallucination",
    checks: [
      "Do the imported modules actually exist?",
      "Are the API signatures correct for the library version?",
      "Do referenced config options exist in the framework?",
      "Is the described behavior accurate for the platform?",
    ],
  },
  {
    category: "Production readiness",
    checks: [
      "Error handling for all failure modes?",
      "Appropriate logging without sensitive data?",
      "Resource cleanup (connections, file handles)?",
      "Performance reasonable for expected scale?",
    ],
  },
];
Die Kategorie „Halluzination" ist LLM-spezifisch. Modelle verwenden mit voller Überzeugung API-Signaturen, die es nicht gibt, beziehen sich auf Konfigurationsoptionen aus anderen Framework-Versionen und erfinden Bibliotheksfunktionen. Überprüfe Importe und API-Aufrufe immer anhand der Dokumentation.
Die wichtigsten Erkenntnisse
Codegenerierung durch LLMs ist eine Zusammenarbeit, kein Befehl. Die Qualität der Ausgabe wird durch die Präzision der Eingabe begrenzt. Behandle Prompts wie technische Spezifikationen: Definiere die Schnittstelle, zähle die Grenzfälle auf, spezifiziere die Einschränkungen und zeige die Muster, denen gefolgt werden soll.
Nutze Few-Shot-Beispiele für stilistische Konsistenz, Chain-of-Thought für komplexe Logik und iteratives Verfeinern für produktionsreife Ergebnisse. Setze generierten Code niemals ein, ohne auf halluzinierte APIs, Sicherheitslücken und fehlende Grenzfälle zu prüfen.
Die Entwickler, die den größten Nutzen aus KI-Codegenerierung ziehen, sind nicht die, die die kürzesten Prompts schreiben. Es sind die, die am meisten Gedankenarbeit in das investieren, was sie anfragen, weil sie verstehen, dass ein gut spezifizierter Prompt bereits die halbe Implementierung ist.