Große Datenmengen in Node.js streamen mit Backpressure
Schluss mit dem Laden ganzer Ergebnismengen: wie Node.js-Streams und asynchrone Generatoren Millionen Datensätze verarbeiten, ohne den Heap zu sprengen.
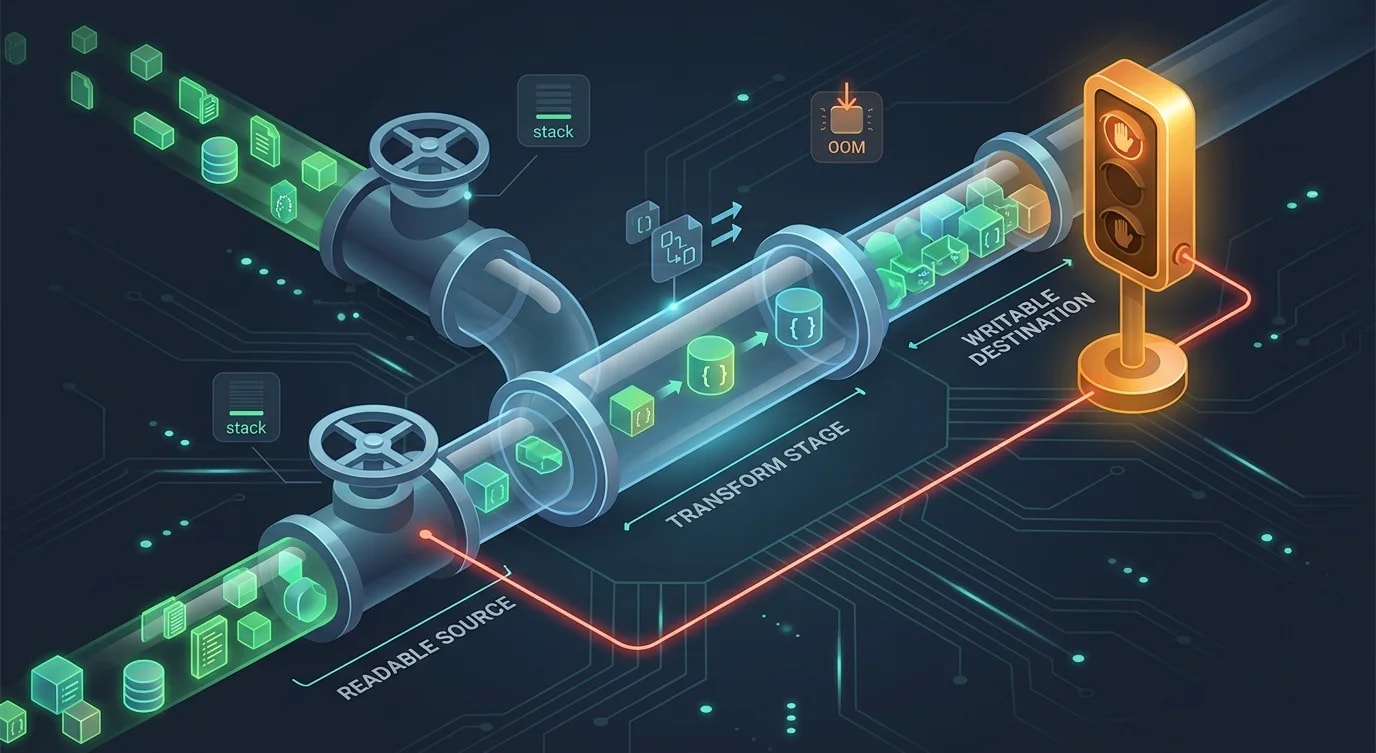
Die meisten APIs, die „in der Entwicklung einwandfrei funktionieren", tragen eine stille Zeitbombe in sich: Sie laden komplette Ergebnismengen in den Speicher, bevor sie überhaupt etwas damit tun. Bei tausend Zeilen fällt das nicht auf. Bei hunderttausend schießen die Antwortzeiten in die Höhe. Bei einer Million läuft der Prozess in ein OOM und reißt den Pod mit sich. Streams sind die Standardlösung — aber gerade bei den Implementierungsdetails, vor allem beim Backpressure, scheitern die meisten Versuche.
Warum das Laden von allem die Produktion lahmlegt
Das problematische Muster begegnet einem überall:
// ❌ Loads the entire table into a JS array before the first byte is sent
export async function GET(req: Request) {
  const users = await db.query<User>(
    "SELECT * FROM users WHERE tenant_id = $1",
    [req.tenantId],
  );
  return Response.json(users); // serializes all rows at once — heap spikes with result size
}

// ✅ Streams rows as they arrive — heap usage stays flat regardless of row count
export async function GET(req: Request) {
  const rows = db.queryStream<User>(
    "SELECT * FROM users WHERE tenant_id = $1",
    [req.tenantId],
  );
  return new Response(serializeNDJSON(rows), {
    headers: { "Content-Type": "application/x-ndjson" },
  });
}
Die Streaming-Variante verarbeitet jeweils eine Zeile. Ob du 500 Zeilen sendest oder 5 Millionen, der Heap-Verbrauch bleibt nahezu konstant. Der Preis dafür ist Komplexität — und die steckt größtenteils im Backpressure.
Die Stream-Abstraktion in Node.js
Node.js-Streams gibt es in vier Varianten: Readable, Writable, Duplex und Transform. Für Pipelines mit großen Datenmengen arbeitest du meist mit Readable (der Datenquelle) und Transform (der Datenformung), die per Pipe in einen Writable (HTTP-Antwort, Datei, Message Queue) münden.
Der kanonische Verbindungspunkt ist stream.pipeline, nicht .pipe(). Der entscheidende Unterschied: pipeline propagiert Fehler und räumt bei einem Fehlschlag alle beteiligten Streams auf. .pipe() hinterlässt hängende Event-Listener, wenn mitten im Stream ein Fehler auftritt.
import { pipeline, Transform } from "node:stream";
import { promisify } from "node:util";

const pipelineAsync = promisify(pipeline);

async function exportUsersToResponse(
  queryStream: NodeJS.ReadableStream,
  res: NodeJS.WritableStream,
): Promise<void> {
  const ndJsonTransform = new Transform({
    objectMode: true,
    transform(row: unknown, _encoding, callback) {
      try {
        this.push(JSON.stringify(row) + "\n");
        callback();
      } catch (err) {
        callback(err as Error);
      }
    },
  });

  // All three streams are destroyed together on error or completion
  await pipelineAsync(queryStream, ndJsonTransform, res);
}
Jeder Stream in der Pipeline wird aufgeräumt, sobald irgendeine Stufe einen Fehler wirft. Keine manuellen .destroy()-Aufrufe, verstreut über deine Handler.
Backpressure: der Teil, den niemand implementiert
Backpressure ist der Mechanismus, mit dem ein langsamer Consumer einem schnellen Producer signalisiert, dass er pausieren soll. Lässt man das weg, puffert man unbegrenzt Daten im Speicher — genau das, was man eigentlich vermeiden wollte.
Wenn du writable.write(chunk) aufrufst, liefert das einen Boolean zurück. false bedeutet, dass der interne Puffer voll ist und du die Quelle pausieren solltest. Diesen Rückgabewert zu ignorieren ist der häufigste Streaming-Bug in produktivem Node.js-Code.
// ❌ Ignores backpressure — the writable's internal buffer grows without bound
readable.on("data", (chunk) => {
  writable.write(chunk); // return value silently discarded
});

// ✅ Respects backpressure — pauses the source when the consumer's buffer is full
readable.on("data", (chunk) => {
  const canContinue = writable.write(chunk);
  if (!canContinue) {
    readable.pause();
    writable.once("drain", () => readable.resume());
  }
});
stream.pipeline und .pipe() erledigen das automatisch, wenn Streams über sie verbunden sind. Gefährlich wird es, wenn du manuell aus einem Readable liest — über "data"-Events oder .read() — und selbst in einen Writable schreibst. Genau dort geht das Backpressure verloren.
Asynchrone Generatoren: ein saubereres mentales Modell
Die Streams-API ist mächtig, aber umständlich. Asynchrone Generatoren bieten für dasselbe Konzept eine ergonomischere Schnittstelle. Node.js-Readable-Streams implementieren AsyncIterable nativ, sodass du sie direkt mit for await...of durchlaufen kannst.
async function* transformRows<T, R>(
  source: AsyncIterable<T>,
  transform: (row: T) => R | Promise<R>,
): AsyncGenerator<R> {
  for await (const row of source) {
    yield await transform(row);
  }
}

async function* serializeToNDJSON<T>(source: AsyncIterable<T>): AsyncGenerator<string> {
  for await (const item of source) {
    yield JSON.stringify(item) + "\n";
  }
}
Diese lassen sich ohne Umstände kombinieren:
async function streamExport(tenantId: string, res: ServerResponse): Promise<void> {
  const rows = db.queryStream<RawUser>(
    "SELECT id, email, name, created_at FROM users WHERE tenant_id = $1 ORDER BY created_at",
    [tenantId],
  );

  const normalized = transformRows(rows, normalizeUser);
  const serialized = serializeToNDJSON(normalized);

  try {
    for await (const chunk of serialized) {
      const ok = res.write(chunk);
      if (!ok) {
        // Await drain before pulling more from the generator
        await new Promise<void>((resolve) => res.once("drain", resolve));
      }
    }
  } finally {
    res.end();
  }
}
Die for await...of-Schleife pausiert von selbst, sobald du darin await verwendest — Backpressure gibt es gratis dazu, solange du beim Schreiben wartest (await), wenn der Puffer voll ist.
Asynchrone Generatoren propagieren Stream-Fehler nicht automatisch. Umschließe
deinen Consumer immer mit try/finally und zerstöre die vorgelagerte Quelle
im Fehlerfall — Datenbank-Cursor und Datei-Handles leaken sonst unbemerkt,
wenn der Readable mitten in der Iteration aufgegeben wird.
Praxis: einen CSV-Export streamen
Ein vollständiger CSV-Export-Handler zeigt alle Teile zusammen in produktionsreifer Form:
import { Transform, pipeline } from "node:stream";
import { promisify } from "node:util";

const pipelineAsync = promisify(pipeline);

class CsvTransform extends Transform {
  private headerWritten = false;

  constructor(private readonly headers: string[]) {
    super({ objectMode: true });
  }

  override _transform(
    row: Record<string, unknown>,
    _encoding: BufferEncoding,
    callback: (err?: Error | null) => void,
  ): void {
    try {
      if (!this.headerWritten) {
        this.push(this.headers.join(",") + "\r\n");
        this.headerWritten = true;
      }

      const values = this.headers.map((h) => {
        const raw = String(row[h] ?? "").replace(/"/g, '""');
        return raw.includes(",") || raw.includes('"') || raw.includes("\n")
          ? `"${raw}"`
          : raw;
      });

      this.push(values.join(",") + "\r\n");
      callback();
    } catch (err) {
      callback(err as Error);
    }
  }
}

export async function handleCsvExport(
  tenantId: string,
  res: NodeJS.WritableStream,
): Promise<void> {
  const queryStream = db.queryStream<Record<string, unknown>>(
    "SELECT id, email, name, created_at FROM users WHERE tenant_id = $1",
    [tenantId],
  );

  const csvTransform = new CsvTransform(["id", "email", "name", "created_at"]);

  // The database cursor, transform, and HTTP response are all destroyed together on error
  await pipelineAsync(queryStream, csvTransform, res);
}
Der Heap bleibt bei jeder Ergebnisgröße flach. Trennt der Client die Verbindung mitten im Download, propagiert sich der Fehler zurück durch pipeline, und der Datenbank-Cursor wird sofort freigegeben.
Wann man nicht streamen sollte
Streaming bringt echte Komplexität mit sich. Nicht jede große Antwort braucht es.
| Szenario | Ansatz | Grund |
|---|---|---|
| < 10.000 Zeilen, interne API | In den Speicher laden | Einfacher, vernachlässigbare Heap-Auswirkung |
| Paginierter UI-Endpunkt | Cursor-basierte Paginierung | Client braucht wahlfreien Zugriff pro Seite |
| Großer Export (CSV, NDJSON) | Streaming | Konstanter Speicherverbrauch, kein Antwort-Timeout |
| ETL, Millionen Zeilen | Streaming + Batch-Schreibvorgänge | Sowohl Durchsatz als auch Speicher zählen |
| Echtzeit-Dashboard-Feed | SSE oder WebSocket | Ein völlig anderes Problem |
Die Faustregel: Streame, wenn du die Ergebnisgröße zum Zeitpunkt der Anfrage nicht eingrenzen kannst oder wenn der Client mit dem Konsumieren beginnen soll, bevor der Producer fertig ist. Greife erst nach dem Profiling zu Streaming, wenn es sich als nötig erweist — nicht standardmäßig.
Die wichtigsten Erkenntnisse
stream.pipelinestatt.pipe()— korrekte Fehlerpropagierung und Stream-Aufräumung, immer.- Backpressure ist nicht optional — prüfe den Boolean-Rückgabewert von
writable.write()und pausiere die Quelle beifalse. - Asynchrone Generatoren lassen sich natürlich kombinieren —
for await...ofmacht Backpressure ergonomisch, wenn du Schreibvorgänge innerhalb der Schleife awaitest. - Quellen im Fehlerfall zerstören — Datenbank-Cursor und Datei-Handles leaken still und leise, wenn Readables aufgegeben werden; sowohl
pipelineals auchtry/finallyschützen davor. - Vor dem Streamen messen — eine Pipeline zu einer 200-Zeilen-Abfrage hinzuzufügen bringt Komplexität ohne jeden Nutzen; der richtige Zeitpunkt für Streams ist, wenn die Ergebnisgröße unbegrenzt ist oder große Exporte eine echte Anforderung sind.