Streaming de grandes volúmenes en Node.js con backpressure
Deja de cargar resultados completos en memoria: cómo los streams de Node.js y los generadores asíncronos procesan millones de registros sin reventar el heap.
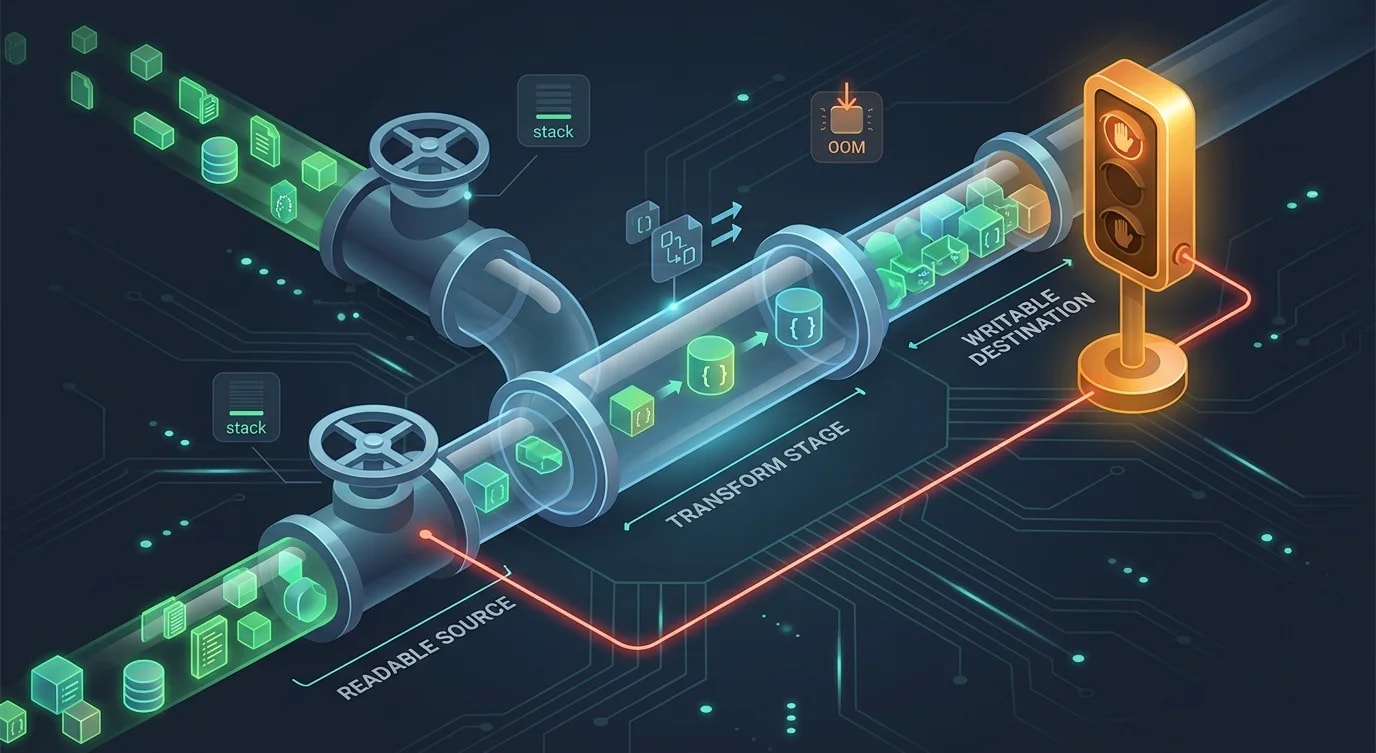
La mayoría de las APIs que "funcionan bien en desarrollo" esconden una bomba de tiempo silenciosa: cargan conjuntos de resultados completos en memoria antes de hacer nada con ellos. Con mil filas, esto pasa desapercibido. Con cien mil, los tiempos de respuesta se disparan. Con un millón, el proceso agota la memoria (OOM) y tumba el pod. Los streams son la solución estándar, pero los detalles de implementación, sobre todo el backpressure, son donde la mayoría de los intentos fracasan.
Por qué cargarlo todo hunde producción
El patrón problemático está por todas partes:
// ❌ Loads the entire table into a JS array before the first byte is sent
export async function GET(req: Request) {
  const users = await db.query<User>(
    "SELECT * FROM users WHERE tenant_id = $1",
    [req.tenantId],
  );
  return Response.json(users); // serializes all rows at once — heap spikes with result size
}

// ✅ Streams rows as they arrive — heap usage stays flat regardless of row count
export async function GET(req: Request) {
  const rows = db.queryStream<User>(
    "SELECT * FROM users WHERE tenant_id = $1",
    [req.tenantId],
  );
  return new Response(serializeNDJSON(rows), {
    headers: { "Content-Type": "application/x-ndjson" },
  });
}
La versión con streaming procesa una fila a la vez. Ya sea que envíes 500 filas o 5 millones, el uso de heap se mantiene prácticamente constante. La contrapartida es la complejidad, y esa complejidad vive sobre todo en el backpressure.
La abstracción de streams en Node.js
Los streams de Node.js vienen en cuatro variantes: Readable, Writable, Duplex y Transform. Para pipelines de grandes volúmenes de datos, normalmente trabajas con Readable (la fuente de datos) y Transform (el moldeado de datos), conectados mediante pipe a un Writable (una respuesta HTTP, un archivo, una cola de mensajes).
El punto de conexión canónico es stream.pipeline, no .pipe(). La diferencia crítica: pipeline propaga los errores y limpia todos los streams participantes cuando algo falla. .pipe() deja listeners de eventos colgando cuando ocurre un error a mitad del stream.
import { pipeline, Transform } from "node:stream";
import { promisify } from "node:util";

const pipelineAsync = promisify(pipeline);

async function exportUsersToResponse(
  queryStream: NodeJS.ReadableStream,
  res: NodeJS.WritableStream,
): Promise<void> {
  const ndJsonTransform = new Transform({
    objectMode: true,
    transform(row: unknown, _encoding, callback) {
      try {
        this.push(JSON.stringify(row) + "\n");
        callback();
      } catch (err) {
        callback(err as Error);
      }
    },
  });

  // All three streams are destroyed together on error or completion
  await pipelineAsync(queryStream, ndJsonTransform, res);
}
Cada stream del pipeline se limpia cuando cualquier etapa falla. No hacen falta llamadas manuales a .destroy() repartidas por tus handlers.
Backpressure: la parte que nadie implementa
El backpressure es el mecanismo por el cual un consumidor lento le indica a un productor rápido que debe pausarse. Si te lo saltas, terminas acumulando datos sin límite en memoria, justo lo que intentabas evitar.
Cuando llamas a writable.write(chunk), se devuelve un booleano. false significa que el búfer interno está lleno y que deberías pausar la fuente. Ignorar este valor de retorno es el bug de streaming más común en código Node.js de producción.
// ❌ Ignores backpressure — the writable's internal buffer grows without bound
readable.on("data", (chunk) => {
  writable.write(chunk); // return value silently discarded
});

// ✅ Respects backpressure — pauses the source when the consumer's buffer is full
readable.on("data", (chunk) => {
  const canContinue = writable.write(chunk);
  if (!canContinue) {
    readable.pause();
    writable.once("drain", () => readable.resume());
  }
});
stream.pipeline y .pipe() gestionan esto automáticamente cuando los streams se conectan a través de ellos. La zona de peligro aparece cuando lees de un readable manualmente, mediante eventos "data" o .read(), y escribes en un writable por tu cuenta. Ahí es donde se pierde el backpressure.
Generadores asíncronos: un modelo mental más limpio
La API de Streams es potente pero verbosa. Los generadores asíncronos ofrecen una interfaz más ergonómica para el mismo concepto. Los streams Readable de Node.js implementan AsyncIterable de forma nativa, así que puedes iterarlos directamente con for await...of.
async function* transformRows<T, R>(
  source: AsyncIterable<T>,
  transform: (row: T) => R | Promise<R>,
): AsyncGenerator<R> {
  for await (const row of source) {
    yield await transform(row);
  }
}

async function* serializeToNDJSON<T>(source: AsyncIterable<T>): AsyncGenerator<string> {
  for await (const item of source) {
    yield JSON.stringify(item) + "\n";
  }
}
Estos se combinan sin ceremonias:
async function streamExport(tenantId: string, res: ServerResponse): Promise<void> {
  const rows = db.queryStream<RawUser>(
    "SELECT id, email, name, created_at FROM users WHERE tenant_id = $1 ORDER BY created_at",
    [tenantId],
  );

  const normalized = transformRows(rows, normalizeUser);
  const serialized = serializeToNDJSON(normalized);

  try {
    for await (const chunk of serialized) {
      const ok = res.write(chunk);
      if (!ok) {
        // Await drain before pulling more from the generator
        await new Promise<void>((resolve) => res.once("drain", resolve));
      }
    }
  } finally {
    res.end();
  }
}
El bucle for await...of se pausa de forma natural cada vez que haces await dentro de él: el backpressure llega gratis mientras esperes (await) las escrituras cuando el búfer se llena.
Los generadores asíncronos no propagan los errores del stream automáticamente.
Envuelve siempre tu consumidor en try/finally y destruye la fuente
ascendente en caso de error: los cursores de base de datos y los descriptores
de archivo se filtran en silencio si el readable se abandona a mitad de la
iteración.
En la práctica: exportar un CSV en streaming
Un handler completo de exportación a CSV muestra todas las piezas juntas, con calidad de producción:
import { Transform, pipeline } from "node:stream";
import { promisify } from "node:util";

const pipelineAsync = promisify(pipeline);

class CsvTransform extends Transform {
  private headerWritten = false;

  constructor(private readonly headers: string[]) {
    super({ objectMode: true });
  }

  override _transform(
    row: Record<string, unknown>,
    _encoding: BufferEncoding,
    callback: (err?: Error | null) => void,
  ): void {
    try {
      if (!this.headerWritten) {
        this.push(this.headers.join(",") + "\r\n");
        this.headerWritten = true;
      }

      const values = this.headers.map((h) => {
        const raw = String(row[h] ?? "").replace(/"/g, '""');
        return raw.includes(",") || raw.includes('"') || raw.includes("\n")
          ? `"${raw}"`
          : raw;
      });

      this.push(values.join(",") + "\r\n");
      callback();
    } catch (err) {
      callback(err as Error);
    }
  }
}

export async function handleCsvExport(
  tenantId: string,
  res: NodeJS.WritableStream,
): Promise<void> {
  const queryStream = db.queryStream<Record<string, unknown>>(
    "SELECT id, email, name, created_at FROM users WHERE tenant_id = $1",
    [tenantId],
  );

  const csvTransform = new CsvTransform(["id", "email", "name", "created_at"]);

  // The database cursor, transform, and HTTP response are all destroyed together on error
  await pipelineAsync(queryStream, csvTransform, res);
}
El heap se mantiene plano sin importar el tamaño del conjunto de resultados. Si el cliente se desconecta a mitad de la descarga, el error se propaga de vuelta a través de pipeline y el cursor de base de datos se libera de inmediato.
Cuándo no usar streaming
El streaming añade complejidad real. No toda respuesta grande lo necesita.
| Escenario | Enfoque | Motivo |
|---|---|---|
| < 10k filas, API interna | Cargar en memoria | Más simple, impacto de heap insignificante |
| Endpoint de UI paginado | Paginación por cursor | El cliente necesita acceso aleatorio por página |
| Exportación grande (CSV, NDJSON) | Streaming | Memoria constante, sin timeout de respuesta |
| ETL, millones de filas | Streaming + escrituras por lotes | Importan tanto el throughput como la memoria |
| Feed de panel en tiempo real | SSE o WebSocket | Un problema completamente distinto |
La heurística: usa streaming cuando no puedas acotar de antemano el tamaño del conjunto de resultados, o cuando el cliente deba empezar a consumir antes de que el productor termine. Recurre al streaming después de que el profiling confirme que hace falta, no por defecto.
Conclusiones clave
stream.pipelineen lugar de.pipe()— propagación de errores correcta y limpieza de streams, siempre.- El backpressure no es opcional — comprueba el valor booleano que devuelve
writable.write()y pausa la fuente cuando seafalse. - Los generadores asíncronos se combinan de forma natural —
for await...ofhace que el backpressure sea ergonómico cuando esperas (await) las escrituras dentro del bucle. - Destruye las fuentes en caso de error — los cursores de base de datos y los descriptores de archivo se filtran en silencio cuando se abandonan los readables; tanto
pipelinecomotry/finallyprotegen contra esto. - Mide antes de aplicar streaming — añadir un pipeline a una consulta de 200 filas suma complejidad sin ninguna ganancia; el momento adecuado para recurrir a los streams es cuando el tamaño del conjunto de resultados no tiene límite o las exportaciones grandes son un requisito real.