Asynchrone Nebenläufigkeit in Node.js: Semaphore und Backpressure
Ein unbegrenztes Promise.all ist ein stiller OOM-Killer — so baust du Semaphore, gedrosselte Queues und Stream-Backpressure in deine Node.js-Anwendungen ein.

Promise.all(items.map(fn)) ist eine der gefährlichsten Zeilen in einer Node.js-Codebasis. Sie sieht vernünftig aus — alles parallel verarbeiten und das Ergebnis abwarten. Was sie tatsächlich tut: Sie feuert jedes Promise gleichzeitig ab, ohne Rücksicht auf Speicher, Rate-Limits nachgelagerter APIs oder Datenbank-Verbindungspools. Bei 50 Elementen ist das okay. Bei 50.000 ist es ein Incident.
Nebenläufigkeit zu steuern ist in produktiven Node.js-Services ein erstklassiges Thema, kein nachträglicher Gedanke. Die Patterns sind einfach zu implementieren, und der Nutzen ist enorm.
Das Problem mit unbegrenztem Parallelismus
Die meisten Codebasen beginnen mit Promise.all, weil es in der Entwicklung funktioniert. In der Produktion zeigt sich der Fehler.
// ❌ Fires all 10,000 requests simultaneously
async function syncAllUsers(userIds: string[]): Promise<void> {
  await Promise.all(userIds.map((id) => fetchAndSync(id)));
}

// ✅ Processes 20 at a time — predictable memory, no rate-limit bans
async function syncAllUsers(userIds: string[]): Promise<void> {
  await runWithConcurrency(userIds, fetchAndSync, { limit: 20 });
}
Die Lösung ist nicht kompliziert, braucht aber ein Concurrency-Primitiv. Bauen wir eins.
Ein Semaphor entsteht
Ein Semaphor ist ein Zähler mit einem Maximum. Wenn der Zähler voll ist, warten neue Tasks, bis ein Platz frei wird. Das ist die Grundlage, auf der alles andere aufbaut.
export class Semaphore {
  private queue: Array<() => void> = [];
  private active = 0;

  constructor(private readonly limit: number) {}

  async acquire(): Promise<void> {
    if (this.active < this.limit) {
      this.active++;
      return;
    }

    await new Promise<void>((resolve) => {
      this.queue.push(resolve);
    });
    this.active++;
  }

  release(): void {
    this.active--;
    const next = this.queue.shift();
    if (next) next();
  }

  async run<T>(fn: () => Promise<T>): Promise<T> {
    await this.acquire();
    try {
      return await fn();
    } finally {
      this.release();
    }
  }
}
Das Semaphor ist über die gesamte Lebensdauer eines Services wiederverwendbar. Deklariere es einmal auf Modulebene und teile es mit allen Aufrufern, die sich dieselbe Ressource teilen — einen Datenbankpool, eine externe API, einen Dateisystem-Mount.
// Shared across the entire service — caps total in-flight Stripe calls
const stripeSemaphore = new Semaphore(5);

async function chargeCustomer(customerId: string, amount: number) {
  return stripeSemaphore.run(() =>
    stripe.charges.create({ amount, customer: customerId, currency: "usd" })
  );
}
Gedrosselte Batch-Verarbeitung
Das Semaphor regelt die momentane Nebenläufigkeit, aber bei großen Arrays willst du außerdem vermeiden, Tausende Promises gleichzeitig in die Queue zu stellen. Ein runWithConcurrency-Helper verarbeitet die Elemente in kontrollierten Wellen.
async function runWithConcurrency<T, R>(
  items: T[],
  fn: (item: T) => Promise<R>,
  options: { limit: number }
): Promise<R[]> {
  const semaphore = new Semaphore(options.limit);
  return Promise.all(items.map((item) => semaphore.run(() => fn(item))));
}
Das erzeugt immer noch ein Promise pro Element — bei extrem großen Arrays (Millionen von Datensätzen) kann allein dieser Heap-Druck ein Problem sein. Greife in diesen Fällen stattdessen zu einem Chunk-Iterator.
async function* chunks<T>(items: T[], size: number): AsyncGenerator<T[]> {
  for (let i = 0; i < items.length; i += size) {
    yield items.slice(i, i + size);
  }
}

async function processInBatches<T>(
  items: T[],
  fn: (item: T) => Promise<void>,
  batchSize = 100
): Promise<void> {
  for await (const batch of chunks(items, batchSize)) {
    await Promise.all(batch.map(fn));
    // Optional: yield to the event loop between batches
    await new Promise((r) => setImmediate(r));
  }
}
Das setImmediate-Yield lässt I/O-Callbacks (Health Checks, eingehende Requests) zwischen den Batches laufen. Ohne es blockiert eine lange Verarbeitungsschleife den Event Loop, obwohl jede einzelne Task asynchron ist.
Bevorzuge setImmediate gegenüber setTimeout(r, 0) zwischen Batches. setImmediate feuert nach den I/O-Callbacks in der aktuellen Event-Loop-Iteration, während setTimeout mit Delay 0 in Node.js tatsächlich ~1ms Jitter hat.
Backpressure mit Node.js-Streams
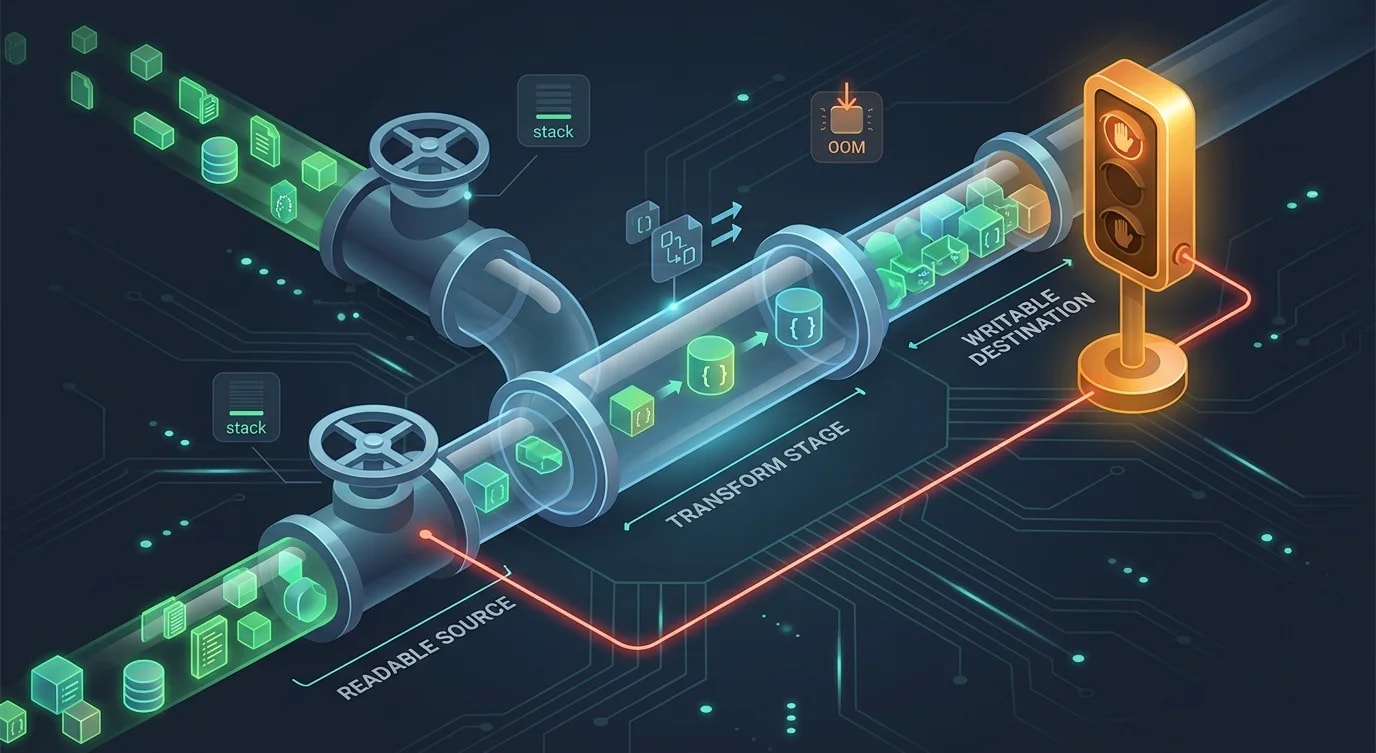
Wenn die Datenmengen zu groß sind, um sie überhaupt im Speicher zu halten — denk an ETL-Jobs, CSV-Exporte, Log-Verarbeitung — sind Streams mit eingebautem Backpressure das richtige Werkzeug. Entscheidend ist, das highWaterMark zu respektieren und es nicht mit unbegrenzten asynchronen Operationen außer Kraft zu setzen.
import { Transform, TransformCallback } from "node:stream";

class ConcurrentTransform extends Transform {
  private semaphore: Semaphore;
  private pending = 0;
  private drainCallback: (() => void) | null = null;

  constructor(
    private readonly fn: (chunk: unknown) => Promise<unknown>,
    concurrency: number
  ) {
    super({ objectMode: true, highWaterMark: concurrency * 2 });
    this.semaphore = new Semaphore(concurrency);
  }

  _transform(chunk: unknown, _enc: string, callback: TransformCallback): void {
    this.pending++;
    this.semaphore
      .run(() => this.fn(chunk))
      .then((result) => {
        this.push(result);
        this.pending--;
        if (this.pending === 0 && this.drainCallback) {
          this.drainCallback();
          this.drainCallback = null;
        }
      })
      .catch((err) => this.destroy(err));

    // Signal readiness for the next chunk immediately
    // so the readable side doesn't stall waiting for us
    callback();
  }

  _flush(callback: TransformCallback): void {
    if (this.pending === 0) return callback();
    this.drainCallback = callback;
  }
}
Die entscheidende Erkenntnis: Rufe callback() in _transform sofort auf, damit der Stream weiterfließt, nutze aber das Semaphor, um die tatsächlich laufende Arbeit zu begrenzen. Das highWaterMark des Streams fügt einen Puffer hinzu — setze es auf concurrency * 2, damit die lesbare Seite immer Arbeit in der Queue hat.
Das richtige Concurrency-Limit wählen
Es gibt keine universelle Zahl. Stimme den Wert auf das ab, was du schützt.
| Ressource | Empfohlenes Start-Limit | Warum |
|---|---|---|
| Externe HTTP-API (ohne SLA) | 5–10 | 429er vermeiden; die meisten Free-Tier-Limits gelten pro Sekunde |
| Externe HTTP-API (mit SLA) | An deren Rate-Limit anpassen | Lies die Doku — Stripe und Twilio veröffentlichen exakte Limits |
| PostgreSQL-Verbindungspool | pool.max - 2 | Reserve für Health Checks und Admin-Queries lassen |
| Redis | 50–100 | Redis ist schnell; der Engpass ist meist das Netzwerk, nicht die DB |
| CPU-gebundene Arbeit (Worker-Thread) | os.cpus().length - 1 | Einer pro Kern minus einer für den Hauptthread |
| Dateisystem-Schreibzugriffe | 10–20 | Hängt vom Datenträger ab — SSD schafft mehr, eine rotierende Platte deutlich weniger |
Fang konservativ an, teste unter realistischen Lastbedingungen und erhöhe dann das Limit. Ein Semaphor-Limit zu erhöhen ist deutlich einfacher, als sich von einem kaskadierenden Datenbankausfall zu erholen.
Queue-Stau unter Dauerlast verhindern
Die Queue eines Semaphors ist standardmäßig unbegrenzt. Unter Dauerlast wächst sie ohne Limit — du hast das Speicherproblem nur vom Heap ins Semaphor verlagert. Füge einen Circuit Breaker hinzu oder wirf Last ab, wenn die Queue einen Schwellenwert überschreitet.
export class BoundedSemaphore extends Semaphore {
  constructor(
    limit: number,
    private readonly maxQueue: number
  ) {
    super(limit);
  }

  async acquire(): Promise<void> {
    // queue is private in parent — expose via a getter in real code
    if (this.queue.length >= this.maxQueue) {
      throw new Error("Semaphore queue full — shedding load");
    }
    return super.acquire();
  }
}
Im Kontext eines HTTP-Servers fängst du diesen Fehler im Route-Handler ab und gibst 503 Service Unavailable zurück. Das ist Load Shedding — eine bewusste Degradierung, die den Service vor dem totalen Zusammenbruch schützt.
export async function POST(req: Request) {
  try {
    const result = await processingQueue.run(() => handleRequest(req));
    return Response.json(result);
  } catch (err) {
    if (err instanceof Error && err.message.includes("queue full")) {
      return new Response("Service overloaded", { status: 503 });
    }
    throw err;
  }
}
Die wichtigsten Erkenntnisse
Promise.allauf großen Arrays ist unsicher — es erzeugt unbegrenzten Parallelismus und führt in der Produktion zu OOM oder ausgelösten Rate-Limits.- Ein Semaphor ist das richtige Primitiv — es sind 30 Zeilen Code, ohne Abhängigkeiten, und es kombiniert sich sauber mit async/await.
- Teile Semaphore an der Ressourcengrenze — ein Semaphor pro Datenbankpool, pro externer API, pro Disk-Mount. Erstelle sie nicht pro Request.
- Kombiniere bei sehr großen Datensätzen Batching mit einem Semaphor — Chunk-Iteratoren verhindern Heap-Druck durch ausstehende Promises; das Semaphor begrenzt die laufende Arbeit.
- Node.js-Streams brauchen expliziten Backpressure — rufe
callback()von_transformsofort auf, aber klemme die eigentliche Arbeit hinter ein Semaphor; stimme dashighWaterMarkso ab, dass es puffert, ohne zu fluten. - Füge eine Queue-Grenze hinzu und wirf Last ab — eine unbegrenzte Queue ist ein OOM auf Ratenzahlung. Lehne früh mit
503ab, wenn die Queue voll ist.