Request Coalescing: den Thundering Herd verhindern
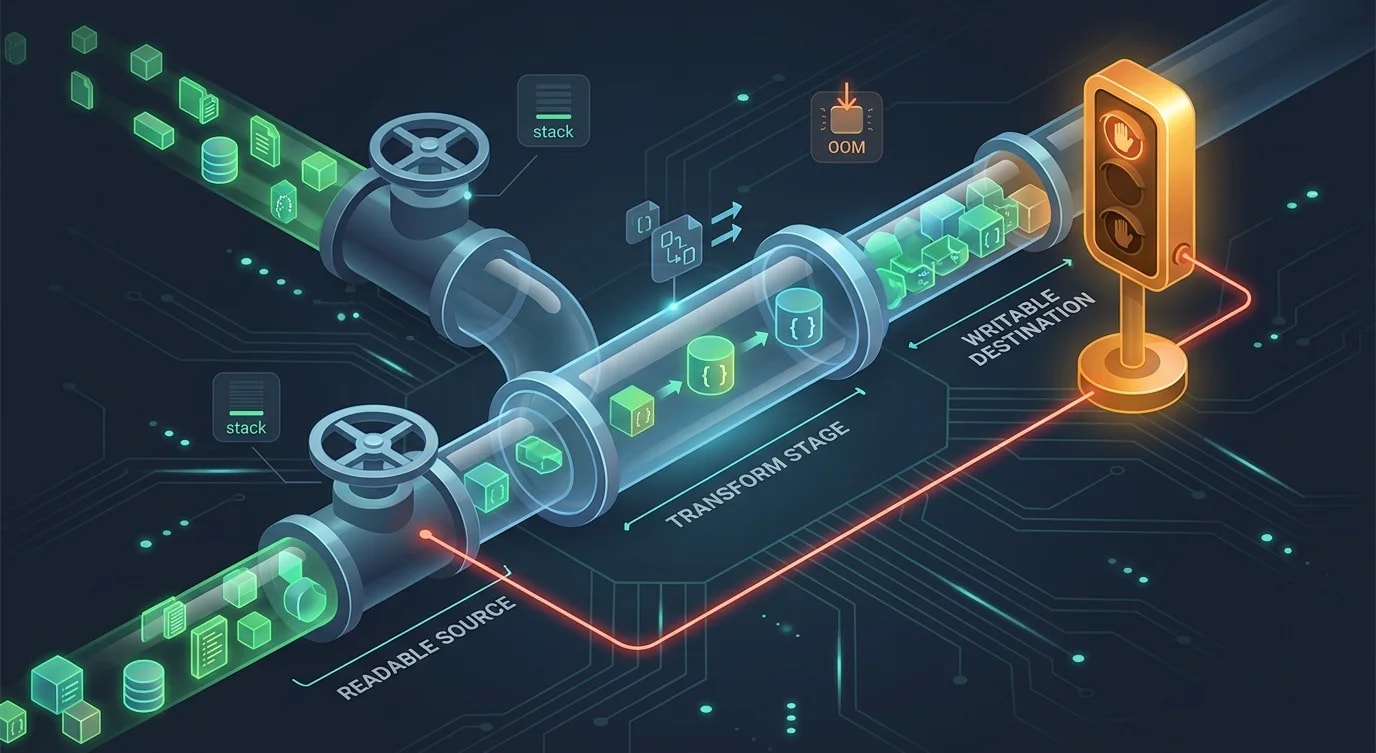
Läuft ein Cache-Eintrag unter Last ab, wetteifern Dutzende Anfragen um den Neuaufbau — Deduplizierung macht daraus einen einzigen Backend-Aufruf.

Wenn ein zwischengespeicherter Wert bei hoher Last abläuft, laufen alle Anfragen, die in den nächsten Millisekunden eintreffen, gleichzeitig am Cache vorbei. Jede einzelne löst dieselbe Datenbankabfrage aus, denselben externen API-Aufruf, dieselbe teure Berechnung – und alle liefern dasselbe Ergebnis. Das ist das Thundering-Herd-Problem, und es lässt sich trügerisch leicht übersehen, bis der Traffic hoch genug ist, damit es wirklich zählt.
Die Lösung ist kein verteilter Lock und keine Sleep-and-Retry-Schleife. Es ist Inflight Request Coalescing: gleichzeitige, bereits laufende Anfragen für dieselbe Ressource deduplizieren, sodass nur ein einziger Aufruf an das Backend läuft und jeder wartende Aufrufer sich den aufgelösten Wert teilt.
Warum die naheliegenden Lösungen nicht funktionieren
Der häufigste erste Versuch ist ein Mutex oder ein Redis-Lock. Lock holen, Cache befüllen, freigeben. Jede andere Anfrage wartet oder bekommt veraltete Daten zurück. Das funktioniert, bringt aber verteilten Zustand, Lock-Timeouts und einen zusätzlichen Fehlerfall mit sich: Was passiert, wenn der Lock-Halter mitten in der Befüllung abstürzt?
Der nächste Versuch lautet meist: „die TTL einfach verlängern". Aber TTL-Tuning ist reine Vermutung und tauscht Aktualität gegen die Vermeidung eines Ansturms, statt die eigentliche Ursache zu beheben. Spätestens beim Deploy einer kalten Instanz oder beim expliziten Leeren des Caches läuft man wieder dagegen.
Das eigentliche Problem ist einfacher: Mehrere Aufrufer erledigen gleichzeitig identische Arbeit, obwohl einer reichen würde. Genau das gilt es zu beheben.
Inflight Request Coalescing mit einer Promise Map
Der Single-Threaded Event Loop von Node.js macht dieses Muster ungewöhnlich sauber. Eine Map vom Ressourcenschlüssel zur laufenden Promise ist alles, was man braucht. Jeder Aufrufer, der eintrifft, während ein Abruf bereits läuft, bekommt dieselbe Promise. Alle lösen sich gemeinsam auf, sobald der Aufruf an das Backend abgeschlossen ist.
// ❌ Every concurrent caller fires its own query
async function getUser(id: string): Promise<User> {
  const cached = await cache.get(`user:${id}`);
  if (cached) return cached;

  const user = await db.query("SELECT * FROM users WHERE id = $1", [id]);
  await cache.set(`user:${id}`, user, 60);
  return user;
}

// ✅ Concurrent callers share one in-flight request
const inflight = new Map<string, Promise<User>>();

async function getUser(id: string): Promise<User> {
  const cached = await cache.get(`user:${id}`);
  if (cached) return cached;

  const key = `user:${id}`;
  if (inflight.has(key)) return inflight.get(key)!;

  const promise = db
    .query("SELECT * FROM users WHERE id = $1", [id])
    .then(async (user) => {
      await cache.set(key, user, 60);
      return user;
    })
    .finally(() => inflight.delete(key));

  inflight.set(key, promise);
  return promise;
}
Der finally-Block ist entscheidend. Er entfernt den laufenden Eintrag, egal ob der Aufruf an das Backend erfolgreich ist oder fehlschlägt. Wird nur bei Erfolg gelöscht, blockiert ein vorübergehender Fehler alle künftigen Aufrufer für diesen Schlüssel dauerhaft.
Einen wiederverwendbaren Coalescer bauen
Das Map + finally-Muster inline in jeder datenabrufenden Funktion zu wiederholen, ist unübersichtlich. Extrahiere es in eine Utility-Funktion, die jede beliebige asynchrone Funktion umschließt:
type Fetcher<T> = () => Promise<T>;

class RequestCoalescer {
  private readonly inflight = new Map<string, Promise<unknown>>();

  async dedupe<T>(key: string, fetcher: Fetcher<T>): Promise<T> {
    if (this.inflight.has(key)) {
      return this.inflight.get(key) as Promise<T>;
    }

    const promise = fetcher().finally(() => this.inflight.delete(key));
    this.inflight.set(key, promise);
    return promise;
  }

  get size(): number {
    return this.inflight.size;
  }
}

// Usage
const coalescer = new RequestCoalescer();

async function getProduct(id: string): Promise<Product> {
  const cached = await cache.get(`product:${id}`);
  if (cached) return cached;

  return coalescer.dedupe(`product:${id}`, async () => {
    const product = await db.query(
      "SELECT * FROM products WHERE id = $1",
      [id],
    );
    await cache.set(`product:${id}`, product, 120);
    return product;
  });
}
Der Coalescer ist zustandsbehaftet, deshalb sollte man ihn injizieren, statt ihn in jeder Funktion neu zu instanziieren. Eine einzige Instanz pro Service ist der übliche Ansatz.
Fehler behandeln, ohne die Aufrufer zu vergiften
Naive Implementierungen haben einen subtilen Bug: Wirft der Aufruf an das Backend einen Fehler, erhalten alle zusammengeführten Aufrufer dieselbe Ablehnung. Das ist meist unproblematisch – sie bekommen alle eine korrekte Fehlermeldung. Speichert man aber die abgelehnte Promise selbst im Cache, erhalten künftige Aufrufer, die nach dem Fehlschlag eintreffen, weiterhin eine abgelehnte Promise, obwohl gar kein Aufruf mehr läuft.
Der finally-Block im obigen Beispiel behandelt das korrekt: Der laufende Eintrag wird beim Abschluss immer gelöscht, unabhängig vom Ergebnis. Künftige Aufrufer starten sauber neu.
Cache Promise.reject(...) nicht in der Inflight-Map. Cache nur Promises, die
aktiv laufen. Das finally-Cleanup stellt sicher, dass diese Invariante
eingehalten wird.
Was man bewusst cachen könnte, ist ein kurzlebiges negatives Ergebnis, um eine Ressource nicht zu bombardieren, die konsequent fehlschlägt. Das ist ein eigenes Thema (Circuit Breaking), und es mit Coalescing zu vermischen, macht die Implementierung unübersichtlich.
Die Inflight-Map begrenzen
Im Normalbetrieb bleibt die Map winzig – ein Eintrag pro unterschiedlichem Ressourcenschlüssel, der gerade abgerufen wird. Ist aber ein pathologischer Schlüsselraum denkbar (von Angreifern kontrollierte IDs, unbegrenzte Pagination-Cursor), lohnt sich eine Größenbegrenzung:
class RequestCoalescer {
  private readonly inflight = new Map<string, Promise<unknown>>();
  private readonly maxSize: number;

  constructor(maxSize = 1000) {
    this.maxSize = maxSize;
  }

  async dedupe<T>(key: string, fetcher: Fetcher<T>): Promise<T> {
    if (this.inflight.has(key)) {
      return this.inflight.get(key) as Promise<T>;
    }

    if (this.inflight.size >= this.maxSize) {
      // Fall through: let this caller fetch independently
      return fetcher();
    }

    const promise = fetcher().finally(() => this.inflight.delete(key));
    this.inflight.set(key, promise);
    return promise;
  }
}
Wird das Limit überschritten, fällt man auf Verhalten ohne Coalescing zurück, statt die Anfrage abzulehnen. Der Thundering-Herd-Schutz degradiert sanft, statt hart zu scheitern.
Wo dieses Muster passt
Request Coalescing ist überall dort nützlich, wo Arbeit teuer und idempotent ist. Der klassische Anwendungsfall ist das Befüllen eines Caches, aber dasselbe Muster passt auch auf:
| Szenario | Schlüsseldesign |
|---|---|
| Cache-Ansturm beim Ablauf | resource:id |
| Parallele API-Aufrufe für dieselbe Backend-Ressource | endpoint:params-hash |
| Bedarfsgesteuerte Thumbnail-/Asset-Generierung | asset:id:size |
| Session-Hydration aus einem externen Store | session:token |
| Feature-Flag-Auswertungen gegen einen externen Konfigurationsdienst | flags:context-hash |
Die Voraussetzung ist, dass sich die Operation gefahrlos teilen lässt: gleiche Eingaben, gleiche Ausgabe, keine Seiteneffekte, die pro Aufrufer laufen müssten.
Die wichtigsten Erkenntnisse
- Thundering Herd ist ein Concurrency-Bug, kein Cache-Bug. TTL-Tuning verzögert das Problem nur; Coalescing beseitigt es.
- Eine
Map<string, Promise<T>>ist die gesamte Implementierung. Keine externen Abhängigkeiten, kein verteilter Zustand, keine Lock-Timeouts. - Immer mit
finallyaufräumen. Den laufenden Eintrag nur bei Erfolg zu löschen, hinterlässt nach jedem Fehlschlag eine dauerhafte Giftpille für künftige Aufrufer. - Den Coalescer als injizierbares Singleton führen. Instanziierung pro Funktion bedeutet keine Deduplizierung zwischen gleichzeitigen Aufrufern an verschiedenen Aufrufstellen.
- Bei voller Map sauber zurückfallen. Auf Verhalten ohne Coalescing herabstufen, statt Anfragen komplett abzulehnen.
- Die Größe der Inflight-Map überwachen. Eine dauerhaft große Map deutet entweder auf eine langsame Backend-Abhängigkeit oder ein Problem im Schlüsselraum hin, das eine Untersuchung wert ist.