Architektur
GraphQL Federation: Schemas aufteilen, ohne Teams zu spalten
Ein praktischer Leitfaden zu GraphQL Federation: ein monolithisches Schema auf Services aufteilen, ohne Resolver oder Gateway-Logik zu duplizieren.
·4 Min. Lesezeit
Tags
33 Artikel · Seite 1 von 3
Ein praktischer Leitfaden zu GraphQL Federation: ein monolithisches Schema auf Services aufteilen, ohne Resolver oder Gateway-Logik zu duplizieren.
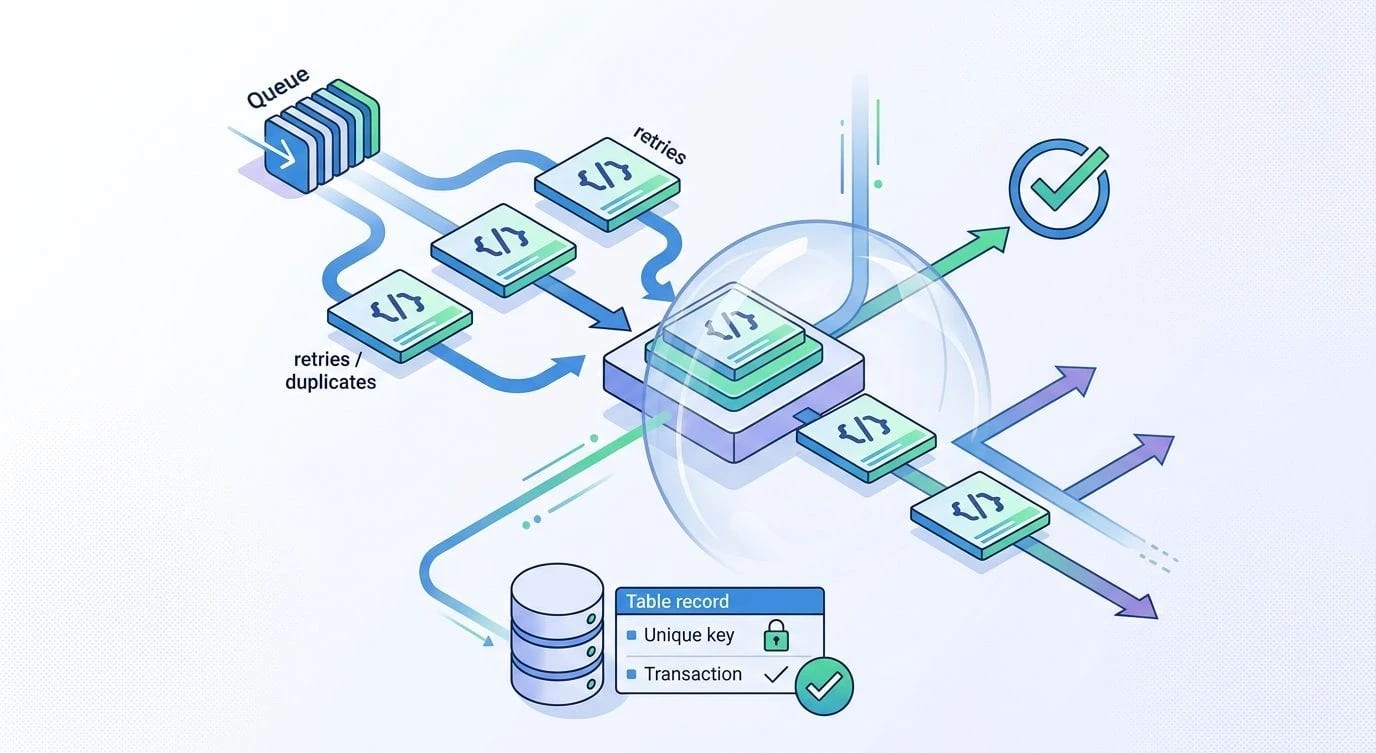
Exactly-Once gibt es in verteilten Systemen nicht – so entwirfst du Background-Jobs, die Retries, Abstürze und doppelte Zustellungen überstehen.
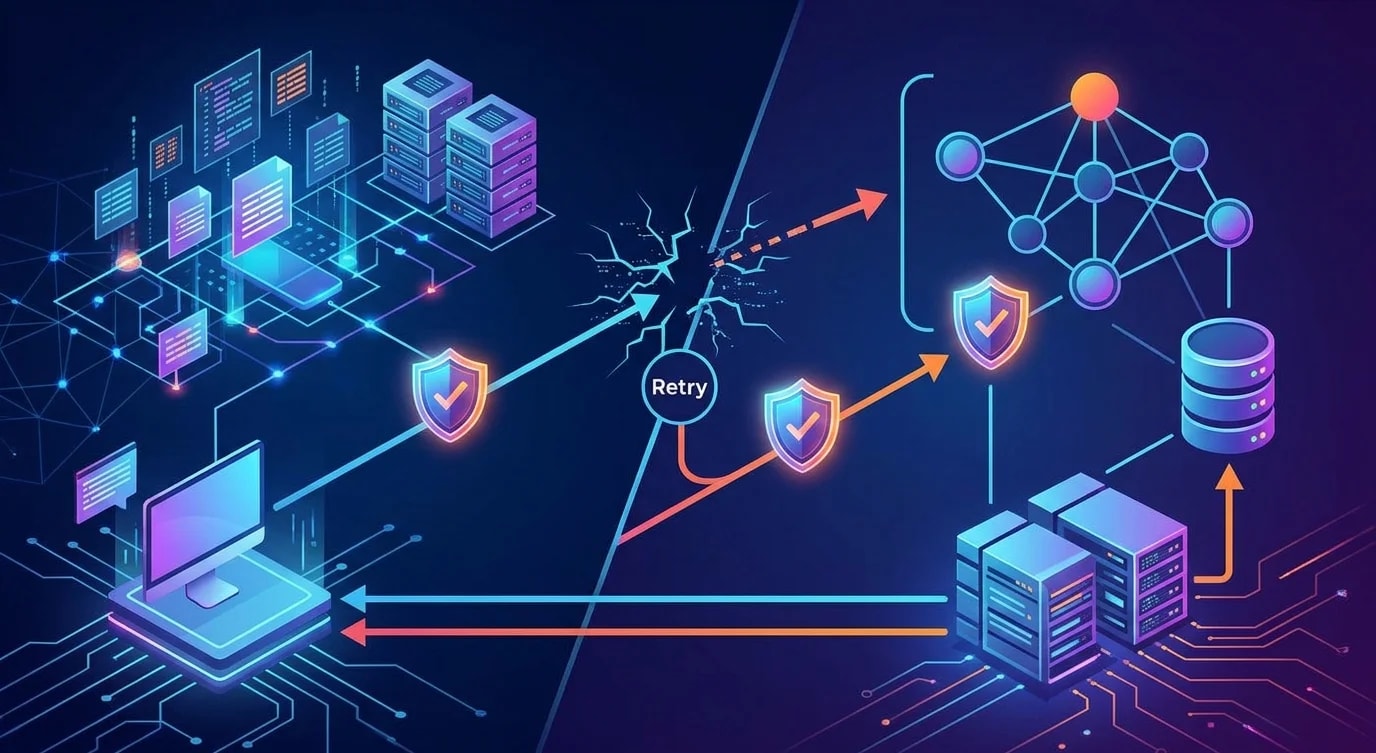
Wie man Idempotenzschlüssel entwirft und implementiert, damit wiederholte Anfragen nie doppelt abrechnen, doppelt senden oder doppelt Ressourcen anlegen.

Multi-Region-Failover wirkt im Diagramm simpel — in der Praxis warten Replikationsverzögerung, Split-Brain-Schreibzugriffe und DNS-Caches.

Wie man in asynchronen Systemen Felder hinzufügt, Eigenschaften umbenennt und Events umstrukturiert, ohne Deployments abzustimmen oder Consumer zu brechen.

Vermeide Race Conditions in verteilten Systemen: ein Leitfaden zu verteilten Locks mit Redis und PostgreSQL-Advisory-Locks in Node.js.
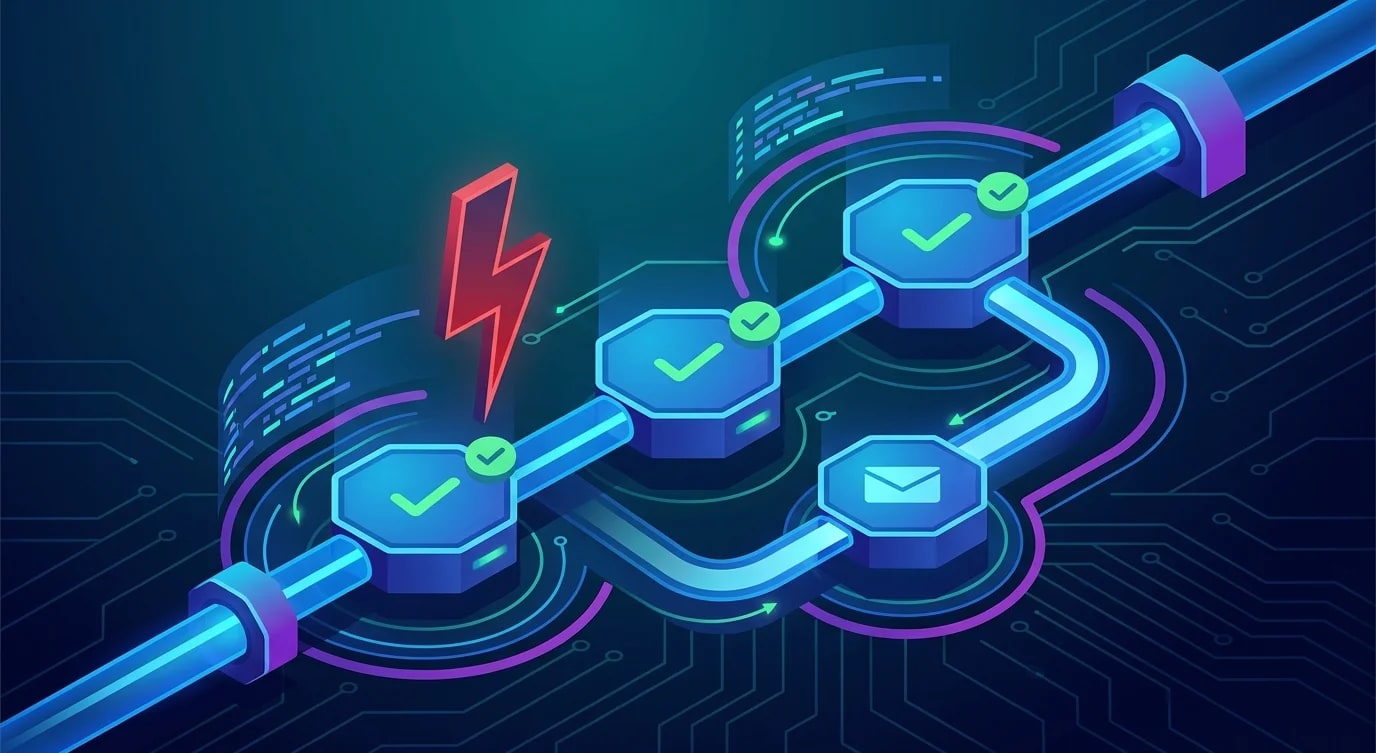
Warum Job-Queues und Datenbank-Zustandsmaschinen bei mehrstufigen Prozessen scheitern und wie Durable Execution mit Temporal Abstürze übersteht.

Wie das Transactional-Outbox-Pattern das Dual-Write-Problem löst und zuverlässiges Event-Publishing garantiert, ohne DB und Broker zu koppeln.

Praktische Lektionen aus Entwurf und Betrieb von Microservices im großen Maßstab: Event-Kommunikation, Servicegrenzen und bewährte Muster.
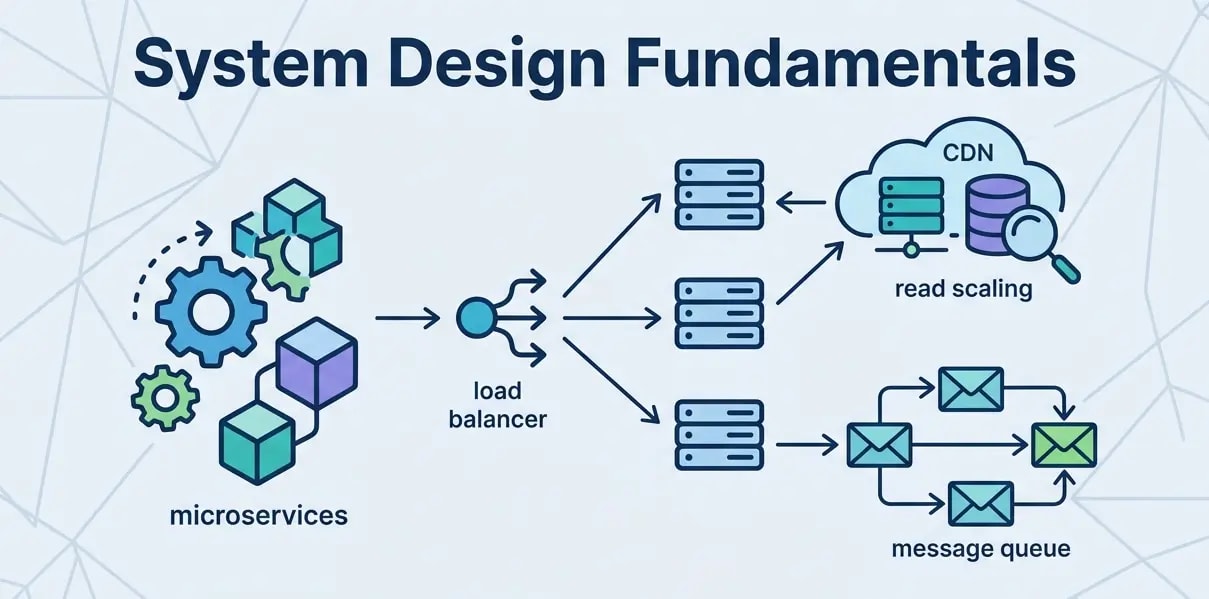
Die zentralen Konzepte skalierbaren Systemdesigns: Lastverteilung, Caching, Datenbankskalierung, Queues und die Abwägungen hinter Architektur.
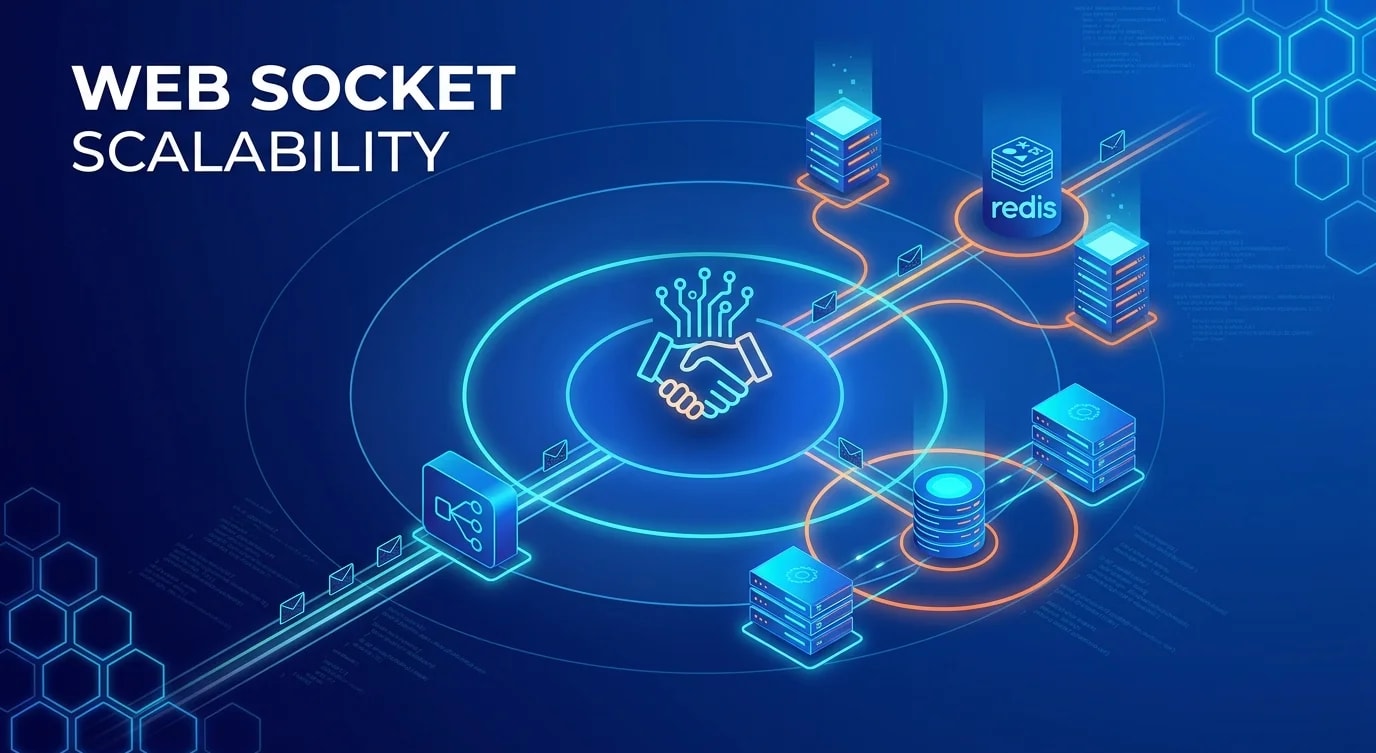
Skalierbare WebSocket-Architekturen entwerfen: Verbindungsverwaltung, raumbasiertes Pub/Sub, Heartbeats, Reconnect und horizontale Skalierung.

Retry-Policies gegen transiente Fehler, ohne Downstream-Services zu überlasten: exponentielles Backoff, Jitter, Circuit Breaker und Retry-Budgets.