Grundlagen des Systemdesigns, die jeder Entwickler kennen sollte
Die zentralen Konzepte skalierbaren Systemdesigns: Lastverteilung, Caching, Datenbankskalierung, Queues und die Abwägungen hinter Architektur.
Warum jeder Entwickler Systemdesign verstehen sollte
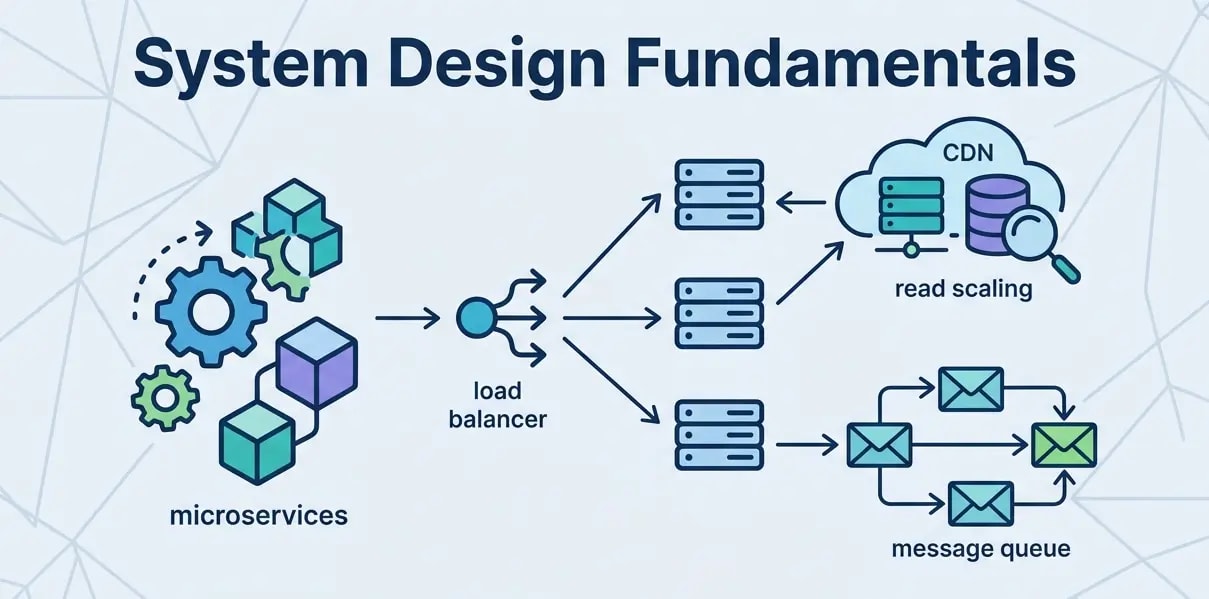
Man muss kein Architekt sein, um von Systemdesign-Denken zu profitieren. Wer versteht, wie die Teile zusammenspielen, wird auf jeder Ebene zu einem besseren Entwickler — es verändert, wie man Code schreibt, wie man Probleme in der Produktion debuggt und wie man Kompromisse bei alltäglichen Entscheidungen abwägt.
Konzept 1: Horizontale vs. vertikale Skalierung
Vertikale Skalierung — die Maschine größer machen (mehr CPU, mehr RAM). Einfach, aber mit einer Obergrenze und einem Single Point of Failure.
Horizontale Skalierung — weitere Maschinen hinzufügen. Erfordert eine zustandslose Anwendung.
Vertical:        Horizontal:
    [Big Server]     [Server] [Server] [Server]
         |               |       |       |
      [DB]           [Load Balancer]
                           |
                         [DB]
Die zentrale Erkenntnis: Zustandslose Anwendungen (bei denen keine Benutzerdaten im Speicher der Anwendung liegen) lassen sich horizontal skalieren. Speichert dein Server Sitzungsdaten im Arbeitsspeicher, kannst du denselben Benutzer nicht auf unterschiedliche Server verteilen.
Lösung: den Zustand auslagern.
// ❌ In-memory session — breaks horizontal scaling
const sessions = new Map<string, Session>();
app.use((req, res, next) => {
  req.session = sessions.get(req.cookies.sessionId);
  next();
});

// ✅ Externalized session — any server can serve any user
import { createClient } from "redis";
const redis = createClient({ url: process.env.REDIS_URL });

app.use(
  session({
    store: new RedisStore({ client: redis }),
    secret: process.env.SESSION_SECRET,
  }),
);
Konzept 2: Caching-Ebenen
Caching ist die wirkungsvollste Performance-Optimierung auf Systemebene. Es gibt vier Stellen, an denen sich cachen lässt:
Browser Cache → CDN → Application Cache (Redis) → Database Query Cache
     ↑              ↑              ↑                        ↑
  Static assets  Static + API   Computed results      Query results
  ms access      ~10ms           ~1ms                  ~5ms
Der schwierige Teil ist nicht die Implementierung eines Caches, sondern seine Invalidierung.
// Cache-aside pattern — the most common approach
async function getProduct(id: string): Promise<Product> {
  const cacheKey = `product:${id}`;

  // 1. Try cache
  const cached = await redis.get(cacheKey);
  if (cached) return JSON.parse(cached);

  // 2. Cache miss — fetch from database
  const product = await db.product.findUnique({ where: { id } });
  if (!product) throw new NotFoundError();

  // 3. Populate cache with TTL
  await redis.setEx(cacheKey, 3600, JSON.stringify(product)); // 1 hour TTL

  return product;
}

// Invalidate on mutation
async function updateProduct(id: string, data: Partial<Product>) {
  const product = await db.product.update({ where: { id }, data });
  await redis.del(`product:${id}`); // Invalidate cache entry
  return product;
}Cache-Stampede: Wenn der Cache abläuft, schlagen alle Anfragen gleichzeitig fehl und treffen die Datenbank ungebremst. Abhilfe schaffen probabilistisch vorgezogenes Ablaufen oder verteilte Sperren (distributed locks).
Konzept 3: Message Queues
Warteschlangen entkoppeln Produzenten von Konsumenten und ermöglichen:
- Asynchrone Verarbeitung — sofort antworten und im Hintergrund verarbeiten
- Lastglättung — Traffic-Spitzen abfedern, ohne nachgelagerte Dienste zu überlasten
- Wiederholungslogik — fehlgeschlagene Jobs lassen sich automatisch erneut ausführen
// Without a queue — user waits for email to send
app.post("/api/register", async (req, res) => {
  const user = await createUser(req.body);
  await sendWelcomeEmail(user.email); // Slow — blocks response
  res.json({ user });
});

// With a queue — response is immediate, email is async
app.post("/api/register", async (req, res) => {
  const user = await createUser(req.body);
  await queue.add("send-welcome-email", { userId: user.id }); // Fast — non-blocking
  res.json({ user });
});

// Worker processes jobs independently
queue.process("send-welcome-email", async (job) => {
  const user = await db.user.findUnique({ where: { id: job.data.userId } });
  await emailService.sendWelcome(user);
});
Konzept 4: Datenbankskalierung
Wenn eine einzelne Datenbank die Last nicht mehr bewältigt:
Lese-Replikate — Schreibvorgänge werden auf schreibgeschützte Replikate repliziert. Leselastige Abfragen werden an die Replikate geleitet.
// Primary for writes, replica for reads
const writeDb = new PrismaClient({ datasources: { db: { url: PRIMARY_URL } } });
const readDb = new PrismaClient({ datasources: { db: { url: REPLICA_URL } } });

async function getUserDashboard(userId: string) {
  // Read from replica — ok if slightly stale
  return readDb.user.findUnique({
    where: { id: userId },
    include: { recentOrders: { take: 10 } },
  });
}

async function updateUserProfile(userId: string, data: Partial<User>) {
  // Write to primary — must be consistent
  return writeDb.user.update({ where: { id: userId }, data });
}
Sharding — Daten werden anhand eines Shard-Keys auf mehrere Datenbanken verteilt (z. B. nach Bereichen der Benutzer-ID). Das erhöht die operative Komplexität erheblich — zuerst sollten Lese-Replikate zum Einsatz kommen.
Konzept 5: Das CAP-Theorem in der Praxis
In einem verteilten System kannst du immer nur zwei der drei Eigenschaften garantieren:
- Konsistenz — jede Leseoperation liefert den zuletzt geschriebenen Wert
- Verfügbarkeit — jede Anfrage erhält eine Antwort
- Partitionstoleranz — das System funktioniert trotz Netzwerkausfällen
Netzwerkausfälle passieren. Während einer Partition musst du dich zwischen Konsistenz und Verfügbarkeit entscheiden.
Die meisten Webanwendungen sollten sich für Verfügbarkeit + eventuelle Konsistenz entscheiden:
// Eventual consistency — show cached data, sync in background
async function getInventoryCount(productId: string) {
  // Return cached count — may be slightly stale
  const cached = await redis.get(`inventory:${productId}`);
  if (cached) return parseInt(cached);

  // Fallback to database
  const product = await db.product.findUnique({
    where: { id: productId },
    select: { inventoryCount: true },
  });
  await redis.setEx(
    `inventory:${productId}`,
    30,
    String(product.inventoryCount),
  );
  return product.inventoryCount;
}
Banktransaktionen und medizinische Datensätze benötigen strikte Konsistenz. Der Lagerbestand eines Produkts verträgt dagegen eine Verzögerung von 30 Sekunden.
Das mentale Modell
Beim Systemdesign geht es darum zu verstehen, wo die Engpässe liegen und welche Kompromisse für deinen Anwendungsfall akzeptabel sind.
Fragen, die du dir bei jedem System stellen solltest:
- Wie ist das Verhältnis von Lese- zu Schreibzugriffen?
- Welche Latenz ist akzeptabel?
- Was passiert, wenn eine Komponente ausfällt?
- Wie sieht das Datenzugriffsmuster aus?
- Welche Konsistenzanforderungen gibt es?
Fang einfach an. Füge nur dann Komplexität hinzu, wenn du Beweise dafür hast, dass die einfachere Lösung zum Engpass wird. Vorzeitige Optimierung im Systemdesign — Over-Engineering für eine Skalierung, die du noch gar nicht brauchst — ist genauso gefährlich wie vorzeitige Mikrooptimierungen im Code.